大讲堂

被神化的多头注意力:从Transformer核心到AI算力成本的隐形枷锁
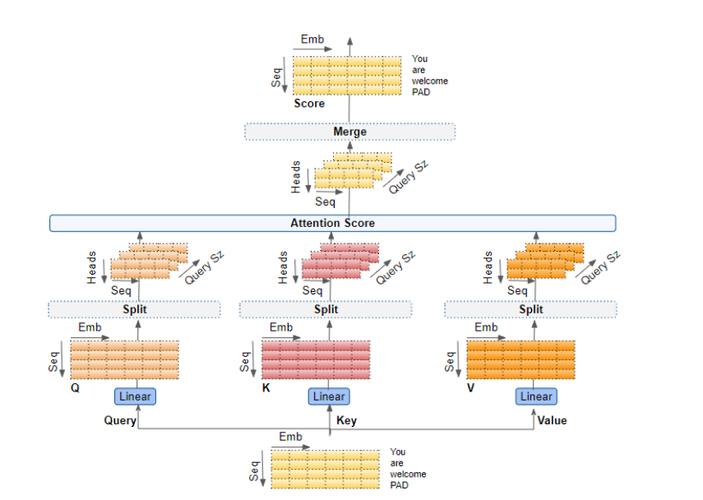
上周跟某头部大模型团队的算法负责人吃饭,他拍着桌子骂,说为了压推理成本,整个组熬了3周把原本的8头注意力砍成2头,用户感知不到任何差异,老板还夸他降本能力强。 被神话的核心:多头注意力到底在做什么 很多人对多头注意力的认知停留在“同时从多个...
上周跟某头部大模型团队的算法负责人吃饭,他拍着桌子骂,说为了压推理成本,整个组熬了3周把原本的8头注意力砍成2头,用户感知不到任何差异,老板还夸他降本能力强。 被神话的核心:多头注意力到底在做什么 很多人对多头注意力的认知停留在“同时从多个...
2026年Q2的大模型圈,出了个特别好笑的事。 那个去年刚拿了2.3亿B轮融资、在发布会上拍着胸脯说自己靠全量自注意力架构实现了1000万token无限上下文理解的多模态创业公司,上线三个月就被用户扒了底裤——他们偷偷把模型里70%的全量自...
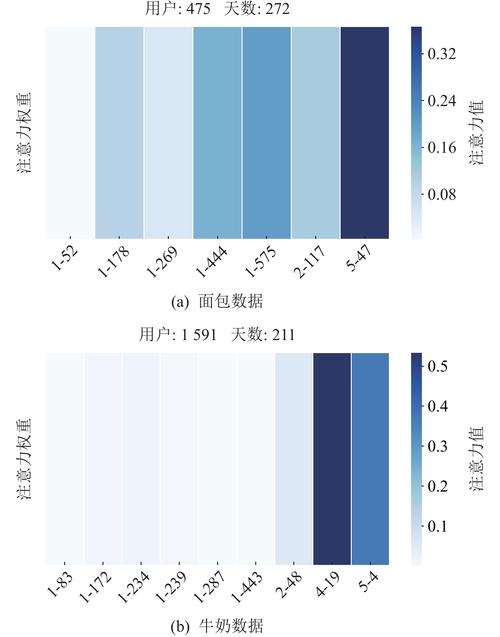
凌晨两点十七分,阿柚的冰美式顺着键盘缝流到屏幕上,刚好蹭花了表格里标红的三行权重值。那是她给外婆搭的专属对话模型,攒了三个月的参数。她盯着那片棕褐色的咖啡渍,骂了句脏话。 凌晨两点的出租屋,咖啡渍蹭在注意力权重表上 出租屋在老小区的顶楼,空...
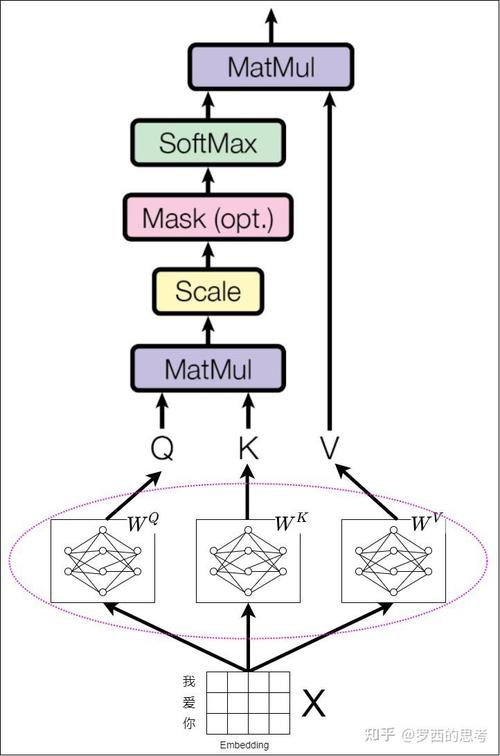
2017年扔在arXiv上的那篇《Attention Is All You Need》,当时没几个人意识到,这堆写着自注意力逻辑的公式,会把全球科技产业的运行节奏掀得底朝天。 真的离谱。 六年后回头看,不管是OpenAI靠GPT系列撬走了硅...
被吹成神话的”训练效率”,本质是成本的无限外溢 我当时就在2026年那场春季发布会的现场。 真的尴尬。 台上的技术负责人拿着激光笔,把PPT翻得哗哗响,反复强调他们把千亿参数模型的训练吞吐率拉到了单集群92%,比行业...