 大讲堂

被吹成神话的”训练效率”,本质是成本的无限外溢
我当时就在2026年那场春季发布会的现场。 真的尴尬。 台上的技术负责人拿着激光笔,把PPT翻得哗哗响,反复强调他们把千亿参数模型的训练吞吐率拉到了单集群92%,比行业平均水平高出整整27个百分点。台下坐的都是天天泡在训练集群里的算法岗老人,谁都听出来这数字的水分——但没人当场拆台,毕竟大家都是在这个圈子里混的,给个面子。 不过话说回来,这数字怎么来的?只要你对训练范式稍微有点概念,就能算明白。他们根本不是做了什么惊为天人的算法优化,是硬堆了128台H200服务器,跑纯纯的纯数据并行的训练范式。说白了,就是把同一份完整的模型参数,复制128份塞到每台服务器的显存里,每一份分片拿1/128的训练数据跑前向传播,算完梯度之后再把所有节点的梯度凑到一起同步更新模型。 我算过一笔账。用纯数据并行跑70B参数模型,当你把并行度从32拉到128的时候,单卡的实际有效算力利用率会从61%掉到23%——这个效率损失,相当于你开着一辆满油的卡车跑高速,每开100公里就倒一半的油在路边,就为了跟同车队的其他127辆车保持车速一致。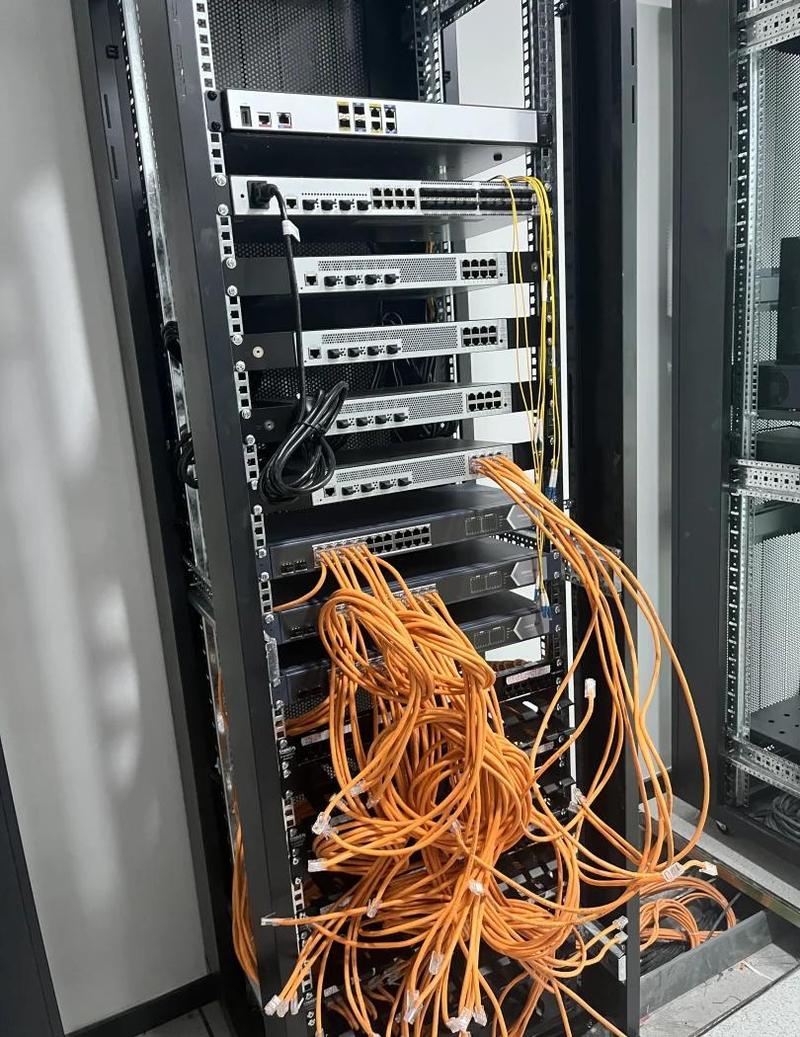
绕开数据并行的,才是真正摸到了成本的命门
去年跟百川智能的训练团队聊到半夜,他们算的一笔账,给我看愣了。 如果把原来的纯数据并行的分片数从256降到64,剩下的算力缺口用张量并行+专家并行补,单集群的年算力成本能直接砍掉42%。这个成本降幅,相当于你原来每年花在公司房租上的钱,现在直接够在杭州未来科技城买一套120平的精装住宅——不是租,是买。 为啥大家放着这么划算的方案不用,非要硬堆数据并行?这里面的博弈关系,说穿了一点都不复杂。 所有卖算力的硬件厂商,都在给客户推销纯数据并行的方案。为啥?因为纯数据并行的方案,对集群的通信带宽要求是指数级上升的——你每多一倍的数据并行度,光模块的采购量就得跟着涨一倍,交换机的端口数也得跟着扩,这些东西谁赚钱?当然是卖光模块、卖交换机、卖整集群的硬件厂商啊。我翻了下中际旭创2026年Q1的财报,他们的800G光模块订单里,有63%是卖给大模型训练集群做梯度同步用的,根本不是什么数据传输的刚需。 这就跟二战时候的装甲集群战术似的——所有人都觉得只要把坦克排成一字长蛇阵往前冲,靠数量优势就能碾过去,但没人算过,坦克集群的后勤补给线拉多长,每公里的油耗是多少,被对方炸断补给线的时候,整个集群就是一堆废铁。现在的纯数据并行训练,就是典型的装甲集群冒进,靠堆数量换进度,根本没算过后勤(算力、带宽、电费)的成本账。
被数据并行卷到的普通人,根本不是算法工程师
很多人觉得,数据并行是算法岗、系统架构师才需要操心的事,跟普通人没关系。 大错特错。 我认识一个在苏州做算力运维的小伙子,去年一年在机房里待的时间比在家的时间多。他说只要跑纯数据并行的训练任务,他就得24小时守在监控屏幕前面,生怕哪个节点的光模块出问题,梯度同步断了,整个集群的训练进度回滚——一次回滚就是几十万的成本。去年体检的时候,他的腰椎间盘突出已经到了要戴护腰上班的程度,他说他现在最大的愿望就是行业里别再硬堆数据并行了,他的腰真的扛不住。 再往产业链上游看,那些做光模块的厂商,现在所有的研发资源都往800G、1.6T的光模块上投,根本没人管工业场景、城域网场景需要的高可靠性、低成本的光模块。结果就是现在很多做工业互联网的客户,想找个能在零下40度环境里稳定工作的100G光模块,价格比原来涨了2倍。对吧,你根本想不到,工业场景用的光模块产能,会被大模型的训练任务挤到要涨价。 更离谱的是校招市场。现在所有校招的算法岗,不管你是做推荐的、做搜索的、做计算机视觉的,面试的时候都要问你数据并行的原理,你要是答不出来,连笔试都过不了。但实际上,90%的算法岗,一辈子都不会碰到需要跑千亿参数模型训练的场景,你学那套跨节点梯度同步的原理,跟你开个家用轿车,非要学开重型卡车的换挡技巧有啥区别?完全是无效内卷。 说真的,我现在看到校招JD里要求”熟悉数据并行训练框架”,就觉得离谱。 卷不动了。 大家本来可以把时间花在怎么把模型做的更准、怎么让产品更贴合用户需求上,结果现在所有人都在盯着怎么把数据并行的并行度再拉高一倍,怎么把同步延迟再压几毫秒,就为了在发布会上多吹一个百分点的吞吐率。 等下一轮融资的钱花完的时候,没人会记得谁的训练吞吐率最高——大家只会问,你靠数据并行堆出来的模型,真的赚过钱吗?作者|大讲堂
排版|大讲堂
审核|知知