 大讲堂

2026年Q2的大模型圈,出了个特别好笑的事。
那个去年刚拿了2.3亿B轮融资、在发布会上拍着胸脯说自己靠全量自注意力架构实现了1000万token无限上下文理解的多模态创业公司,上线三个月就被用户扒了底裤——他们偷偷把模型里70%的全量自注意力层换成了三年前就被他们在技术博客里骂成”技术倒退”的稀疏检索模块,单token推理成本直接砍了82%,用户的实际留存率反而比换之前涨了17%。
离谱吗?
一点不。
我当时看到这个内部爆料的时候,差点把手里的冰美式喷在键盘上。之前看他们的发布会,CTO站在台上拿着激光笔,指着投影上的自注意力矩阵图,说”这是通用人工智能的必经之路”,台下坐的投资人纷纷鼓掌,觉得自己投中了下一个OpenAI。结果上线之后,用户发现只要上下文超过128k,模型就开始”老年痴呆”:要么把用户半小时前说的合同付款条款忘得一干二净,要么把用户让生成的产品方案里的核心需求换成八竿子打不着的内容。一开始大家以为是模型能力不行,直到内部的技术文档流出来,才知道根本不是能力问题——是他们根本扛不住全量自注意力的算力成本。
算笔最直白的账:全量自注意力跑100万token的单次推理算力开销,足够给一台1.5匹的家用空调连续开18个月。你想想,用户问你一个100字的问题,你背后要调动的算力够空调吹一年半,这账怎么算得过来?更别说训练的时候,全量自注意力的平方级算力消耗,每多一倍的上下文长度,训练成本就要涨三倍。之前有个做技术的朋友跟我吐槽,他们团队为了凑够发布会说的”1000万token上下文”,硬着头皮训了两周,最后光电费就花了120万,结果发现用户根本不会在一个对话里写1000万token的内容——平均每个用户的上下文长度,连20k都不到。
说实话,我从2017年Transformer刚出来的时候就跟着看相关论文,从来没见过哪个技术概念能被炒到这么离谱的程度。大家把自注意力捧成了能让模型产生”认知能力”的魔法,好像只要用上全量自注意力,模型就能像人一样理解世界。可实际的情况是,大部分用户要的根本不是什么”认知能力”,就是个能快速响应、不瞎编的工具而已。
被神化的自注意力,本质是个算账问题
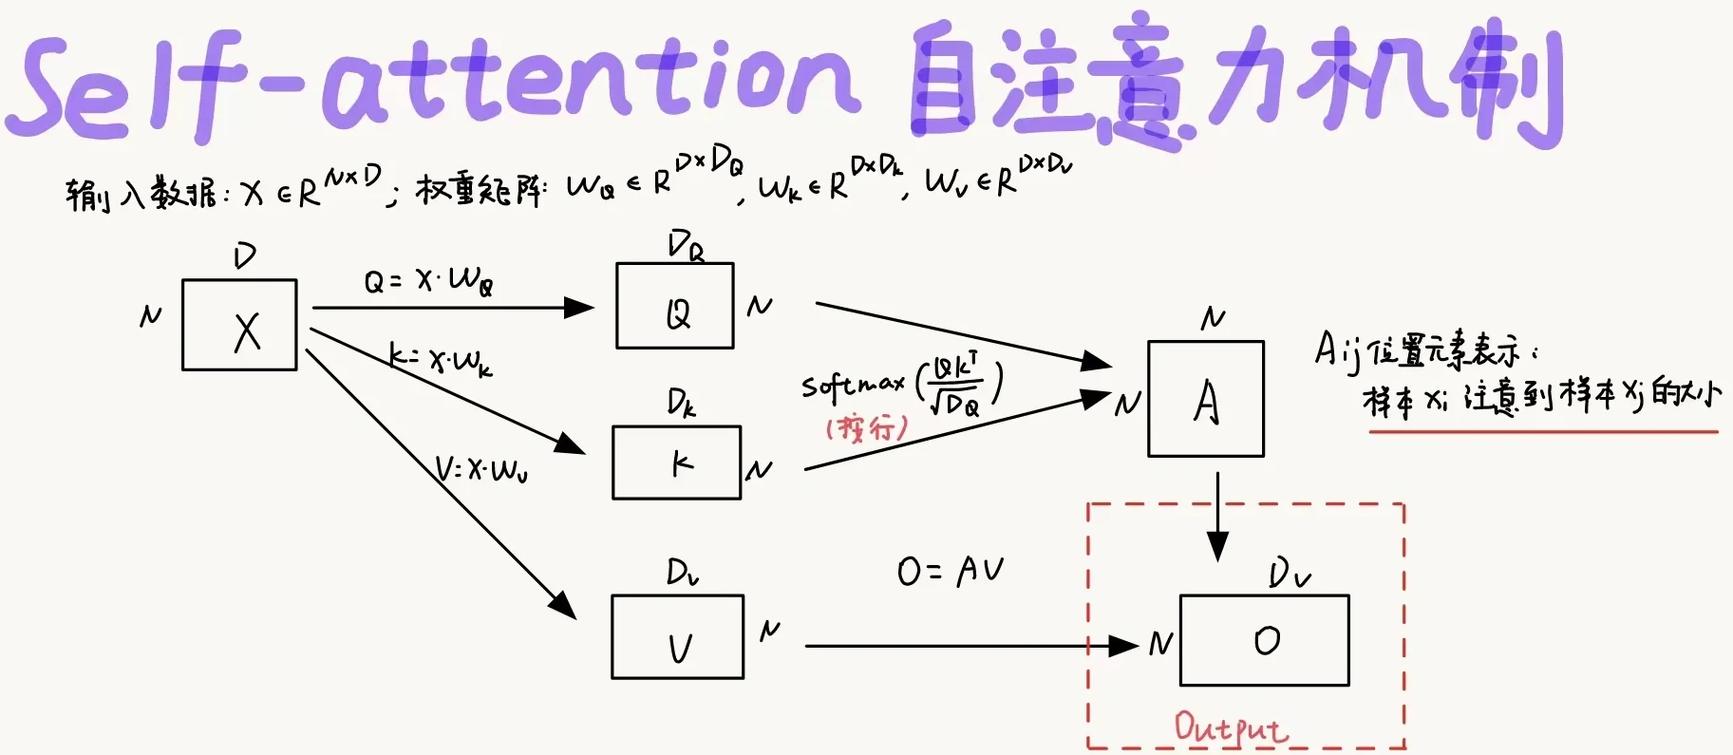
说白了,自注意力的逻辑没那么玄乎:就是让模型在处理每个词的时候,把上下文里所有的词都拉出来比一比,看看哪个词和当前的词关系最大,重点关注就行。问题是,上下文越长,要比的词就越多,计算量是平方级上涨的——这才是所有成本问题的根源,跟什么”认知革命”半毛钱关系没有。
不过话说回来,国内的厂商其实早就在偷偷解决这个问题了,只是没人愿意把话说透。比如2025年底阿里通义团队放出的多查询自注意力优化,他们当时算了一笔账:如果把传统自注意力里和Query头数一样多的KV头数压缩到原来的1/8,同等精度下,端侧部署的显存占用直接降了60%,相当于把原来只能跑在A100上的70B模型,塞到了带8G统一内存的MacBook Air里。还有那个做端侧大模型的面壁智能,他们从2024年开始就没在全量自注意力上死磕过,反而把大部分精力放在了稀疏自注意力的优化上,最后做出来的模型在手机上跑的速度,比同参数的全量自注意力模型快了4倍,用户感知的生成质量根本没差。
这里有个很扎心的对比:同等模型精度下,全量自注意力架构的训练成本比经过稀疏优化的自注意力版本贵3.2倍,但用户实际能感知到的生成质量差异,连5%都不到。
这场景像极了90年代零售行业的”大店模式”内卷:沃尔玛当年硬要把几万种SKU全堆到门店里,觉得全品类覆盖就能把社区便利店挤死,结果后来被专注核心品类、把成本压到最低的折扣店抢走近30%的市场份额。自注意力对全量关联的执念,就是算法界的大店逻辑——大家都把”全”当成核心竞争力的时候,往往忽略了”全”背后藏着的巨量成本。
很多人会问,既然全量自注意力这么烧钱,为什么还有那么多厂商死命吹?答案太简单了:因为好讲故事啊。你跟投资人说我做了个稀疏自注意力优化,把推理成本砍了一半,投资人可能觉得你是个会算账的工程师,给你估个10亿的估值;但你要是跟投资人说我用了全量自注意力架构,对齐了国际前沿的通用人工智能路线,投资人当场就能给你把估值抬到20亿。这哪是做技术,这是做估值锚点呢。
这个方向我认为走偏了。用户根本不在乎你用的是全量自注意力还是半量的,他们只在乎你能不能在1秒内给出我要的答案,别给我算三分钟还收我几毛钱的推理费。那些硬扛着全量自注意力的高成本,非要给用户吹”认知能力”的团队,本质上和当年卖天价保健品的商家没区别——把成本算进价格里,让用户为自己根本用不上的功能买单。
被叙事忽悠的从业者,该醒醒了
最惨的其实不是用户,也不是被割韭菜的投资人,是那些被自注意力叙事忽悠的普通算法从业者。
前两年我在高校做分享,台下的研究生问我,现在想进大模型行业,是不是得把自注意力的数学推导背得滚瓜烂熟,把Transformer的源码逐行研究透,才能拿到大厂的offer。我当时没好意思直接说,等你毕业的时候,招聘市场根本不考这些。
真的。2026年的大模型算法岗招聘,你要是面试的时候上来就跟面试官大谈特谈自注意力的通用认知潜能,面试官大概率会直接把简历扔到一边——现在大厂招算法工程师,根本不考你QKV的矩阵乘法怎么算,反而问你”怎么把现有自注意力模块的推理成本砍一半,精度掉幅不超过2%”。我之前跟字节大模型团队的招聘负责人聊,他们去年招的17个校招算法岗,有12个的核心工作内容是给现有自注意力模块做剪枝、做量化、做稀疏优化,真正在从头设计全量自注意力架构的人,连2个都不到。
卷不动了。真的卷不动了。之前大家挤破头想做的”前沿架构创新”,现在已经变成了纯粹的成本优化游戏。整个产业链的风向已经变了:2025年的时候,算力租赁市场的价格被炒到每小时12块钱一张A100,因为大家都在抢资源训全量自注意力的大模型;到2026年Q3,算力租赁的价格已经跌了47%,很多之前囤了几百张卡的小租赁公司,已经开始在二手平台上甩卖服务器了。
那些之前为了研究全量自注意力,花了几个月时间推公式、刷论文的学生,突然发现自己学的东西根本不被市场需要——企业要的不是能设计出最完美的自注意力矩阵的天才,是能把这个矩阵的计算成本压到最低的工程师。
我有时候在想,技术圈的叙事怎么永远这么离谱?前几年大家吹区块链的时候,说区块链能颠覆所有行业,结果现在大部分做区块链的公司都跑去做发币了;前几年大家吹元宇宙的时候,说元宇宙是下一代互联网,结果现在做元宇宙的公司都跑去做大模型了;现在大家吹自注意力是通用人工智能的基石,等再过两年,大家发现所谓的自注意力革命,不过是一场靠算力溢价堆出来的估值泡沫的时候,又该往哪个方向跑?
等2027年的春天,大家坐在办公室里看着手里已经跌了一半的算力租赁账单,再回头看今天吹得震天响的自注意力革命,会不会突然反应过来——这从头到尾,就只是一场算不明白的账?
作者|大讲堂
排版|大讲堂
审核|小北