2026-10-11 19:07:22
作者:
科技
上周逛家楼下的社区超市,想买无糖冰可乐找了三圈没见着。掏出手机打开新更的超市APP,对着空货架拍了一张,发了句语音问“这个位置原来放冰可乐的,现在还有货吗?放哪个区了?”。十秒不到,APP给我弹了准确位置,还说今早刚补了一箱,就在入口侧的冷藏柜第二层。
换三年前,你敢想这种事?
别盯着参数卷了,现在大模型开始“长眼睛长耳朵”了
以前我们聊大模型,聊的都是文字,最多就是它帮你写个文案改个简历,所有信息都得你敲成字输进去。它就像一个关在藏书楼里的老先生,学问很大,但你不把东西写成字给他,他啥也干不了。
多模态大模型不一样。它从训练第一天开始,就不是只啃文字。它看了上亿张图片,听了上百万小时的音频,甚至还“看”了好多段剪辑好的视频。它理解世界的方式,突然就接近我们普通人了——我们本来就不是只靠文字认识世界的啊,我们看到苹果是红的圆的,咬一口是甜的脆的,这些信息加起来才是“苹果”,不是只有字典里那行定义。
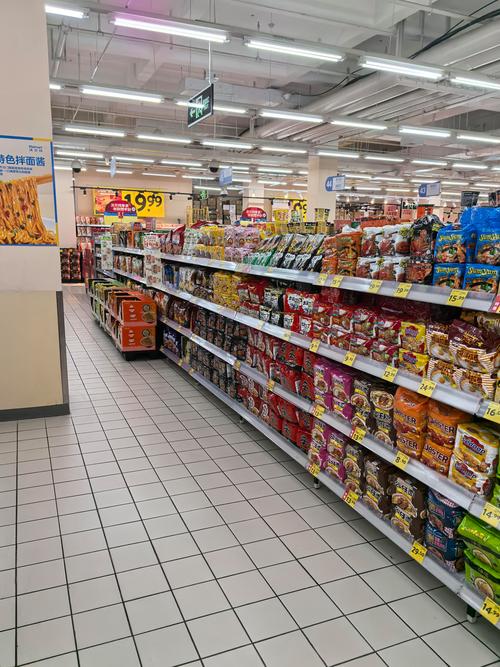 多模态大模型识别超市货架商品实景图
说实话,第一次用的时候我有点惊讶。你拍一张皱巴巴的手写菜单,字歪歪扭扭还沾了油,它能逐字给你转出来,还能认出来哪行是菜名哪行是价格,甚至能看出来哪个菜被划掉了。换以前的文字识别工具,早就乱成一锅粥了。
我踩过的一个误区:不是能发图就是多模态
这半年炒概念的太多了。好多人说我用的AI就是多模态啊,它能文生图,能给图片转文字,这不就是多模态吗?
不对。这里头藏着很多拼接出来的伪多模态。就是拿一个文字大模型,外面套一个图片识别API,你发图片,它先把图片转成文字,再把文字丢给原来的大模型处理,转一圈再给你输出结果。
这种用起来什么感觉?卡。而且经常错得离谱。我上次就试过,拍了我家冰箱的照片,说“帮我看看有什么食材,能做什么晚餐”,它转文字的时候只认出了“牛奶”两个字,半颗白菜半盒鸡蛋都没认出来,给我出了三道全是牛奶的菜…什么牛奶炖蛋牛奶布丁,我要吃正餐啊!
真正的多模态大模型,训练底层逻辑就不一样。它不用把图片转成文字再理解,它看图片的时候,就直接把图片里的信息和它学到的文字知识揉在一块了。你拍冰箱,它能直接看出来透明盒子里装的是切好的牛肉,锡纸包着的是剩下的披萨,就算标签被挡住了也没关系。它认的是东西,不是文字。
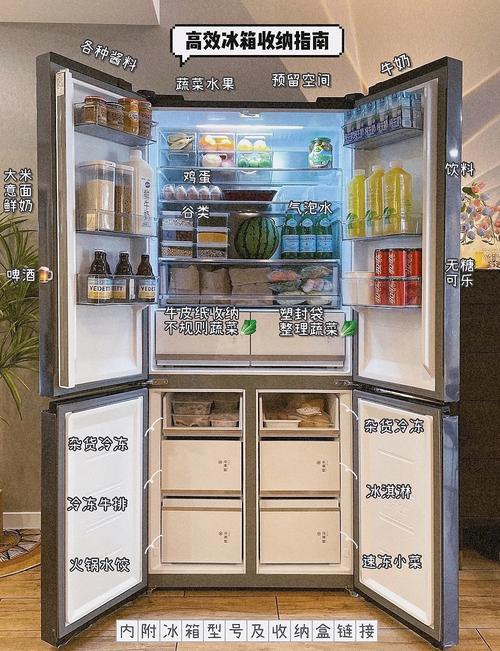 多模态大模型分析家用冰箱食材示意图
不过话说回来,现在真的做到底层融合的多模态,还没几个。大部分都是换个皮炒概念,骗一波流量就走。普通人选的时候,试一次就知道了:你拍一张带图的手写题,看它能不能直接给你讲,要是它还让你“请输入题目文字”,那百分百是伪多模态,没错。
接下来普通人能摸到什么实在好处?
 接下来普通人能摸到什么实在好处?
很多科技新闻说来说去都是给投资人看的,什么“迭代”“布局”,听着云山雾绕,和我们没关系。多模态不是这样,它很快就能落到你每天用的东西里。
比如装修。你拿张手绘的户型图,随便画两笔,拍个照给多模态,说“我要放一张1.5米的床,再加一个书桌,怎么摆不挤”,它直接给你出方案,还能告诉你哪堵墙不能动,插座位置够不够。不用找设计师花几千块画初步图,自己就能先试七八种方案。
比如无障碍。视障朋友出门,拍一张公交站的站牌,多模态直接给你读清楚哪路车几点来,往哪个方向走,旁边有没有台阶,有没有自行车挡着。比以前的读屏工具准太多,以前的读屏只能认印刷好的文字,稍微糊一点歪一点就瞎了。
还有做内容的朋友,你拍一段自己出去玩的vlog,直接丢给多模态,说“帮我把这里头猫咪出现的片段剪出来,加一段搞笑的字幕”,它直接给你弄好,不用你自己对着时间轴拉半天。
当然,问题也不少。它还是会犯蠢,你拍两个长得差不多的包,它经常认错款。还有隐私,你给它拍你家身份证拍你家户口本,这些数据会不会被存在人家服务器里,至今没有个准说法。用的时候还是得留心,别什么照片都往里头传。
我觉得挺有意思的。原来我们觉得AI就是玩文字,现在它终于睁开眼睛看这个世界了。就像小孩子刚学会走路,虽然摇摇晃晃还经常摔,但你知道他接下来能跑能跳,能去好多地方。
不信你过两年再看,你手机里大半的APP,应该都偷偷用上多模态了。你不用知道它是什么,你只会觉得,哎,怎么现在用着比以前顺多了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:逛超市时帮你找缺货的多模态大模型,到底比普通大模型强在哪
文章链接:https://m.lfdjt.com/p/keji/a/8989.html