2026-10-10 20:28:55
作者:
科技
上周约饭,朋友把电脑甩我桌上。
快帮我看看。
说他花了一下午用新出的多模态工具做产品发布会PPT,每一页图文都是AI生成的,临开会前才发现,主产品图上硬生生多出来两个多余的按键,介绍文案里还把“续航”拼成了“续航空”。
我盯着屏幕笑了五分钟,突然反应过来,这大概是大多数人第一次真正接触多模态大模型的样子——只听过它封神的宣传,实打实踩坑才知道,这东西和你想的根本不一样。
别翻百科了,我给你说句人话
很多科普上来就扔定义,说什么“能够同时处理多种模态信息的大模型就是多模态大模型”,说半天普通人还是听不懂。
说白了,以前的AI都是“残疾人”。
做文字的AI只认得字,认不了图;做图像的AI只看得懂图,听不懂你说的话。各干各的,互不干涉。
比如你给以前的AI发一张猫的照片,再说“给它加个帽子”,文字模型听不懂你说的“它”指的是照片里的猫,图像模型看不懂你说的“帽子”要加在哪里。
多模态大模型最核心的不同,就是它能把这些不同类型的信息放在一起理解。你发图发文字发语音,它知道这些信息说的是同一件事,能串起来给你反馈。
就这么简单。
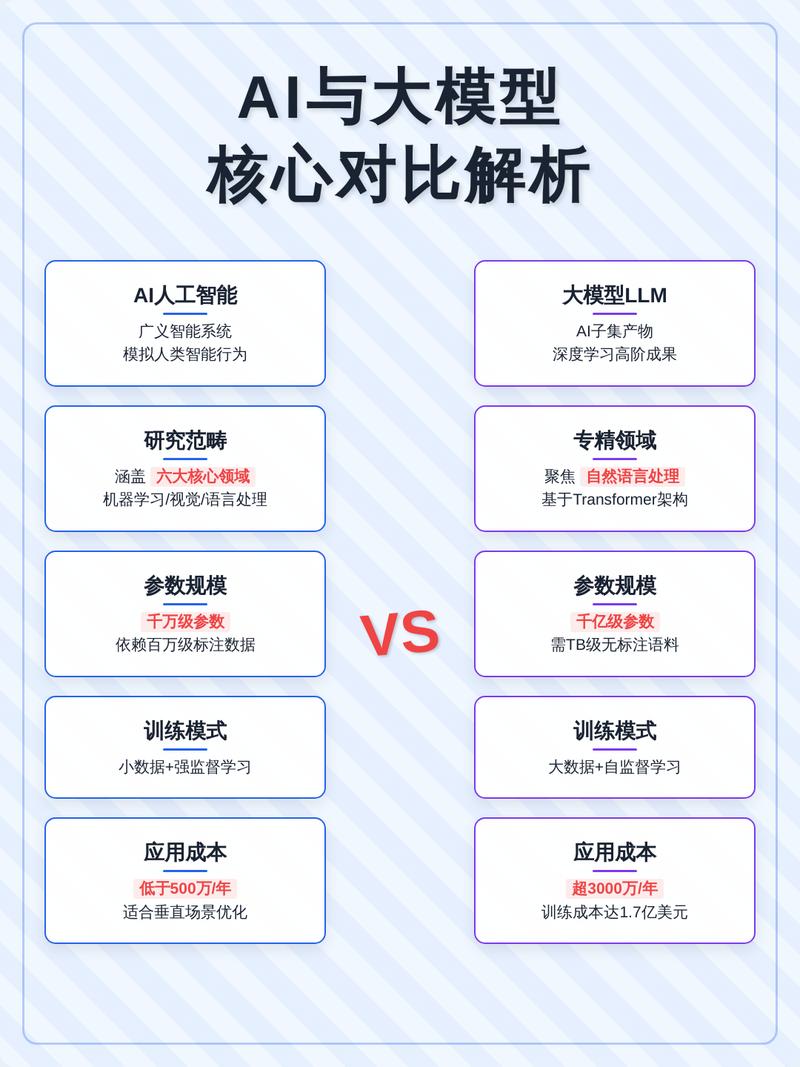 单模态AI与多模态大模型信息处理对比示意图
说实话,这个概念其实几十年前就有,只是最近两年大模型的参数够大了,才终于做出了能用的成品,放到普通用户面前。
你踩过的坑,其实都是它的天生缺陷
我翻了一圈测评,发现90%的用户吐槽都踩在同一个点上:图文不对版,答非所问,犯低级错误。
我自己上个月试过,让它根据我拍的我家猫的照片,生成一张手绘头像。结果出来个三条腿的猫,它还跟我说“这是艺术化的抽象处理,更显猫咪灵动”。
我当时对着屏幕翻了十分钟白眼。
很多人不知道,现在大部分民用多模态工具,本质都是拼接出来的,不是真正的端到端统一理解。一个模型负责识别图片,一个模型负责处理文字,中间拼个接口就拿出来卖了。
两个模型各想各的,不出错才怪。
 多模态大模型图文生成错位案例对比图
网上一堆吹它能取代设计师取代文案的,真的是收了钱瞎说话!
它现在连数清楚一张图里有几个苹果都能数错,你敢让它直接出最终稿?
还有个误区很多人搞不清,觉得多模态一定比单模态厉害。真不是。它只是能处理的信息类型多,真要比纯文字翻译、纯图片修图,它还不一定干得过深耕那个领域的老牌单模态模型。
术业有专攻,这话放到AI圈也适用。
有的公司拿它换皮割韭菜。割一波就走。留下一堆烂摊子给用户擦屁股。
真正值得期待的变化,不在你刷得到的地方
 真正值得期待的变化,不在你刷得到的地方
不过话说回来,我不是说多模态大模型是骗钱的。
这条路方向肯定是对的,毕竟我们人本来就是同时用眼睛看、耳朵听、嘴巴说,本来就是多模态接收信息的。AI要真的想理解这个真实世界,肯定要走这条路。
只是现在大家都盯着C端的生成工具,什么做PPT、做短视频封面,其实真正落地走得稳的,全在B端那些大家看不到的地方。
我前阵子接触过一个做工业运维的团队,他们用多模态大模型做了个检修工具。工人去现场拍一张故障机器的照片,对着手机说一句“昨天这里就嗡嗡响,今天声音变大了,温度也比旁边的机器高”,模型半分钟就能匹配后台的维修手册、过往的同类型故障记录,直接给你出排查步骤。
换以前,工人要翻几百页的纸质手册,还要打电话问远在总部的老师傅,一来一回大半天,现在十几分钟就能搞定。
还有考古领域,现在也有人用多模态整理文物资料。拍一张陶片的照片,输入考古现场的笔记文字,模型就能自动帮你匹配博物馆里同类型的陶片样本,帮你拼对复原,比专家一个个翻档案快了不知道多少倍。
这些地方,才是多模态大模型真真正正能提升效率的地方,没有那么多噱头,就是解决实实在在的问题。
说实话,我现在看多模态圈的热热闹闹,反而觉得有点意思。技术出来,大家都抢着在C端做网红产品赚快钱,真正沉下心做落地的,反而在后面闷声发大财。
技术从来都不是为了炫技存在的,能解决具体问题,才是真的有用。
我前几天再问那个朋友,后来PPT怎么样了?他说删掉了AI生成的所有内容,自己花两个小时改完了,发布会开得很顺利。
哦对了,他说现在还是会用多模态找灵感,就是不再直接用它出成品了。
这大概就是普通用户面对新技术最好的状态——不神化,也不抵触,用它能干的活,剩下的自己来。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:当我用多模态大模型改了3版PPT,才发现大家都错了
文章链接:https://m.lfdjt.com/p/keji/a/8647.html