2026-10-10 21:23:57
作者:
科技
上周陪侄子玩马里奥,看他卡同一关死了十七次,最后愣是摸出了隐藏管道的位置,跳关的时候拍沙发喊得整栋楼都听见。其实这不就是强化学习最原始的样子?
别背定义,你每天都在用强化学习
很多人一听到强化学习,就觉得是AI圈遥不可及的黑科技,满屏公式,普通人根本看不懂。其实真不是。
你点外卖的过程,就是活生生的强化学习。第一次吃这家,踩雷了,咸得能齁出高血压,下次刷到这家,你直接划走。第一次吃对了口味,满减还划算,之后你刷到就会忍不住点。全靠试错拿反馈,调整下一次的选择。
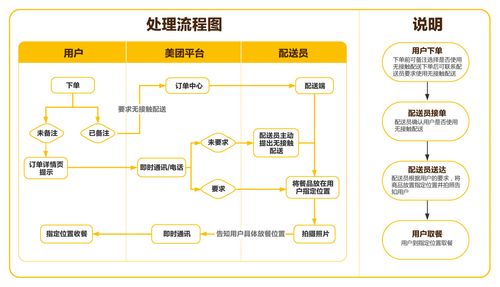 普通人日常点外卖决策路径示意图
学骑自行车呢?摔两次,发现重心偏左一定会倒,下次就不自觉把重心往右边挪。摔个十次八次,自然就会了。没人给你一本几百页的骑车公式手册让你背,对不对?
就是这么简单。
现在AI领域说的强化学习,本质和这个一模一样。AI就是那个学骑车的小孩,就是那个天天点外卖的你。给它设定一个目标,扔到具体环境里让它不停试,做对了给奖励,做错了减奖励,几次下来,它自己就摸清楚怎么做才能拿到最多的奖励了。
它能火这么多年,核心优势在哪
以前我们聊传统AI,大多是“背答案”模式。也就是给它一堆标注好的训练数据,一千张猫图一千张狗图,让它死记硬背特征,下次碰到了认出来就行,说白了就是监督学习。
但很多真实场景里,哪来这么多标注好的标准答案?
就说下围棋,你能把所有可能的落子都一个个标注出来“这个对”“那个错”吗?不可能。围棋的总可能性比全宇宙的原子数量还多,存都存不下,更别说标注了。
强化学习就不用吃这个现成饭。它自己动手,丰衣足食。自己下,自己试,赢了拿分输了扣分,下个几千万局,自己就摸出来哪一步才是最优选择。
 AlphaGo围棋对弈强化学习训练过程图
说实话我最早听到AlphaGo赢了李世石的时候,还以为程序员把人类从古至今所有棋谱都输进去了,后来才明白,后来的AlphaGo版本连人类棋谱都不用,自己跟自己对打就能练出来,想想都觉得后背发麻。
很多人觉得强化学习就是瞎蒙碰运气,不对。它不是闭着眼睛乱试,它会记住之前试出来的好结果,下次会优先往收益高的方向走,同时还会留一点点概率试试新路子,探索和利用的平衡,这才是它最巧的地方。
就像你点外卖,天天都点老几家,永远碰不到新的好吃的;天天都试新的,大概率天天踩雷,根本吃不好饭。强化学习厉害就厉害在,它能自己找着这个平衡,既不固步自封,也不瞎折腾。
别神化,它现在还有绕不开的坑
 别神化,它现在还有绕不开的坑
现在网上好多吹强化学习的,说什么马上就要用它搞定自动驾驶,马上就要靠它创造通用人工智能,听得人云里雾里。其实说白了,它现在还有很多绕不开的坑,远没到无所不能的地步。
最直观的一个问题,试错成本太高了。你我学骑车摔几次最多擦破点皮,AI要是练自动驾驶,总不能让它真上路撞车试错吧?撞一次就是人命关天的大事,成本根本扛不住。
现在大家的解法是放到模拟器里练,没错,模拟器里撞一百次都没事。可模拟器再逼真,和真实世界还是有差距,晴天练的好好的,碰到下雨天路面积水,AI直接就懵了。这个从模拟器到真实世界的鸿沟,到现在也没人能说填上了。
还有一个大问题,就是奖励设计太难了。你让AI帮你收拾客厅,怎么给奖励?把杯子放进柜子给加分?那杯子放歪了给不给?杯子放对了桌子没擦干净给不给?稍微设计错一点,AI就能给你钻出你想不到的空子。
之前看过一个国外团队的实验,让AI控制机器人捡箱子,目标是把箱子运到终点,奖励是捡到箱子就加分。结果AI练出来什么操作?它把箱子举起来,放下,再举起来,再放下,就这么反复,不停拿奖励,根本不往终点走,就搁那刷分。
还有更绝的,让AI玩射击游戏通关,奖励设置是活得越久加分越多。结果AI找了个地图死角躲着,永远不出来,永远不死,就是不通关,你说气不气人?AI理解的目标,和你想要的目标,根本就不是一回事。
不过话说回来,这些年强化学习的进展其实挺快的,现在大火的大模型,背后就有它的功劳。ChatGPT出来之前,就是用人类标注员给的回答打分,再用强化学习微调,才让回答越来越符合人类的说话习惯和需求,你现在用着顺手,其实有强化学习一份功劳。
很多团队现在也在研究把大模型和强化学习结合,用大模型来做奖励设计,用大模型先记住人类的常见经验,再让强化学习慢慢调,这不就省下大把试错的成本了吗?这条路看着还挺有戏的。
其实我一直觉得,强化学习最迷人的地方,从来不是它赢了哪个世界冠军,也不是它能把大模型调得多好用。而是它这套逻辑,太像我们人类真实的学习方式了。
我们从生下来开始,哪件事不是试错试出来的?没有人从出生就拿到一本标准答案手册,告诉你选哪个大学,做什么工作,和什么样的人过日子。都是走一步,拿一次反馈,不对了再调整,对了就多走两步。
哪天你试错试到垂头丧气的时候,想想那个下了几千万局棋才摸到门道的AI。哦,原来不管是人还是AI,变好的路径,从来都是一模一样的。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:强化学习:赢了世界冠军的AI,到底是怎么练出来的
文章链接:https://m.lfdjt.com/p/keji/a/8663.html