2026-10-02 03:12:18
作者:
科技
上周六下午,我在南京珠江路路口的咖啡馆待了三个小时。
朋友拽着我试了四个不同的工具,全是最近炒得很热的多模态大模型。
咖啡凉了三次。我也算摸出点不一样的感受。
别翻百科了,我给你说人话
原来我们接触的大部分大模型,都是“单通道”的。
你只能给它输文字,它也只能给你出文字。你拍一张猫啃西瓜的照片发过去,它认不出这是什么,更别说接你的话。
多模态大模型不一样。
它就像我们正常人一样,眼睛能看、耳朵能听、脑子能转,你给它什么类型的信息,它都能一起收下读懂。你发一张你家客厅的照片,说“帮我想想这个角落放个什么样的落地灯好看,给我出三张效果图”,它直接给你出结果,不用你再把照片转成一大段文字描述。
说穿了,就是把原来计算机之间隔着的那道“不同格式不能互通”的墙,给拆了。
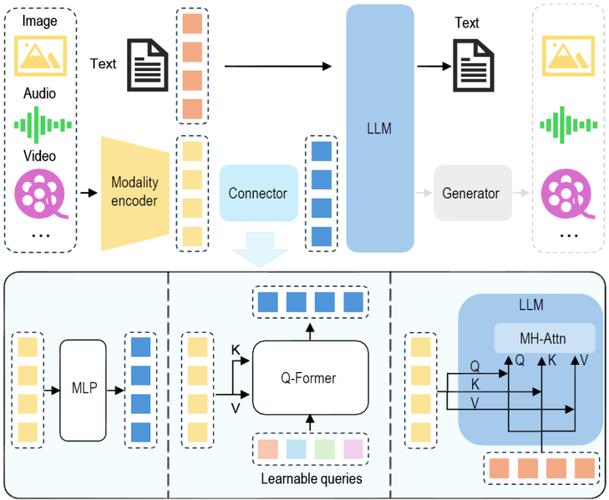 单模态与多模态大模型输入输出对比示意图
说实话,刚出来的时候我也觉得这就是资本炒的新概念,换个皮割韭菜。
真用了才知道,不一样。
那天朋友要改一个产品宣讲的PPT,原来的PPT里有一张模糊的产品实拍,他给模型发了原图,说“把这张图修清晰,去掉背景的杂物,然后帮我把页面上的三行文字挪到左下角,给我直接导出成可以用的PNG”,前后花了不到一分钟。
放半年前,你得找个设计师,开PS修图,调排版,导出,没半小时搞不定。
这就是变化。
大部分人都踩过的三个误区
第一个误区,很多人说“多模态就是文字加图像拼一起”,不对。
真正的多模态,不是先把图像转成文字,再用文字模型处理,它是把所有信息放在同一个空间里理解。
我试过一款早期的所谓“多模态”工具,我发一张电影海报,问我“这个海报上男主角穿的鞋子,能不能给我找一双同款风格的推荐?”,它先把海报转成一大段文字:“这是XX电影的海报,男主角穿了一双黑色的皮鞋…”,转完再去搜,最后给我推了八百年前的老年皮鞋,完全不对味。
现在真正的多模态,直接读像素,读我文字里的“同款风格”,搜出来的结果能沾上边,差不离。
第二个误区,多模态一定比纯文字大模型强?
扯。
你要是就写一篇几千字的行业分析,纯文字大模型写得比大部分多模态顺多了,逻辑也更顺。多模态为了能读懂不同格式的信息,参数量往那堆,反而容易想多,说着说着就跑题。
适合的场景不一样而已,没有谁一定取代谁。
第三个误区,普通人用不上这高端技术?
你早就用上了。
你刷短视频的时候,AI自动给你识别语音加字幕,你淘宝拍个照片搜同款,你用导航的时候它语音识别你说的话还能看懂你共享的位置,背后跑的都是多模态的逻辑。
只是它藏在产品背后,你没感觉到而已。
 普通用户日常使用多模态AI产品场景图
不过话说回来,现在的多模态大模型,还是半成品。
我上周拿了一张我小学毕业照,糊得不行,人脸都磨开了,让它给我修复,把我脸上的眼镜框给修清楚,它倒是把分辨率提上去了,直接把我旁边站的女同学给修没了…留了一块空白背景在那,给我整笑了。
技术还是有漏洞,没到完美的地步。
往后走,哪些地方真的会变
 往后走,哪些地方真的会变
我最近跟做硬件的朋友聊天,他说现在线下实体行业,盯着多模态盯得紧。
比如你去买家具,原来你得对着导购描述你家客厅多大,墙是什么颜色,现在你掏出手机拍一张你家客厅,说“我要放一个两米八的沙发,帮我看看什么颜色搭,放进去是什么效果”,多模态直接给你拼好图,你自己看,比导购说一万句都有用。
还有辅助工具这块,真的能改变很多人的生活。
盲人朋友出门,原来只能靠盲杖和听声音,现在拿带多模态的手机对着路口拍一张,问“前面路口的红绿灯是红还是绿,有没有台阶”,几秒钟就能得到准确的回答,不用麻烦别人问来问去。
这些不是概念,已经有产品在测了。
很多人吹说多模态会带来下一次工业革命,我没那么大的判断。
我只知道,原来我们用工具,得迁就工具的规则:要做图用PS,要写文字用Word,要算数据用Excel,你得把你的需求拆成不同工具能懂的格式,一个个弄。
现在多模态把这个规矩打破了,你不用迁就工具,你说你要什么,给它所有你有的信息,它帮你弄。
就像当年功能机变智能机,刚开始大家都只是觉得“哦,能上网了”,谁能想到十年后所有人的衣食住行都绑在上面。
现在这个阶段,像极了2010年的安卓机,所有人都知道它会变,没人说得准最后变成什么样。
那天从咖啡馆出来,我们顺路在丹凤街买了鸭血粉丝汤打包。
朋友说,原来觉得多模态大模型是实验室里飘着的词,跟卖菜的阿姨没关系。
现在想想,再过两年,说不定小区门口卖菜的阿姨,都能拿着它扫一眼你拍的优惠券,算清楚你要的菜多少钱,连计算器都不用按。
没那么玄乎。
就是让工具,更像人一点而已。
对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:我用多模态大模型改了三版PPT,才懂它到底不是什么
文章链接:https://m.lfdjt.com/p/keji/a/5504.html