 大讲堂
你有没有过这种经历?手机相册里塞了几万张照片,想找一张“去年夏天在海边吃烧烤,旁边有只金毛”的画面,翻到手酸也翻不到。搜索引擎能帮你,但你得先描述清楚。现在,有些工具能让你直接扔一句“找一张有狗的海边烧烤照”,然后它就真给你翻出来了。这就是多模态大模型在干的事之一。
说实话,这东西听起来玄乎,但拆开看,它其实就是在学一件事:把不同形态的信息——文字、图片、声音、视频——塞进同一个“理解框架”里。不是简单的“图片转文字”或者“文字搜图”,而是让模型在它们之间建立某种内在联系。有点像你小时候学汉字,看到“苹果”两个字,脑子里自动浮现出红彤彤、咬一口脆甜的画面,甚至能想起它的味道。多模态大模型就在试图模仿这种跨感官的联想能力。
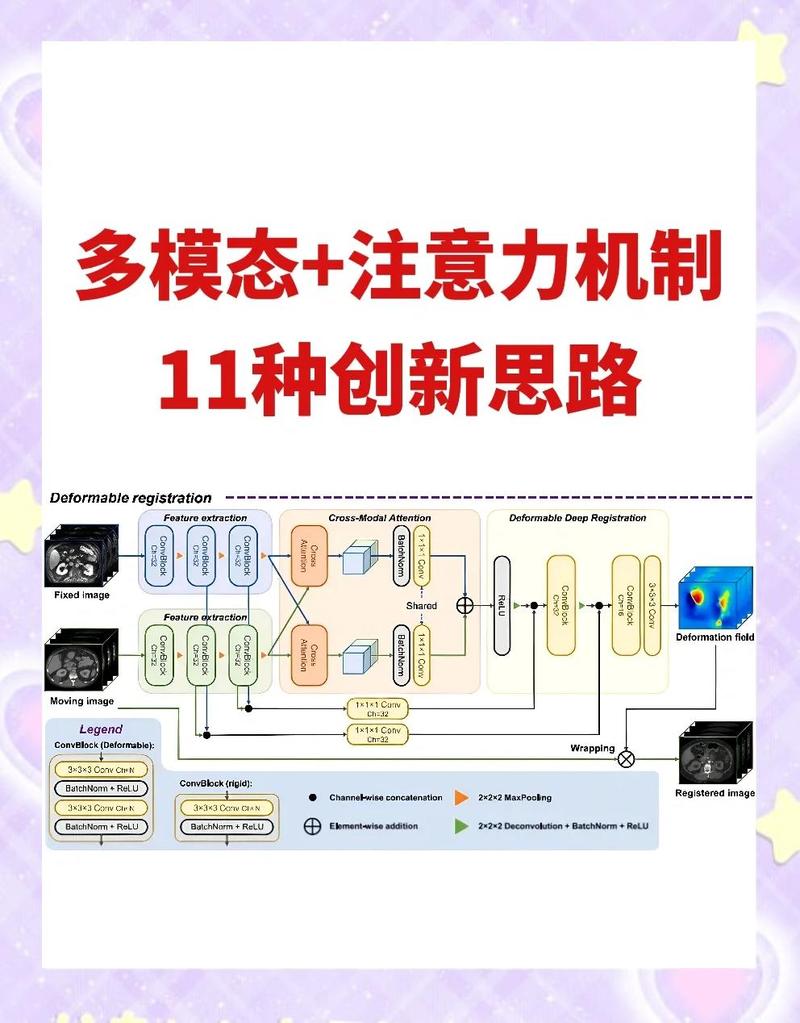
它到底是怎么“看”图的?
先说个最直观的。你给模型一张图,它并不是像人一样“扫一眼”就懂了。它会把图片切成很多小块,每一块变成一个数字向量——你可以理解为给每个小方块编个“指纹”。然后,模型会拿这些“指纹”和文字对应的“指纹”去比对、对齐。比如“猫”这个词的向量,和图片里猫耳朵、猫尾巴区域的向量,在某个高维空间里靠得越来越近。这个过程,专业上叫“对比学习”,但你可以简单粗暴地理解成:模型在玩一个巨型连连看,把文字和图像里的对应部分连起来。
不过,早期的做法挺笨的。图片编码用一个网络,文字编码用另一个网络,中间搭个桥。桥搭得好不好,全看训练数据里图片和文字的配对质量。配得多了,模型就慢慢悟出“哦,原来‘奔跑’这个词经常对应着四条腿前后伸展、背景模糊的画面”。但问题是,它只能处理“整张图”和“整句话”的粗粒度匹配。你问它“图里左边那只猫是什么颜色”,它就懵了。
后来,大家开始把图片切得更细,让模型关注局部区域。再后来,干脆把图片特征直接喂进大语言模型里,让语言模型来“指挥”视觉部分。这就好比原来两个部门各干各的,现在改成联席办公,信息流转快多了。于是模型不仅能认猫,还能数猫、描述猫在干嘛、甚至推理“猫为什么盯着那个盒子看”——因为盒子上面有个逗猫棒。

为什么它有时候像天才,有时候像傻子?
你肯定见过那种情况:给模型一张图,问“图里有几个红气球”,它说三个,你数了数明明四个。或者问“这个人手里拿的是什么”,它信誓旦旦说“手机”,其实是遥控器。这不是它故意气你,而是它的“看”和“想”之间还有缝。
一个关键原因是,模型学到的“对齐”是基于统计规律的,不是基于真实世界的因果理解。训练数据里,遥控器和手机长得像,且经常出现在“手拿物品”的语境里,模型就容易混淆。它没有真正摸过遥控器,不知道按一下电视会换台。它只是见过无数张“手拿遥控器”的图片,配的文字里有时写“手机”,有时写“遥控器”,它就晕了。
另一个麻烦是,多模态模型处理长视频或者多张图时,容易“忘事”。比如你给它看一段五分钟的做菜视频,问“第二步加了什么调料”,它可能只记得最后出锅的画面。因为视频帧太多,模型注意力有限,早期的帧信息被后来的覆盖了。这跟人有点像——你看完一部电影,可能只记得几个高潮片段,但让你复述每一句台词,你也做不到。
还有一点,很多人以为多模态大模型是“全能选手”,能看图、能听声、能读字,就啥都行。实际上,它在不同模态上的能力极不均衡。文字理解往往是最成熟的,图像次之,视频和音频的时序推理还比较弱。你让它写首诗,它可能出口成章;你让它根据一段交响乐描述情绪变化,它可能就只会说“激昂”“悲伤”几个标签词。这背后的原因也简单:训练数据里,高质量的“音频-文字”配对,比“图像-文字”配对少得多。巧妇难为无米之炊。
有人问:那它跟人的“多模态”是一回事吗?

差得远。人的多模态感知是实时的、具身的、带情绪的。你摸到一杯热水,同时看到冒热气,听到水壶咕嘟响,这一整套体验是同步发生的,而且和你“怕烫”的记忆绑定。模型没有身体,没有触觉,没有痛感。它处理的是已经被数字化、离散化的符号。它学的是“关联”,不是“体验”。
但这不意味着它没用。恰恰因为它没有身体,它可以同时“看”几百万张图片,同时“听”几万小时音频,从海量数据里找出人眼忽略的规律。比如在医疗影像里,它可能发现某种病灶的纹理和特定文字描述之间的微弱关联,而人类医生因为精力有限,未必能穷举所有组合。这不是说它比医生强,而是说它提供了一个不同的观察角度。
也有人担心,多模态大模型会不会让 deepfake 更泛滥?确实,生成逼真视频和音频的门槛在降低。但反过来,检测多模态伪造的技术也在跟进。这就像一场猫鼠游戏,没有一劳永逸的终点。关键在于,我们得知道模型能做什么、不能做什么,而不是盲目信任或一味恐惧。
接下来它会往哪走?
短期看,多模态大模型会越来越“接地气”。比如你拍一张冰箱内部照片,它直接告诉你今晚能做什么菜,缺什么调料。或者你对着说明书拍一下,它用语音一步步教你组装家具。这些场景不需要模型有多“聪明”,只需要它把视觉识别、文字理解和对话能力串起来。
中期看,视频理解会是重点。现在很多模型能看懂单张图,但看一段视频就抓瞎。难点在于时序——动作的先后顺序、因果链条、镜头切换。举个例子,视频里一个人先开冰箱,再拿鸡蛋,然后打蛋。模型得知道“打蛋”发生在“拿鸡蛋”之后,而且鸡蛋是从冰箱里拿出来的。这种时序推理,目前还在实验室阶段。
长期看,多模态模型可能会和机器人结合。机器人有传感器,能直接感知物理世界,不再是只看图片和文字。那时候的“多模态”,才是真正的多感官融合。当然,这还早。眼下我们看到的,更多是软件层面的交互。
最后说个冷思考:多模态大模型再强,它也是镜子,反射的是我们喂给它的数据。数据里有偏见,它就有偏见;数据里缺失某种语言或文化,它就对那种场景理解得差。所以,别指望它自动变得客观公正。它需要被审视、被纠正,就像任何工具一样。下次你用它搜图或者问问题的时候,不妨多留个心眼——它给你的答案,背后是一大堆统计规律在起作用,不是它真的“懂”了。

作者|科技
排版|科技
审核|乐乐