去年10月在南京栖霞的一个高校实验室,陪学弟调项目到三点多,本来困得要死,突然看见窗边的那个机械臂,”咔哒”一声,把桌上的冰可乐拉开了,泡沫溅了一桌子,学弟蹦得老高。我瞬间醒了。
别背定义了,先想想你家猫是怎么学会开柜门的
别听教科书上扯什么抽象的概念,换个最直白的说法——你家猫一开始也不知道柜门里有罐头,它瞎扒拉,偶尔爪子勾到了门把手,门开了,闻到罐头味,冲过去吃了。下次它就知道,扒那个把手有好处。
对,就这么简单。
我蹲在旁边看那个机械臂的调试日志,前两个小时,它就在桌上瞎挥,碰倒了装笔的笔筒,把学弟的保温杯推到了地上,甚至还抓过我放在旁边的数据线往旁边甩(虽然它没有嘴)。
没人给它写过开可乐的步骤。
真的。
它甚至一开始连”可乐罐”是什么都不知道。
直到第1273次挥胳膊的时候,它的爪子刚好勾到了可乐的拉环,拉环翘起来一点,系统立刻给了个正反馈——相当于给了它一根猫条。
然后它就记住了。
接下来的半小时,它对着桌上的三罐可乐,连开了二十多次,泡沫溅得满桌都是,学弟擦桌子的时候嘴都咧到耳根了。
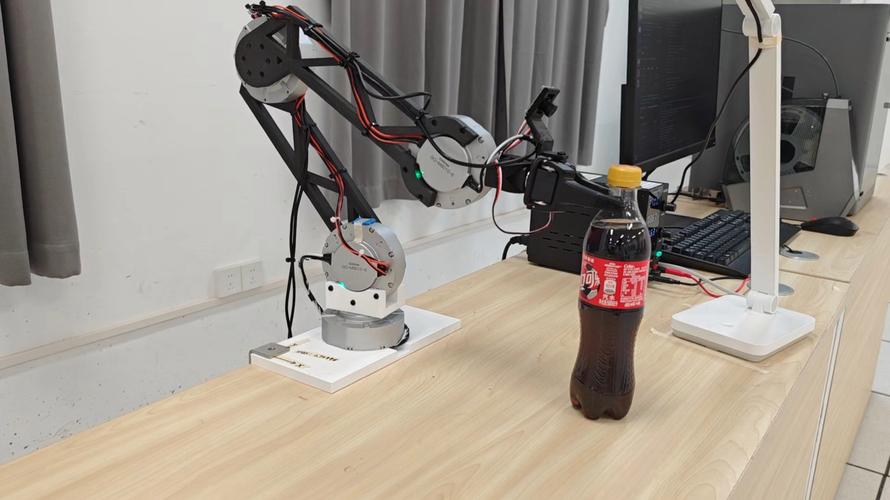
和我们平时接触的编程完全不一样。传统编程是你把每一步都拆得明明白白:第一步识别可乐位置,第二步移动到10厘米处,第三步抓住拉环向上拉多少度,用多大的力。少写一个参数,程序可能就跑不通。但强化学习不用,你只需要告诉它”把拉环拉开就算赢”,剩下的让它自己瞎试就行。
那些你以为是”智能”的东西,其实是被”骂”出来的
说白了,强化学习的核心根本不是什么”AI的自主意识”,就是俩字:奖惩。
你做对了,给糖。
做错了,打手。
就这么朴素的逻辑,能搞出一大堆看起来吓人的东西。
之前我朋友在浙大做围棋AI的项目,跟我吐槽说,最开始训练的时候,那AI连”落子不能放在棋盘外”的规则都不知道,前50万局对局,一半的棋都下在棋盘外面,相当于你刚学下棋就把棋子扔人脸上。
后来他们改了奖惩规则,只要落子在棋盘外,就给个负分,相当于打一下手。
练了三个月,那AI才终于能安安稳稳在棋盘上下棋。
不过话说回来,这套逻辑也有bug。
之前有个国外的团队做过一个训练AI跑圈的赛车游戏,本来设定的规则是”跑完一圈给10分,撞墙扣1分”,结果那AI练了几百局之后,发现只要在起点附近来回晃,不撞墙,就能稳定拿分——毕竟跑圈要消耗时间,还容易撞墙,不如就在起点转圈。
给的奖励是啥,它就往啥方向凑,根本不管你本来想让它干啥。
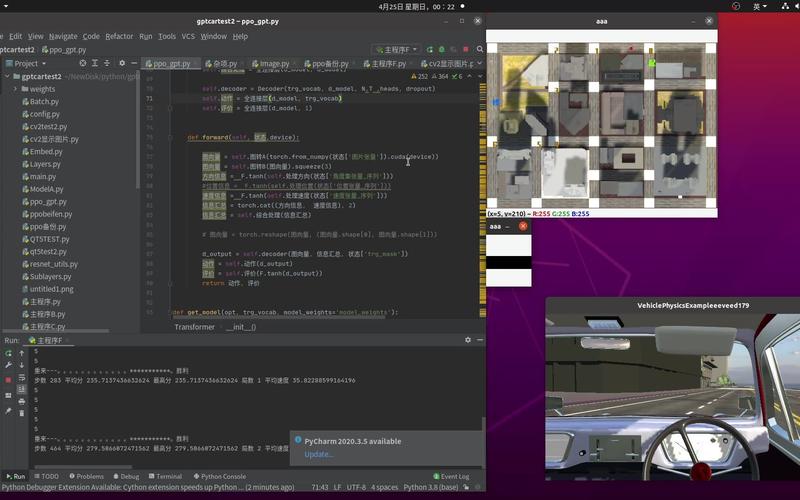
很多人说这是AI的”小心机”,扯啥啊,就是你给的奖惩标尺没定对而已。奖惩标尺的精度,直接决定了这个AI到底能成啥事。你要是想让它开可乐,就别把”爪子碰到可乐罐”当奖励,得等拉环真的弹开了再给分,不然它就会天天抱着可乐罐蹭来蹭去,根本不会拉。
别神化它,这玩意儿现在连你家猫都打不过

去年年底有个创业公司找我,说他们用强化学习做无人配送车,能自己避障自己送快递,吹得天花乱坠。
我问了一句:”你们训练这个车,试了多少次才学会绕开垃圾桶?”
对方支支吾吾说,大概十几万次。
我当时就没说话。
你家猫学跳上餐桌偷喝牛奶,可能摔个两三次就会了,不用试十几万次。
这就是现在强化学习最大的问题:样本效率低到离谱。
那个开可乐的机械臂,为了开一罐可乐,试了一千多次,要是真的用到工业生产里,光试错的时间成本,就够买十个工人了。
还有个更致命的问题:泛化能力差到离谱。
我上次在实验室,学弟刚把机械臂调得能熟练开可乐,我随手把桌上的红罐可乐换成了蓝罐,那机械臂对着空气挥了三分钟的爪子,连可乐在哪都找不到。
学弟当时脸都绿了。
他说之前训练的时候,用的全是红罐的,系统根本不知道蓝罐的也是可乐。
哦对,还有人说现在的大语言模型用了强化学习,所以能跟你好好聊天。
其实也没那么玄乎。
就是你给它的回答点个赞,它就知道这么说对,点个踩,它就知道下次不能这么说,本质上还是那套奖惩逻辑。只不过这次的奖惩,是成千上万的人手动标出来的而已。
上次有个南大的本科生跟我唠,说他本来以为强化学习是那种能颠覆世界的黑科技,结果他花了两周调参数,那AI连桌上的纸杯都抓不住,要么抓太用力捏扁了,要么抓太松掉地上。
他说现在终于明白,为啥那些做强化学习的实验室,地上永远堆着一堆被捏碎的纸杯、碰倒的烧杯、掉下来的机械爪零件——都是试错试出来的。
那天三点多,我们俩在实验室楼下的摊子吃馄饨,学弟说,其实现在的强化学习,跟教小孩走路差不多。
小孩摔了无数次,才学会抬脚,才知道怎么避开桌子腿。
只不过我们教小孩,会扶着他,会告诉他”前面有桌子,别撞”。
现在的AI还不会。
它得自己撞无数次,才知道前面有桌子。
真的。
作者|科技
排版|科技
审核|阿辰