 大讲堂

为什么九成企业的数据分级都是纸面活
自从数据安全相关法规落地之后,不管是大厂还是中小公司,合规流程里都多了一项:数据安全分级。
九成以上的分级,最后都变成了锁在硬盘里的PDF文档。没人看,没人用,纯粹是为了应付监管检查。
我接触过一家做零售的中型企业,去年花了几十万找厂商做分级。结果是什么?部门经理对着表格瞎填:销售说所有客户信息都是核心数据,人力说所有员工信息都是敏感数据,行政连公司采购的饮用水数据都敢标成内部重要数据。
全是水分。
厂商拿到填好的表格,套上国家通用标准的模板,整理完交差,收钱走人。完事之后该怎么传数据还是怎么传,该怎么共享还是怎么共享,分级标签贴完就再也没人动过。
说白了,大家对数据安全分级的误解从根上就错了。
数据安全分级的核心:不是贴标签,是分责任配资源
很多人以为,数据安全分级就是把数据分成核心、重要、一般三六九等,贴个标签完事。不对。它的本质是给不同的数据匹配不同的防护成本,明确不同级别的安全责任。
核心原理说穿了很简单:你不可能给所有数据都上最高等级的防护。那太贵了,也完全没必要。就像你不会把家里的餐巾纸和现金放进同一个保险柜,对吧?
说个真实的案例,国内某头部新能源车企,前两年做数据分级踩过坑。一开始他们不分青红皂白把所有用户行车数据都标成核心数据,所有数据全量加密,所有访问都要走三重审批。结果呢?产品部门迭代智能驾驶模型的时候,取数据要等三天审批,研发团队怨声载道,安全投入直接超了预算两倍。
后来他们重新做了分级,同一个行车数据拆成了好几个子类:可识别到具体用户的实时轨迹数据是核心,去标识化的路况 aggregated 统计数据就是一般公开数据,用来训练模型的半匿名行为数据是重要数据。不同级别对应不同的加密强度、访问权限、存储位置。
改完之后,安全投入降了35%,研发取数据的效率提升了好几倍,去年过监管检查一次就过了。
不过话说回来,现在的技术边界也很清晰。市面上吹得神乎其神的自动分级工具,准确率能做到七成以上的都没几家。为什么?因为数据的敏感级别完全看业务语境。同样是11位数字,普通用户的手机号是个人敏感信息,企业公开的招聘电话就是公开信息,自动工具哪分得清这个?
现在整个产业链的格局也很有意思:原来做传统网络安全的厂商都在转数据安全,其中分级工具是第一赛道,光拿到融资的创业公司就有几十家。但大部分做的都是通用工具,能沉到行业里懂业务的没几个。金融要符合银保监会的监管要求,医疗要符合卫健委的规定,零售要贴合电商场景,一套工具走天下的时代早就过去了。
现在最大的落地障碍是什么?两个。一个是企业的数据太散,业务线多,数据孤岛严重,很多企业连自己到底有多少数据都搞不清,谈何分级?另一个是责任不清,分级本来要安全部门牵头,但是安全部门不懂业务,业务部门不想担责任,互相推,最后就只能做个纸面活。
还有治理层面的风险,不少企业故意把本该标成核心级别的用户敏感信息降级,就是为了方便内部流转甚至偷偷交易,去年被罚的好几家数据违规企业,都有这个问题。过度分级也坑人,把一堆无关紧要的数据标成核心,导致业务效率下降,反而让企业对数据安全产生抵触情绪。
未来三年,数据安全分级会变成什么样?
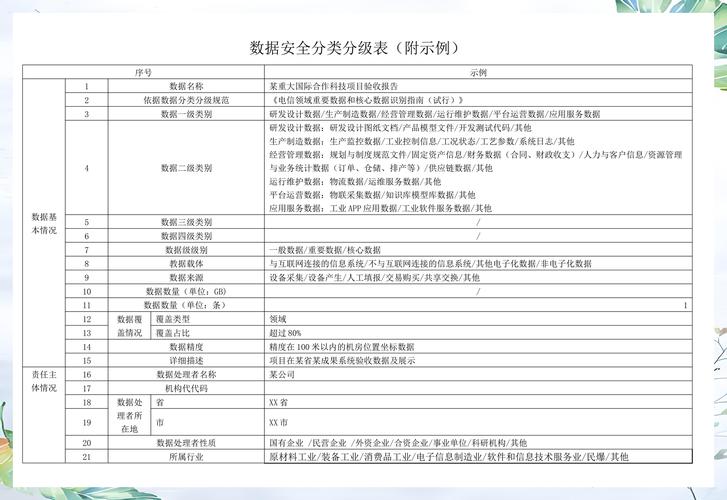
第一个变化,行业细分强制标准会很快落地。现在国家有通用的分级指南,接下来能源、医疗、金融、汽车这些重点行业,都会出自己的细分分级目录,哪些必须是核心,哪些是一般,给你划死,再也不能瞎填了。
第二个变化,大模型+人机协同会变成主流。全自动分级不可能实现,但是大模型可以帮着做初标,把同类型的数据先归好类,再由业务人员做最终调整,效率比纯人工高十倍都不止。现在已经有几家厂商在测试这个模式了,落地效果还不错。
第三个变化,数据分级会和数据交易、数据流通彻底绑定。以后你要进数据交易所交易数据,第一步就是过分级,什么级别能交易,需要做什么程度的脱敏,都按分级来,分级会变成数据流通的基础门票。
说实话,现在很多企业还把数据安全分级当成合规负担,再过三年你再看,它会变成企业数据治理的基础能力。你连自己手里的数据是什么级别都搞不清,谈什么数据开发、数据变现?
别再做纸面功夫了。真分,才能真安全,真省钱。
作者|大讲堂
排版|大讲堂
审核|见微