 大讲堂

热搜上的算力争议:你家显卡要被大佬薅羊毛了?
2026年开春,某头部大模型厂商发了一条招募微博,说要攒百万个人用户的闲置GPU,帮着跑大模型推理,按算力分红。直接冲了热搜第一。
一半骂这是黑心厂商薅普通人羊毛,一半蹲在评论区问怎么报名,终于能让我吃灰的3090回点血了。吵得很凶。
说实话,我当时刷到这条热搜第一反应是,这一天终于来了。吹了快二十年的分布式计算,终于从实验室的论文里跑出来,跑到普通人的电脑桌面上了。
前两年大模型爆火,所有人都挤破头抢训练卡,价格炒到天上,现在头部模型的训练基本做完了,推理成本反而卡了所有人的脖子。现在跑70B参数大模型的推理,集中式云算力每万token成本约1.2元,分布式闲时算力能压到0.3元以下,相当于一杯中杯奶茶的钱,够支撑一个小型AI应用跑整整一个月的日常推理请求。
这个差价,足够让所有玩家动心。对吧?很多人骂厂商黑心,想空手套白狼用普通人的算力。其实反过来想,你的显卡平时不也大部分时间闲着?你买个一万多的高端卡,大部分时候就是刷网页打游戏,硬件利用率不到10%。放着也是放着,跑起来能赚点奶茶钱,有什么不好?
当然,争议也真的存在。你把模型任务放到我的卡上跑,会不会偷我的本地数据?会不会一直满负荷跑把我的卡熬坏,三年质保都撑不到就报废?这些问题没人能拍胸脯给你保证。吵来吵去,绕来绕去,本质上不是技术够不够用的问题,是大家信不信这套分账逻辑的问题。
散出去的算力,收不拢的账
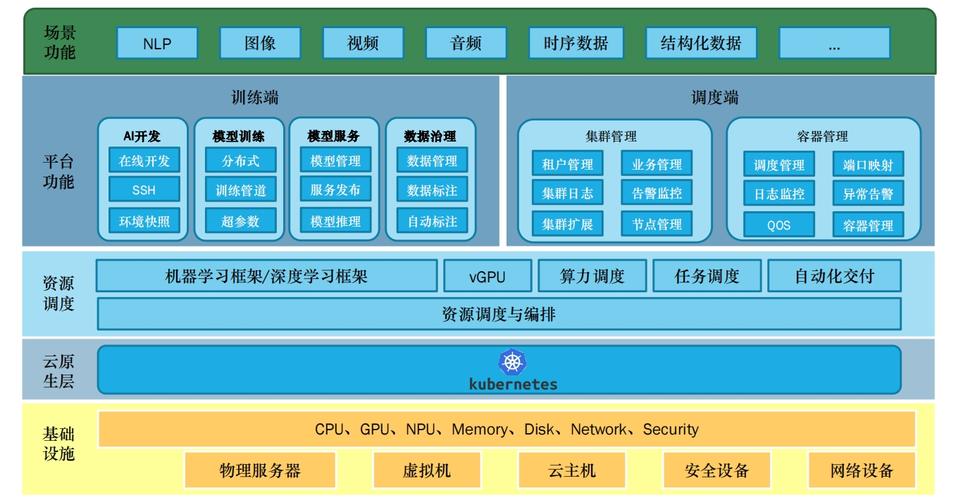
其实分布式计算的底层逻辑一点都不复杂。就是把一个大的计算任务拆成无数小块,放到N个不同的独立计算节点上同时跑,跑完再把结果拼起来输出。最早这么玩的是找外星信号的SETI@home,几百万用户自愿捐出闲置算力,纯公益项目,没人想着挣钱。
现在不一样了,所有人都盯着这块市场想分蛋糕。国内最早偷偷吃螃蟹的是字节跳动。早在2021年,字节就搭了自己的内部分布式算力调度网,把抖音、今日头条各个IDC节点的闲置算力,非峰值的时候匀出来给推荐算法迭代和大模型预训练用,省下来的算力成本一年就有十几个亿。
我拿到过一个行业内部统计数据,国内主流公有云区域,平日非峰值时段闲置算力占比普遍超过60%,其中仅阿里云华东区域的闲置算力加总,就相当于整个杭州市全年的居民生活用电量,全浪费了。这么大一块肥肉,谁看了不眼馋?
这场算力版图的重构,本质上就是从周王室垄断资源的井田制,转到了各家自主经营的分封制,算力的所有权和使用权拆分,话语权自然也就顺着资源走了。原来云厂商靠卖集中式算力赚得盆满钵满,现在你把社会上闲散的闲置算力打散了卖给需求方,动的就是云厂商的基本盘。
所以你看,国内现在做分布式计算做得最积极的,一边是缺算力缺到疯的大模型厂商,一边是手里握着大把边缘节点的三大运营商,反倒是头部云厂商动作很慢,天天只发论文不落地。为什么?自己砸自己饭碗的事,换你你也不着急干。
我见过不少创业公司,上来就吹自己的调度技术多么牛,能做到毫秒级切任务,能做到99.99%可用性。我就一句话,你把利益分配说清楚了吗?给普通节点的分红能不能实时结算?任务跑砸了损失算谁的?数据出问题了你赔不赔?这些问题没解决,技术再牛都是空中楼阁。这个方向我认为绝大多数创业公司都走偏了,天天卷技术指标,就是不敢碰最核心的利益分配问题。
每个节点都能分钱,这不是梦
不管既得利益者愿不愿意,分布式计算的口子已经撕开了,最先受益的就是产业链最底层的普通从业者和小创业者。
之前做AI应用,你要跑个百亿参数的模型,光是算力成本一个月就能烧掉十几万,小团队根本扛不住,只能给大厂做外包,做出来的产品稍微有点起色就被大厂摘桃子,累死累活一年赚点辛苦钱。现在呢?你去分布式算力池包闲时算力,成本直接降七成,小团队凑十万块钱就能做一年,够你试错十几次把产品磨出来,不用再看大厂的脸色吃饭。
对普通技术从业者来说,技能树的点法已经变了。原来做后端开发,你会在公有云控制台开节点搭集群,按厂商的文档调参数就行,现在不一样了,市场抢着要会做分布式算力调度的工程师,要会处理随机节点掉线,要会做跨节点数据隐私保护,现在行业里这类工程师的起薪,比传统后端工程师高出30%还多,根本抢不到人。
哪怕是普通的硬件爱好者,现在装机都不再是纯烧钱爱好了。装个高端显卡,平时自己打游戏剪视频,闲时挂个节点跑分布式计算任务,一个月赚个两三百电费,相当于免费玩高端显卡,这不比当年挖以太坊香?很多人说不安全,其实现在联邦学习加零知识证明的方案已经成熟了,原始数据根本不用出你的本地硬盘,你只是帮忙跑计算片段,拿到结果再传回去,根本碰不到用户的核心数据,自然也就谈不上泄露。
不过话说回来,现在这套模式确实还有一堆问题。节点稳定性不够,大任务调度有延迟,信任机制还没完全建立。但哪一个新技术刚出来不是这样?当年云计算刚出来的时候,所有人都说把数据放别人云上不安全,没人敢用,现在呢?绝大多数公司的核心业务都跑在云上。
再过三年,全球TOP500超级计算机的榜单里,会不会真的出现一个由十万个普通用户的闲置显卡拼出来的分布式超算?
作者|大讲堂
排版|大讲堂
审核|知知