 大讲堂

为什么要费劲搞类脑?现在的AI不好用吗?
ChatGPT出来之后,所有人都感叹AI进步太快。但是你知道训练一次GPT级别的大模型要花多少电吗? 有公开估算的数据,整个训练过程的能耗超过1亿度,抵得上一个普通县城整整一年的居民用电。 太夸张了。 我们的人脑,区区1.5公斤,满负荷运行一天也就耗掉不到半斤葡萄糖,换算成功率才不到25瓦。就能支撑你聊天、推理、写代码、认路,还能摸鱼发呆。 这差距,根源在哪?在冯诺依曼架构的天生瓶颈。我们现在用的所有芯片,都是存储和计算分离的,CPU算数据,得先从内存把数据搬过来,算完再搬回去。AI大模型要动用到千亿级参数,每次运算都要海量搬数据,90%以上的能耗都浪费在数据搬运的路上,根本省不下来。 现在芯片制程已经摸到物理极限了,摩尔定律变慢,靠堆晶体管降功耗这条路快走到头了。 那怎么办?有人想到了,我们直接照着人脑的方式造芯片不行吗?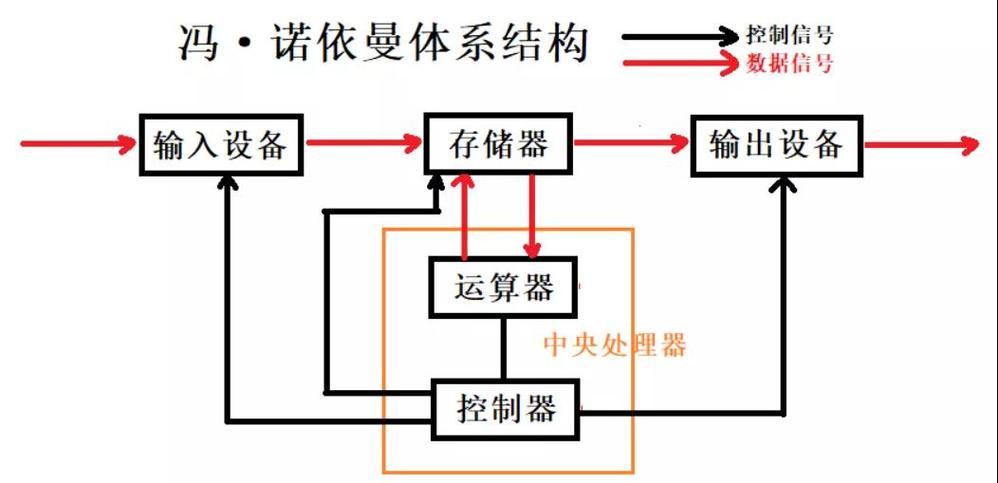
类脑计算到底是什么,它的边界在哪?
很多人一听类脑,就觉得我们要造一个人造大脑出来,要产生意识,那是科幻。 现在我们说的类脑计算,核心其实就是两个方向:要么是结构类脑,模拟人脑神经元和突触的连接方式,用脉冲信号编码信息,也就是业内说的脉冲神经网络,神经元只有收到足够多的脉冲才会激活,大部分时候都是休眠的,天然就是稀疏激活,功耗自然低。要么是功能类脑,借鉴人脑的认知机制,比如无监督学习、动态推理这些,优化现有的AI算法。 它不是要替代现有AI,更不是要直接造出来一个和人一样的智能。它解决的核心痛点,就是低功耗场景下的AI推理问题,这是它的技术边界,别瞎吹。 现在的瓶颈也很明确。硬件上,模拟突触的核心器件忆阻器,良率一直上不去,大规模集成的成本还很高,没法像GPU那样量产。软件上,脉冲神经网络的训练方法还不成熟,效果现在还打不过成熟的深度学习,生态也差,没有现成的开发框架,开发者太少。 不过话说回来,这条路方向是对的,只是走起来需要时间。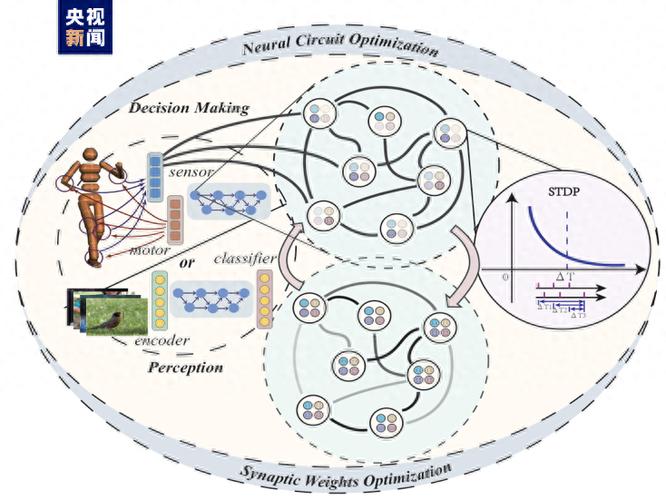
产业现状:哪些玩家下场了,落地在哪?
未来三五年:别等革命,先看补位
作者|大讲堂
排版|大讲堂
审核|满满