2026-09-17 13:35:53 分类:科技
大模型厂集体砍单,算力走到悬崖边了
2026年开春,圈内传的最疯的消息不是GPT-6要上线,是国内三家TOP级大模型厂商集体砍了英伟达的新订单。
钱挪地方了。
挪了大概12%的年度算力资本开支,给了名不见经传的神经形态计算原型项目。说实话,我刚听到这个消息的时候,第一反应是资本又要炒新故事割韭菜了?直到上个月跟某厂算力负责人吃饭,他拍着桌子给我算帐,我才醒过来。
训练一个GPT-4级别的多模态大模型,整个周期消耗的电力,相当于一座120万人口的中型城市整整一个月的居民生活用电量。
就这,还得抢得到英伟达的芯片,一张H100拿货价炒到四万美金,你拿多少钱堆,都赶不上参数增长的速度。摩尔定律死了快十年,大家靠着堆核心堆缓存硬撑,现在撑到3nm,再往下堆,成本涨得比性能快三倍,谁顶得住?
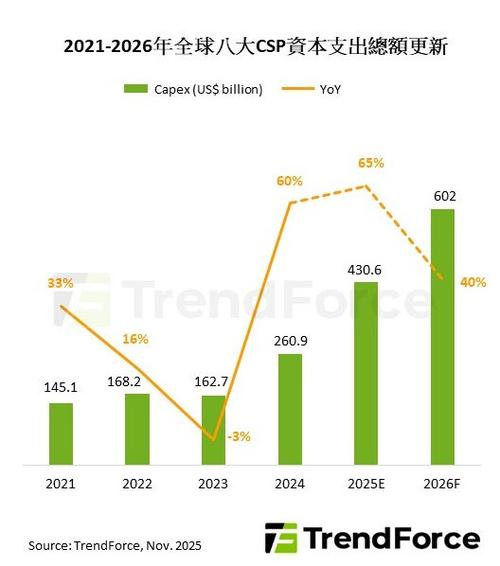 2026年全球大模型厂商算力资本开支结构统计图
现在所有做AI的都在裸奔,赚的广告费、API钱,连算力成本的零头都覆盖不了。资本不肯再给烧钱了,厂商只能找新路。与其说大家主动押注神经形态计算,不如说被冯诺依曼架构逼到墙角,不得不找出口。对吧?
模仿人脑不是炫技,是产业逻辑的重构
很多人一听神经形态,第一反应就是“模仿人脑,实验室里的黑科技,离商业化远着呢”。其实不对,国内已经有厂商落地赚钱了。
清华系出来的灵汐科技,做第三代天机芯神经形态芯片,去年已经给国网批量供应边缘电力监测模块,用来做线路故障的实时AI预测。相同的推理任务,功耗只有原来用的ARM芯片的八分之一,已经实打实跑了上万台设备。
底层逻辑说穿了其实很简单,我们用了七十年的冯诺依曼架构,天生就是“计算”和“存储”分开的,数据要在两个模块之间来回跑,跑一次就耗一次电,90%的功耗都耗在数据搬送上了。神经形态走的是另外一条路,模仿人脑的神经元和突触,把计算和存储做在一起,也就是存算一体,数据不用跑,直接在存储的地方就算完了,功耗自然降下来。
相同的终端AI推理任务下,神经形态芯片的功耗只有传统GPU的1/200,推理速度快150倍,但目前量产良率只有传统硅芯片的62%,单颗成本比同规格GPU贵2.7倍。这就是现在尴尬的地方,技术方向对,但成本还没打下来。
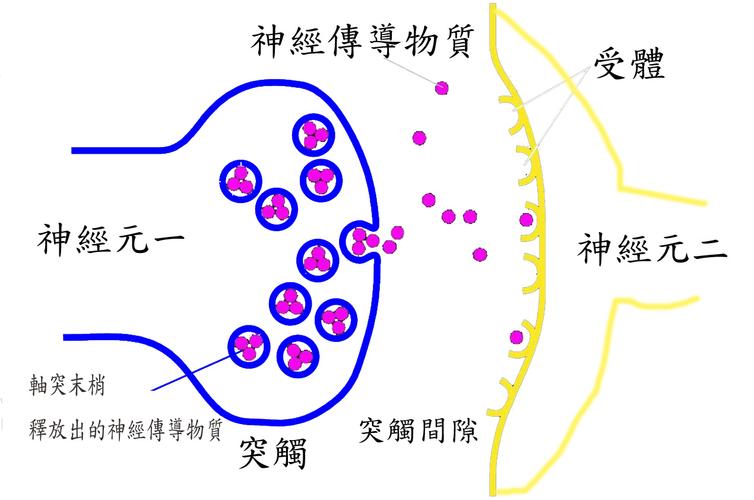 神经形态芯片人脑突触模拟原理示意图
这个事儿其实很像生物进化。冯诺依曼架构就是当年称霸地球的恐龙,体型越长越大,耗能越来越高,遇到大模型算力需求爆炸这个“小行星”,已经扛不住了。神经形态就是当年躲在洞穴里的小型哺乳动物,个子小,耗能低,看起来不起眼,但是刚好适配新的环境,等恐龙倒下,自然就能接管天下。
不过话说回来,现在国内做神经形态的厂商,不止灵汐,还有中科院微电子所背景的几家创业公司,都在偷偷往下游落地,没人愿意大张旗鼓炒作。一方面是怕被资本捧杀,另一方面,大家都清楚,生态不在自己这儿,现在喊得越大声,死得越快。当年GPU起来的时候,不也是偷偷给AI做算力,慢慢把生态换了?我反倒觉得,现在闷头干活的,才是真玩家。那些喊着“颠覆GPU”的,基本都是PPT圈钱的。
对普通从业者的影响,比你想的来得快
 对普通从业者的影响,比你想的来得快
很多人觉得,神经形态计算是上游芯片厂商的事儿,跟我一个写算法的、做产品的有什么关系?
太有关系了。
先说芯片设计工程师,原来做冯诺依曼架构积累的那套EDA流程、验证方法,一半以上不适用了。神经形态芯片靠的是稀疏脉冲触发,不是原来的时钟同步,设计思路完全变了。现在国内头部的几家神经形态厂商,开出来百万年薪找懂脉冲神经网络设计的工程师,找不到人。未来三年,这个缺口至少十万个,你现在转,还能吃第一波红利。
再说到做算法的朋友,现在大模型都在往端侧走,手机、汽车、IoT设备都要放AI,原来云端那套大模型,砍了又砍才能塞进端侧,功耗还降不下来。神经形态芯片天生适合低功耗端侧AI,接下来两年,会有大量的算法适配需求,原来做大模型裁剪、轻量化的朋友,早点去了解脉冲神经网络,绝对不吃亏。
我也说句难听的,现在行业里已经一堆浑水摸鱼的,把存算一体换个包装就叫神经形态计算,拿着PPT融几个亿,转头就割一级市场的韭菜。普通从业者找工作,或者创业者找方向,别碰那种只有原型没有落地订单的公司,都是炒概念。说白了,现在这个阶段,能在边缘端赚一块钱,比吹一百亿的市场空间有用多了。
对产业链上的代工厂来说,现在主流的神经形态芯片很多用RRAM阻变存储器做突触,和原来的CMOS工艺不一样,国内中芯国际已经在给几家头部厂商试产新工艺,接下来两年,相关的工艺岗位缺口也很大。
当算力终于不用靠堆硅片堆出来的时候,第一个被淘汰出局的,会是谁?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:神经形态计算不是AI新故事,是冯诺依曼架构的终点
文章链接:https://m.lfdjt.com/info_23_20284.html
 大讲堂
