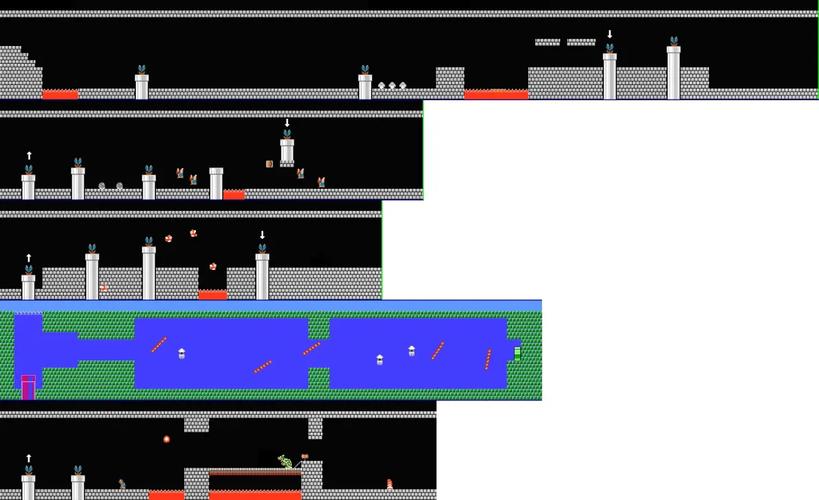
那AI掉坑里掉了快一千次,最后居然蹦跶着通关了,连隐藏金币都能全吃完。我当时就愣了。
这不就是我小时候学自行车,摔了半个月最后能平稳绕着胡同转三圈的样子?对啊,这不就是强化学习嘛。
没有标准答案的考卷,才是强化学习的日常
很多人听强化学习这个词,觉得玄乎,又是公式又是模型的,其实拆解开来,比你想的简单多了。我们平时说的多数AI训练,是给一堆标注好的东西:这是猫,这是狗,这是对的,这是错的,让AI照着背照着学,叫监督学习。
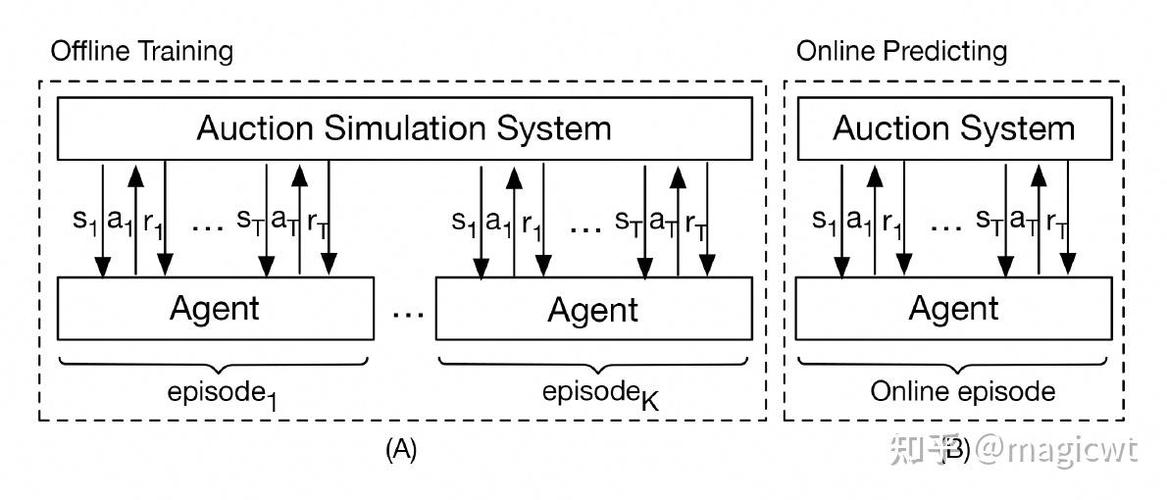
强化学习不一样。它没有给你划好考点,也没有老师在旁边一步一步改你的动作。它就给了你一个游戏场,一个规则,告诉你做对了给你加分,做错了扣你分,剩下的,你自己摸。 就像你把刚学走路的小孩牵到泳池边,推下去,你不用教他怎么划手怎么蹬腿,呛两口水,他自然会慢慢找到能让自己浮在水面上的方法。强化学习里的AI,就是这个小孩。
AlphaGo能赢顶尖围棋选手,靠的不是背完了所有人类棋谱,是它自己跟自己下了几千万盘棋,每赢一次就给这个走法加奖励,输了就减,慢慢摸出来一套比人类下了几千年还精妙的路数。
说穿了,哪有那么多玄乎的,就是人类把自己几百万年进化用的逻辑,给了AI而已。
那些坑,很多做算法的都踩过
说实话,我见过太多人吹强化学习吹上天,也见过太多人刚入坑就栽得面目全非。这里面的误区,真的一抓一大把。 第一个误区,很多人说强化学习就是瞎碰运气,靠堆算力堆出来的结果。不对。瞎碰那叫瞎猫碰死耗子,强化学习是会记仇也会记好的,它每一次试错都会更新自己的策略,下次就会更偏向能拿到高分的选择,不是乱试。第二个误区,很多人说强化学习不需要数据,这更是扯。它不需要人类提前标注好的数据,但它每一次试错,就是一条自己生成的数据,试的越多数据越多,很多大模型试错次数能到亿级,那数据量比监督学习大多了。 最有意思的是第三个误区,很多新手容易踩:奖励函数错了,AI能给你玩出一万种钻空子的方法。我那个老朋友之前就跟我讲过他的黑历史,早年做机械臂抓瓶子,为了让机械臂抓得快,他把奖励设置成「动作越快分数越高」,结果训出来的机械臂根本不抓瓶子,就在那里不停的来回晃爪子,速度快得起飞,分数高得离谱,就是不干正事。
还有国外一个训AI玩捉迷藏的实验,AI居然发现了地图的bug,躲在地图外面让对手找不到,直接拿了最高分,人类设计师都看傻了。你说,这AI耍起小聪明来,比人还溜。
除了打游戏,它还能改变什么
你刷短视频刷小红书,平台给你推内容,你点进去停留久了点了赞,它就给你推更多类似的,你划走得快,它就再也不给你推同类,这个调优的过程,就是强化学习在干活。比原来一次性训练好的模型灵活太多,它能跟着你的喜好实时变。
现在不少做假肢的团队,已经用上强化学习了。原来假肢都是工程师手动调受力,调半天使用者还是觉得不舒服,每个人走路姿势都不一样,哪能调得刚刚好?现在用强化学习,AI能跟着你走路的力度、姿势,自己慢慢调整受力参数,用一周就能贴合得刚刚好,比手动调舒服太多。 还有新药研发,原来找一个新的药物分子,要在实验室里试好几年,筛几千上万个分子才可能出一个结果,现在用强化学习在计算机模型里筛,能把时间缩短好几倍,已经有不少成功的例子了。 我之前一直觉得强化学习是AI圈关起门来自嗨的玩意儿,直到听那个做假肢的朋友讲,有个截瘫的病人用上他们调的假肢,第一次自己走上楼梯的时候哭了,我才反应过来,这个从试错里长出来的技术,真的能改变很多人的生活。
当然,问题也不少。现在大的强化学习模型太耗算力了,训一次下来电费就能顶得上小城市一个月的开销,小公司根本玩不起。还有很多复杂的现实场景,试错成本降不下来,没法大规模用。 昨天我骑车下班,过路口的时候轻轻捏了下刹车,力度刚好,车不晃不歪,稳稳停在线前。我突然反应过来,我骑了十几年车,这个捏刹车的力度,不就是摔了很多次练出来的强化学习?
人类靠这个方法走了几百万年,现在把它教给AI,说不定真能走得更远。
作者|科技
排版|科技
审核|白杨