2026-10-01 03:49:07
作者:
科技
早上醒过来摸手机,对着屏幕说:“帮我把昨天拍的桂花落了一地的照片调亮,配一句不矫情的秋分文案,直接生成朋友圈图。”三十秒出图。你不用开修图APP调半天亮度,不用搜文案搜十分钟,更不用把图导来导去。
这不是什么黑科技魔术。
是多模态大模型,已经偷偷蹲在你手机里了。
以前的AI都是偏科生
我刚玩AI的时候,吐槽过一件事。要处理一张图,得打开专门的识图APP;要写文案,得切到聊天机器人;要转语音,还得开第三个工具。每个工具都只会干自己那点活,你让识图APP给图写个文案,它直接给你蹦出来“这是一张猫的照片”,就没下文了。
就像偏科的学生,语文考满分,数学连选择题都做不对。
这就是以前的单模态AI,只能处理一种类型的信息——要么只认文字,要么只看图片,要么只听语音,各干各的,互不相通。
 早期单模态AI分工场景示意图
那时候要完成一件跨领域的事,全得你自己当那个粘合剂,把不同工具的输出拼到一起,累不累啊。
多模态的“多”,到底是什么意思
说人话,就是这个模型从训练开始,就同时学了好几种不同的“语言”。它不光认得文字里的逻辑,还看得懂图片里的颜色、结构、场景,听得懂语音里的情绪,甚至能把这些东西串起来理解。
你给它发一张我家猫睡在我笔记本键盘上的照片,问它“我为什么没法好好干活”,它不会只告诉你“这是一只猫”,它能看出来猫把按键全压住了,你根本敲不了字,还能给你补一句“建议拿猫条拐走,不要硬刚”。
说实话,第一次试这个的时候我笑了十分钟。
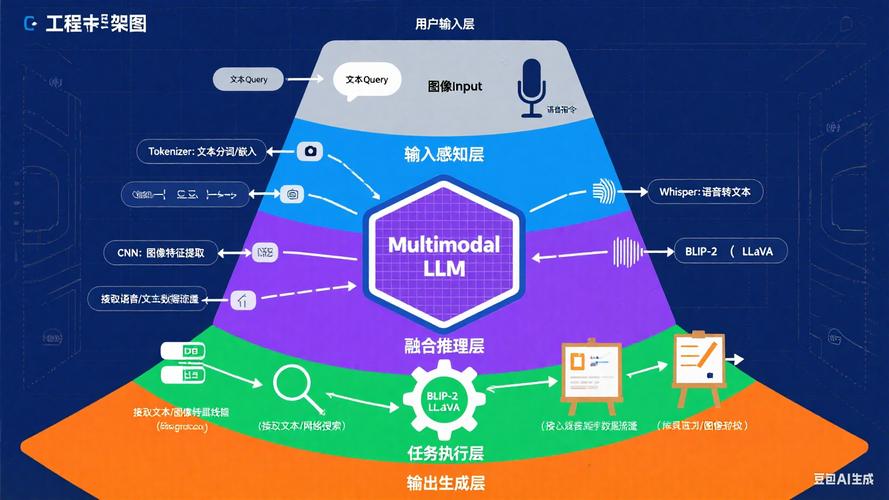 多模态大模型用户交互场景示例
很多人说这不就是把几个模型拼在一起吗?不对。真的多模态大模型,是从训练底层就把文字、图片、音频这些不同类型的信息混在一起学,神经元长在一起,不是外头套个壳拼积木。拼出来的模型,你问它“这个图里的红色配什么颜色好看”,它只会告诉你红色的参数是多少,不会真的结合图里的场景给你出搭配方案。
别被营销话术吹晕了,现在的多模态还没那么神
 别被营销话术吹晕了,现在的多模态还没那么神
我刷短视频见过不少吹多模态的,说什么已经能替代设计师替代摄影师,全是扯淡。
现在绝大多数民用多模态产品,还处理不了太复杂的跨模态需求。我前阵子手画了一张我家户型图,歪歪扭扭的,让AI给我出个衣柜设计,它把我留的门洞给堵上了,错得离谱。
还有一次,我让它结合我拍的紫金山秋景图,写一句带南京鸭血粉丝汤的文案,它给我写出来“鸭血粉丝汤顺着山坡流进了树林”,什么鬼啊。
说白了,它能懂常见的场景,能应付普通人的日常需求,但是稍微偏门一点,逻辑绕一点,它就露馅。
不过话说回来,用来对付日常的小需求,真的够用了。你想做个手机壁纸,想给朋友圈图配个文案,想识个图找个同款,这些小事它做得比你快多了。
现在很多手机的相机相册,已经集成了多模态的能力,你搜“去年吃火锅的照片”,不用给照片打标签,它就能给你找出来,因为它能看懂每张图里是什么内容。线上看展的时候,AI讲解员能对着你指的那幅画,给你讲细节,也是多模态在干活。
它不是远在实验室的概念,是你每天都在用到的东西,只是你没注意而已。
我有时候会想,多模态最大的改变是什么?不是AI变得更能了,是我们用AI不用再学怎么跟AI说话了。以前你得抠关键词,得说规范的话,AI才懂,现在你怎么说话就怎么问,带图带语音都扔过去,它就能懂。
这才是真的把科技藏在生活背后了对吧。
昨天我下班路过颐和路,捡了一片黄透的梧桐叶,拍了照给AI,说帮我做个简约的手机壁纸,配一句符合今天心情的话。它给我出的图里,叶子放在灰底色中间,文案是“今天摸鱼,捡了一片秋天”。
挺对我胃口的。
不用吹什么改变世界,这种小小的方便,已经够棒了。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:当AI能看懂图听懂话还会画:你身边的多模态大模型
文章链接:https://m.lfdjt.com/p/keji/a/5155.html