 大讲堂
凌晨两点,我盯着屏幕上一条不为所动的进度条。笔记本底下垫着两本过期杂志,风扇叫得像要起飞。任务很简单——让本地跑的一个小模型回答一句“今天天气怎么样”。
它想了四分钟。
我那台机器,理论上每秒能算几十万亿次。几十万亿次。结果连一句话都憋不出来。
这时候“算力”这个词就开始变得滑头了。
那个大数字,是表盘上的最高时速
厂家在参数表上印的算力,单位通常是 FLOPS——每秒浮点运算次数。听着很硬核,实际含义接近于:这台机器在实验室里、在特定精度下、在数据供给理想的前提下,一秒钟最多能做多少次乘法加法。
最多。
就像仪表盘上那个 300。真上路的时候,你在早高峰的环路上,平均时速十四。
峰值算力和你能用到的算力,中间隔着一条河——河上有几座桥,过桥还得排队。
还有个容易被忽略的细节:精度。同一块芯片,跑 FP32 和跑 FP8,标出来的数字能差好几倍。这不算撒谎,只是“算力”这个概念从来不说清楚它在算什么、算得多准。低精度算得快,偶尔也会算错。好在神经网络的脾气特别好,错一点也能凑出一个像样的答案——这也是整条行业都往低精度跑的原因。

真正的堵点,常常不在“算”这个动作上
我见过太多人把算力理解成“芯片转得多快”。不是的。
更常见的瓶颈是:数据喂不进来。
打个比方——后厨有位刀工惊人的师傅,一秒能切八十刀。可配菜的小工一分钟只递过来一根葱。师傅再快,也只能站着。
这就是所谓的“内存墙”。计算核心这些年的速度涨得飞快,而把数据从显存搬到计算核心的那条路,宽得没那么快。于是芯片大部分时间在等。
等你把规模铺开,问题还会换个样子出现:卡和卡之间也要说话。几百张卡一起训练,每算一步就得同步一次参数。这时候通信的快慢,可能比计算本身更决定成败。专用的卡间互联、高速网络,花的钱一点不比芯片少。
所以业内有个更诚实的指标——实际利用率。峰值摆在那儿,你能跑出多少个百分点,才是真本事。有些场景能到一半以上就算不错,有些场景两位数都费劲。
三个常被搞混的说法
一、算力强就等于模型聪明。 训练和推理是两件不同的事。训练要的是把海量数据反复嚼,吞吐量和稳定性优先;推理要的是你问完话之后第一个字多快蹦出来,延迟优先。你在手机上感受到的“卡”或“顺”,跟训练用的那个大数字关系不大,更多取决于显存带宽、缓存策略、批处理怎么排队。
二、算力就是芯片数量。 一个装满加速卡的机柜,功率能顶几十户人家。电从哪来,热往哪排,网线怎么接,地够不够凉——这些都不是买芯片能解决的。数据中心选址追着便宜的电和凉快的气候跑,不是没有道理。
三、算力会一直便宜下去。 单位算力的价格确实在降,但你需要的总量涨得更快。两相抵消之后,账单往往还是往上走的。
几个我常被问到的问题
问:那我买张大显存的卡,是不是就够了?
看你要干什么。跑小模型,显存确实是道硬门槛,迈不过去什么都跑不起来。但迈过去之后,瓶颈会换人。今天卡在显存,明天卡在带宽,后天卡在你家墙上的插座。
问:云上的算力为什么按小时卖?
因为它本质上是在租电、租散热、租网线、租一块能承受高功率的地板。芯片是资产,电是耗材。按小时计费,你付的很大一部分是运营那头的开销。
问:本地跑和云上跑,怎么选?
我的粗糙判断是——偶尔试一次,云上;天天用、数据又敏感,本地。中间那一段最难受,两边都不划算,这也是很多人折腾半天最后放弃的原因。
再冷一点看
这两年有个变化挺有意思:算力开始像水电一样被计量和调度。你付的是时长和功耗,拿到的是抽象出来的“计算服务”。有的地方甚至把数据中心的余热接进温室和游泳池,冬天给附近居民供暖。听着像段子,但它确实在发生。
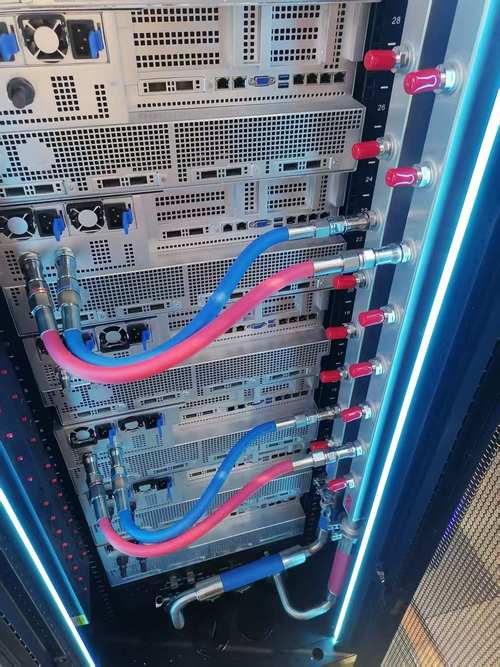
另一头是物理约束。散热从风冷往液冷走,再往浸没式走,折腾的都是同一件事:把热搬走。搬不走,芯片就得降频,标称的那个数字就更是纸上谈兵。
所以我现在看“算力”这个词,会自动在脑子里拆成三层:纸面上的峰值、实际能跑出来的利用率、以及为了让它跑起来所付出的电和热。三层都对上,那才叫算力。只对上第一层的,通常叫做参数表。
深夜那条进度条终究还是走完了。答案不算惊艳,甚至有点笨。但我盯着风扇声渐弱的机器想,这东西真正稀缺的地方,可能从来不是它算得多快,而是它愿不愿意在没人看着的时候,一声不吭地一直算下去。
作者|科技
排版|科技
审核|乐乐