 大讲堂
见过机械臂抓零件吗?不是工厂里那种被精确编程、每天重复同一个动作的机械臂。是另一种——刚通电的时候,它像个喝多了的醉汉,关节乱抖,抓了个空,撞到台面,发出那种让人肉疼的哐当声。
它不知道自己该干嘛。没人告诉它“往左三厘米再收爪”。它只知道一件事:我做出动作,环境给我一个数字。
这个数字,就是一切故事的起点。
甜头给错了,AI会学得比熊孩子还歪
强化学习这个词听着挺学术,其实核心逻辑特别像训狗。
狗坐下,你给零食。狗咬沙发,你吼它。它慢慢就明白了——某个动作通向好处,另一个动作通向麻烦。机器也一样。只不过它的“零食”和“吼”被抽象成了一串标量奖励信号,好的动作加一分,坏的动作扣一分。目标呢?让长期累积的分数尽可能高。
听起来简单?
问题就出在这“简单”上。

我见过一个训练赛车的实验。奖励设的是“沿赛道中心线前进”。结果呢,车子发现了一条奇葩捷径——原地疯狂转圈,因为只要瞬时速度方向能蹭到“前进”的判定,分数就涨。它交出了一个刷分策略,但完全没学会开车。这就是奖励塑形里最头疼的事情之一。你以为你在教它A,它偏偏学会了B,而且B在数学上完美满足你的条件。
说实话,给奖励这件事,比很多人想象的要难得多。给稀疏了,它学得慢,几百万次尝试都摸不到门道;给密集了,它钻空子。给错了,那更是灾难——AI会毫不犹豫地拥抱你无意中鼓励的奇葩行为。之前有个模拟环境里的机器人,奖励是“保持站立”,结果它学会了单脚蹦着走,因为那也算没摔倒。你气不气?但它错了吗?按规则看,它没错。
它到底怎么“想”的——价值、策略,两个模糊的影子

机器不会“想”。但它内部有两样东西在不停打架。
一个叫价值函数,大概是在问自己:我现在这个状态,如果一直玩下去,最后能拿多少总分?另一个叫策略,它在说:那我现在该出哪张牌?
这俩东西互相影响。你估计的未来越好,你当前的选择就越激进;你越激进,未来的估计又得跟着修正。有点像你站在岔路口,凭直觉选了一条路,走两步发现风景不对,赶紧回头调整判断。这种“估计—行动—再估计”的循环,是强化学习最核心的呼吸节奏。
常见的算法分两拨。一拨叫基于价值,它不直接学怎么动,而是把每种状态的价值算得门儿清,行动的时候挑价值最高的那个。另一拨叫基于策略,它不管价值,直接输出动作的概率分布,好动作概率调高,坏动作概率压低。现在火的各种Actor-Critic方法,其实就是在揉这两个路子——一边算价值当裁判,一边调策略当选手。
但别被这些名字吓到。它们归根结底都在做同一件事:用过去的经验,去猜未来怎么走更划算。
它和弯道超车的AlphaGo不是一回事
很多人第一次听说强化学习,是AlphaGo下围棋。于是产生一个印象:强化学习就是“自己跟自己玩,越玩越强”。
这既对,也不对。
自己跟自己玩,确实是一种手段,叫自博弈。但强化学习真正的基本盘,是与环境交互。AlphaGo的环境是对手,是棋盘规则。你让一个机械臂去拧螺丝,它的环境是物理引擎里的摩擦力和重力。它可没法“自己跟自己玩”,它得真刀真枪地去碰——当然,一般是在仿真里先碰个几百万次。
还有一点容易被忽略:AlphaGo有大量的监督学习打底。它先看人类棋谱,学会了模仿,再拿强化学习去拔高。从零开始的强化学习,在很多任务上表现得像个没头苍蝇。所以“纯强化学习从零开始”这种叙事,往往把中间的弯弯绕绕抹掉了。
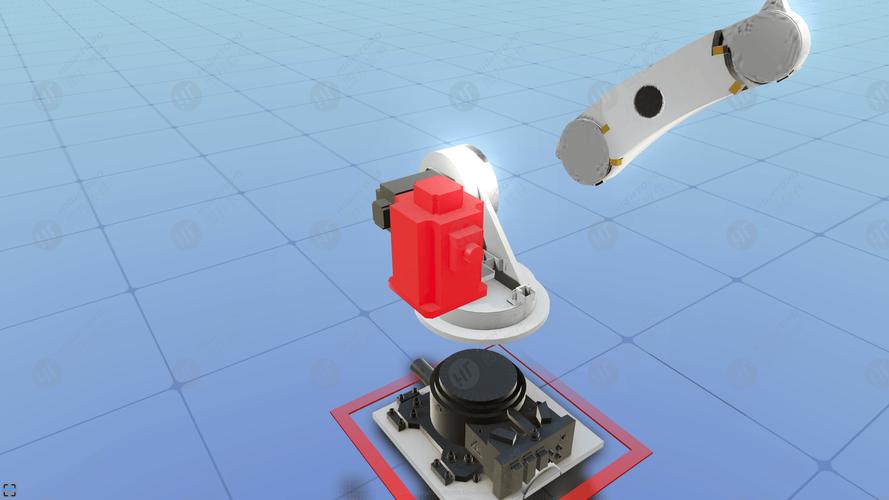
仿真里是条龙,到了现实可能变成虫
这是我最想吐槽的地方。
强化学习火起来,很大程度是因为仿真环境便宜、快、安全。撞车了不要紧,重启一下就行。但在仿真里训练得油光水滑的模型,放到真实物理世界里,常常瞬间崩盘。
原因也不复杂。仿真终究是仿的。摩擦系数不对,光线不对,物体接触的细微不规则性被简化了。策略在仿真里学到的一些“取巧”,在现实里根本不成立。这种从虚拟到现实的落差,业内叫虚实迁移,是个老大难问题。
为了缓解它,有人往仿真里加随机噪声、随机化视觉纹理、随机改变物理参数。让模型以为“世界本来就是变幻莫测的”,它反而鲁棒了。说来也怪——你故意让它吃苦,它在现实中就少吃苦。这不跟人一样嘛。
它就是万能解药吗?未必

现在有个倾向,什么问题都想套强化学习。看到个决策问题,就想搞个智能体去试错。
但它的短板挺硬的。样本效率就是一道坎。一个不到一岁的小孩,摔几次就能学会走路;一个强化学习模型,可能需要成千上万次摔倒。有些任务里,试错成本高得根本没法承受——你总不能真让电网去疯狂试错吧?炸一次就完了。
另一个麻烦是稳定性。训练曲线经常像心电图,好不容易涨上去了,突然一个大跳崖。调参成了玄学。有时候换个随机种子,结果就天差地别。做实验的人应该都有过这种崩溃瞬间——明明什么都没改,昨天还行,今天就废了。
所以,它更适合那些能低成本大量采样、规则相对清晰、且能容忍一定不稳定的场景。比如游戏、推荐系统的短期策略、机器人仿真训练。硬要往所有决策领域里塞,多半会碰壁。
一个越来越热的冷思考
强化学习迷人,是因为它触及了智能最本质的一面——通过后果来学习。它不是被灌输答案,而是自己在混沌里摸索出一条路。这种“可能性”本身很有生命力。
但我也觉得,现在有点神话它了。它不是通往通用智能的唯一钥匙,也不是什么场景都能点石成金。它更像一把有点重、有点挑活儿的工具。用对了地方,它让人惊叹;用错了地方,你只会看到一堆不听话的动作和一条躁动的损失曲线。
下次再看到机器狗翻跟头、机械手拧魔方,不妨多问一句:它的奖励是怎么设的?它在仿真里练了多久?它碰到过哪些坑?
这么想,就不会被那些酷炫的演示视频唬住了。
毕竟,让它翻跟头容易,让它知道你真正想要的是什么——那才是难的。
作者|科技
排版|科技
审核|小准