 大讲堂
凌晨两点。我让它帮我把一段正则表达式改成人能看明白的样子,顺便解释每个分组在干嘛。
它两秒钟就给了答案。前面几行完全正确。再往下,它编了一个根本不存在的函数名,还煞有介事地写了参数说明。
那一刻我的表情大概很复杂——既想骂人,又有点佩服。这东西怎么会一边聪明一边糊涂?后来我花了挺长时间去搞清楚它内部到底在干什么。搞明白之后,那种违和感反而消失了。因为它的聪明和糊涂,来自同一个机制。

它不是在查资料,是在赌下一个字

很多人脑子里的画面是这样的:一个巨大的数据库,AI 在里面检索最匹配的答案,抄出来给你。
不是。差得挺远。
生成式AI做的事情,朴素得有点让人失望——它拿到你输入的文字,算出下一个字最可能是什么,写上去,再拿这一整串重新算一遍,再写下一个字。如此循环。一个词一个词往外蹦。你看到的那段流畅回答,本质上是几百次连续的小赌局串起来的结果。
也正因如此,它对“事实”没什么天然的敬畏。它关心的只有一件事:在当前这段上下文里,哪个字接上去最像那么回事。
函数名、判决书里的案号、论文的引用页码——在这些地方,“像那么回事”和“真实存在”之间的距离,可以无限远。它不坏,是它压根没被设计成一台查证机器。
谷歌在 2017 年那篇讲 Transformer 架构的论文里提出的注意力机制,后来成了绝大多数主流大模型的底座。它解决的问题很实在:一句话很长的时候,哪个词该跟哪个词绑定关系?注意力机制算的就是这个相关性权重。这套东西让模型能处理长句子、能理清指代,也让它在你看不见的地方把概率算得越来越细。
顺便说一句,写“注意力机制”这四个字的时候我其实有点纠结。它听起来像某种心理学概念,实际上是一堆矩阵乘法。名字起得挺唬人。
温度这个参数,比你以为的重要得多
同一个问题问两遍,答案不一样。有人觉得这说明 AI 有灵性,有人觉得这是故障。
都不是。这是采样。
模型算完那一步,得到的不是一个词,而是一整张概率表。比如“今天天气”后面,可能是“不错”“很热”“一般”“糟糕”……每个词后面挂着一个数。怎么从这张表里挑,取决于一个叫温度的参数。
温度调低,它几乎总挑概率最大的那个。回答非常稳,也非常无聊,问十次十次一个样。温度调高,概率低的词也有机会被选中——创造力上来了,胡说八道的概率也跟着上来了。
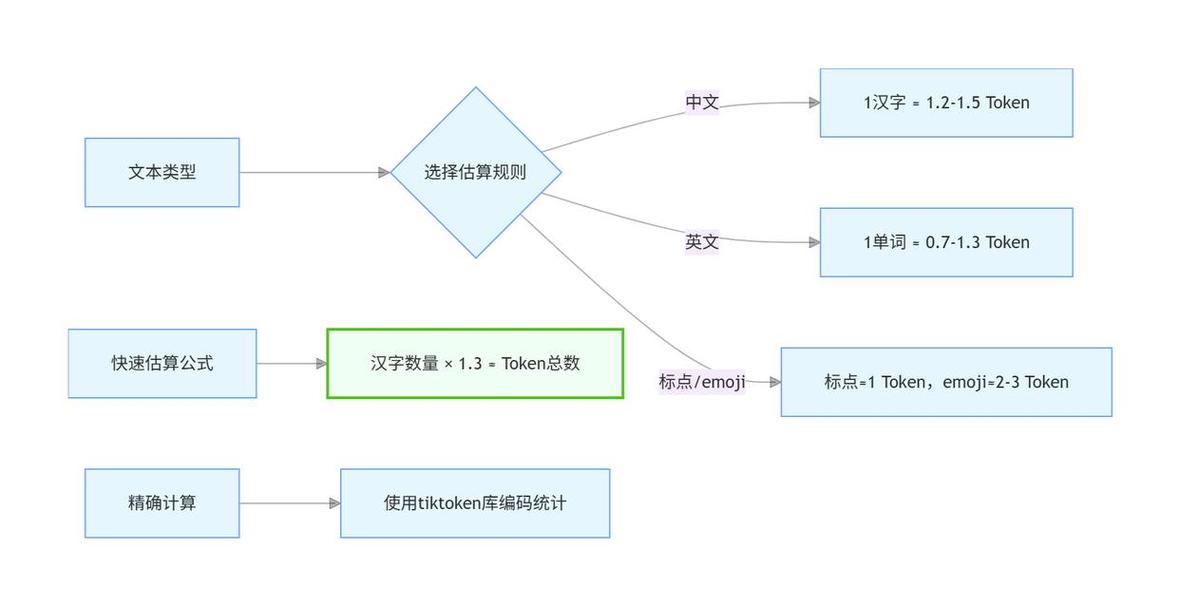
所以那些看起来忽冷忽热的表现,很多时候不是模型变了,是采样策略变了。你在网页端用某个默认设置聊天,和工程师在后台用温度 0 跑批处理,得到的是两种气质完全不同的东西。
我头一回知道这件事的时候有点失落。原来所谓的灵光一闪,是一张概率分布表换了个挑法。
它记不住你,真的记不住
一个特别常见的误会:用户以为对话框记得住上次聊过什么,于是第二十轮的时候问“你刚才说的那本书叫什么”。
然后它答错,或者干脆现编一个。
根本原因是,模型本身没有记忆。它是无状态的。每次你发一句话过去,系统都要把之前所有对话重新拼成一个长字符串,一起喂进去。这个字符串有个上限,叫上下文窗口。
窗口塞满了怎么办?早期做法是从最前面开始丢。于是你开头跟它交代的那些前提条件、身份设定、格式要求,悄悄地就滑出去了。它的表现随之变差。你会以为是它今天不太聪明,实际上是它已经把你说过的话忘了。
这事还有个反直觉的地方:上下文窗口长,不等于它用得好。处在中间位置的信息,模型经常视而不见。业内有人把这种现象叫做“迷失在中间”。你把一份几万字的合同丢进去,关键条款恰好落在正中间那一块,它漏掉的概率并不低。
所以真正靠谱的用法是:重要的约束条件,尽量放在对话的开头或者结尾,别埋在中间。这条经验没什么技术含量,但省了我不少事。
幻觉不是故障,是副产品

有人问,能不能从根上把编造这件事干掉?
目前看,很难。让模型生成流畅文本的那个机制,和让它编造事实的机制,在底层是同一个。它在做概率补全,不是在做真值判断。你让它别瞎说,它学会了在某些情况下加一句“我不太确定”,但这不是它真的知道了边界在哪,只是它见过很多人在这种语境下这么写。
工程上真正管用的办法,都是在模型外面动手:给它接检索,让它先查资料再回答;让它输出之前先分步推理;让另一个模型来检查它的输出。所有这些,说白了都是在给一台概率机器加外部护栏。
我试过让它自己核对。效果一般。它经常一边说“我检查过了,没问题”,一边继续错着。倒也能理解——检查这个动作,对它来说同样是文字接龙。
普通人该怎么用它
说几个我踩过坑之后攒下来的,很琐碎,但确实有用。
给它角色和场景,比给它指令有效。说“你是一个要跟供应商砍价的采购”比说“帮我写封邮件”得到的成品好得多,因为前者把语气、立场、信息密度一起限定了。
让它先给提纲,你改,它再展开。一上来就要成品,改起来更累。
涉及数字、日期、引用的地方,默认它可能是错的,随手核一下。成本很低,收益很高。
还有一条:别指望它一次就懂你。它没有读心的能力,你不说清楚的东西,它就按概率最大的方向猜。猜错了很正常,你再补一句就行。
说点私心话
这东西的进步速度,说实话有点吓人。一年前还写不利索的代码,现在能一口气生成一个能跑起来的小项目。但每次它给我惊喜的时候,我又会想起那个凌晨——那个不存在的函数名,写得那么自信。
它的强和它的弱,咬合在一起,分不开。
我不太喜欢那种“AI 要取代谁”的讨论,太空了。我更关心的是:哪些活儿交给它,我确实省时间;哪些活儿交给它,我回头得花双倍时间收拾。这个边界,每个人的答案都不一样,只能自己一点点试出来。
试的过程挺烦的。但也挺有意思。
作者|科技
排版|科技
审核|白杨