 大讲堂
半夜两点,它给我编了一篇参考文献
前阵子我对着屏幕问一个模型:帮我找几篇关于“城市热岛与夜间降温”的论文。它秒回,格式工整,作者、年份、期刊一应俱全。我差点信了。去数据库一查,三篇里有两篇不存在。第三篇作者名字对,内容驴唇不对马嘴。
这就是大语言模型给我的日常体验:一边觉得它怎么这么会聊,一边被它一本正经的胡说八道气笑。它不是搜索引擎,也不是数据库。它更像一台巨大的“下一词猜测机”。你给它一段话,它算概率,猜接下来哪个词最可能冒出来。然后再猜下一个。再下一个。
问题来了:猜下一个词,怎么就能写代码、改简历、编故事、解释量子力学?
先把句子切成小块,再让注意力找关系
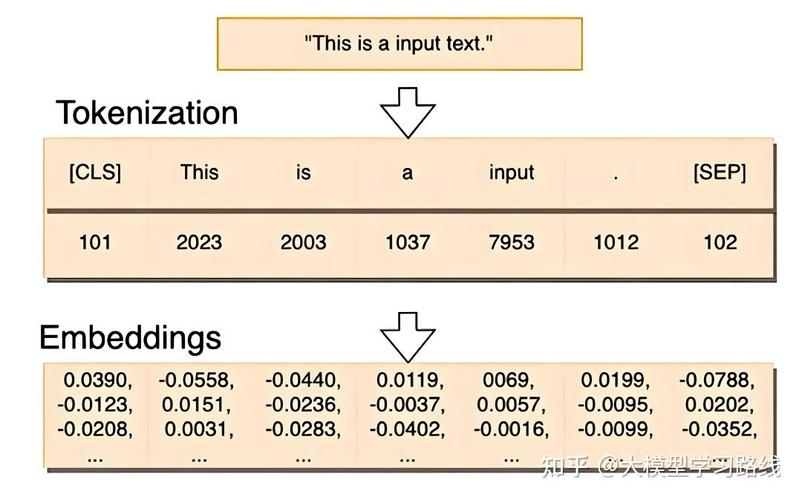
模型看到的不是“你好,今天天气不错”这样一整句。它先被切成 token。中文里,一个 token 可能是一个字,也可能是半个词,甚至几个字。英文里更碎,有时候一个长单词会被切成几截。切完之后,每个 token 变成一串数字,也就是向量。数字本身没有意义,但放在一起,能表示某种方向:猫和狗离得近,猫和微波炉离得远。这只是个粗糙比喻,别当真。
真正让大语言模型起飞的,是 2017 年那篇《Attention Is All You Need》里的 Transformer 结构。注意力机制干的事,说白了就是:当模型处理“它”这个词时,会回头看前文哪些词跟“它”有关。是猫还是狗?是杯子还是桌子?每个词都跟其他词拉关系,算权重。一层不够,就叠很多层。层层叠叠,句子里的远距离依赖就被抓住了。

不过,别把注意力想得太玄。它不是人类的理解。它更像一张巨大的关系网,里面全是统计规律。你问它“法国的首都是哪里”,它见过大量“法国—首都—巴黎”的共现模式,于是“巴黎”的概率被推高。它答对了。可你要是问一个训练数据里很少出现的偏僻事实,它也可能用同样的流畅语气,给你编一个。
幻觉不是 bug,是它的出厂设置之一
很多人第一次被大语言模型震住,是因为它说话太像人了。转折、谦虚、举例、自我修正,样样都来。可它的核心目标从头到尾没变:预测下一个 token。它没有被内置一个“真理检查器”。有些系统会加检索、加工具、加人工反馈,让它去查资料、按格式回答、拒绝危险请求。但底层那台“猜词发动机”仍然会犯错。
幻觉的根源,不是它故意骗你,而是它在优化“像不像”,不是“真不真”。
这差别很要命。你让它写一首诗,像不像就是标准。你让它总结一份财报,真不真才是标准。可它不会自动切换。所以我现在养成一个习惯:凡是涉及数字、日期、法条、论文引用、医疗建议,一律去原始来源核对。不是不信任它,是不能把校对工作外包给一台概率机器。
还有温度参数。温度低,它更保守,翻来覆去那几句。温度高,它更敢编,文采可能更好,跑偏概率也更大。很多聊天界面不让你直接调,但背后的采样策略一直在影响输出。
它为什么会“记住”上下文,又为什么会忘
你在对话里说“我叫老王,养了只叫煤球的猫”。聊了十几轮,它还能接上“煤球最近怎么样”。这不是因为它真的记住了你。至少在当前这轮对话里,它把之前的文字一起放进了上下文窗口。窗口就像它的工作台。台面大,能摆更多资料;台面小,旧消息就被挤下去。
上下文窗口这几年被拉得越来越长。从几千 token 到几十万 token,有些模型宣称能处理整本书。但“能放进去”和“能用好”是两码事。中间的信息容易被忽略,开头结尾反而更显眼。你塞一整份合同进去,它可能抓住前面的甲乙方,漏掉后面的违约金比例。所以长上下文不是万能钥匙。
另外,模型本身不更新记忆。除非产品额外做了记忆功能,把某些信息存到外部数据库。下一次对话,它可能完全不记得你。你以为它失忆,其实它从来就没“记”过。
时间线很短,变化很挤

2017 年,Transformer 论文发表。2018 年,BERT 和 GPT 相继出现。2020 年,GPT-3 带着 1750 亿参数进入公众视野,论文标题叫《Language Models are Few-Shot Learners》。2022 年 11 月,ChatGPT 上线,把聊天框推到普通人面前。再往后,开源模型、多模态模型、推理模型一波接一波。这个时间线满打满算不到十年。可它带来的冲击,已经渗进写作、编程、客服、搜索、教育。
说实话,我有时候会怀念没有大语言模型的搜索。那时候我输入关键词,自己筛选链接,自己判断真假。现在模型直接给我一段答案,省事,但也更容易让我偷懒。它像一个特别会说话的实习生。反应快,态度好,偶尔胡扯。你得会提问,也得会验收。
对话:那它到底懂不懂?
朋友问我:“它都通过考试了,还不算懂?”
我说,考试分数高,说明它在那些题型上的统计拟合很强。它可能真的抓到了某些抽象规则。但“懂”这个词太滑了。你说懂,是指有意识?有身体经验?能负责?还是仅仅能正确回答?如果只是后者,那它确实懂了一部分。可它不懂疼,不懂饿,不懂你熬夜改方案时的烦躁。
“那它会取代写作者吗?”
会取代一部分重复劳动。模板化的新闻稿、产品描述、会议纪要,它干得很快。但写作里最难的部分,恰恰不是把句子写通顺。是知道什么该写,什么不该写,为什么现在写,写给谁看。这些判断需要经验、立场、审美,还有对代价的感知。模型可以给你十个开头,但它不承担发出去之后的后果。
“普通人该怎么用?”
把它当副驾驶,别当自动驾驶。让它帮你列提纲、改病句、换语气、找反例、模拟面试。涉及事实,让它给来源,然后自己点开看。涉及隐私,别往里倒。涉及重大决策,把它当反方辩友,别当算命先生。
冷思考:热闹背后,有几件事还没解决
算力成本高。训练和运行都要烧电、烧卡。小公司玩不起大模型,只能调用接口或者用开源小模型。开源社区很猛,但部署、微调、评估,每一步都是坑。
评测也乱。一个模型在考试题上分数高,不代表它在真实工作里靠谱。基准测试可能被污染,题目可能进了训练数据。你看到的评测结果,背后是不同提示词、不同采样、不同评测集。可比性没想象中那么强。
版权和隐私绕不开。训练数据从哪来?生成内容像不像某位作家?用户输入会不会被拿去训练?这些问题没有一刀切的答案。不同地区、不同平台,规则还在变。
还有能源、就业、信息茧房。每一项都够写一本书。我不觉得大语言模型是泡沫,也不觉得它是万能药。它更像电。刚出现时,没人知道怎么用。后来它钻进所有机器,你反而注意不到它了。
所以,下次它再一本正经地胡说八道,别急着骂。先看看它猜词的逻辑,再想想你有没有给它足够清晰的上下文。它是一面镜子,照出我们怎么提问,也照出我们多容易相信流畅的句子。
作者|科技
排版|科技
审核|见微