 大讲堂
九月二十三号,南京。雨点打在窗户上,像谁在敲一段没写完的代码。机房里那台训练服务器又嗡嗡起来。风扇声不响,但持续,像夏天梧桐树里的蝉。我盯着屏幕上的损失曲线,它先猛地往下掉,然后开始抖,像喝多了美式的人打字。
这就是深度学习给人的直接印象:一堆数字在暗处翻来覆去。可它到底在学什么?如果你只听过“神经网络”“大模型”“Transformer”,又不想被术语绊倒,那可以从一张手写数字图开始。
一张手写数字图,为什么让机器看了很多遍
假设给机器一张28乘28像素的灰度图。每个像素是一个0到255之间的数。整张图拉直,就是784个数。深度学习的做法很土:把这784个数送进一个网络,网络里有很多旋钮。每个旋钮叫权重。输入乘权重,加在一起,再经过一个非线性函数。然后继续往下一层送。
它一开始什么都不会。权重是随机数。你给它看一张写着“7”的图,它可能输出“2”,还特别自信。然后损失函数跳出来说:差得远。反向传播顺着计算图往回走,算每个旋钮该往哪边拧、拧多少。梯度下降负责拧。拧一点,再喂下一批图。
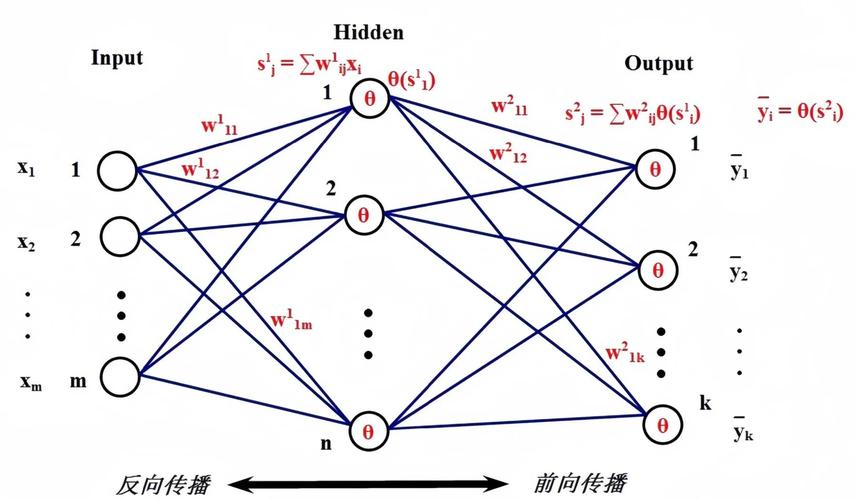
喂几万次,几十万次。慢慢地,某些旋钮组合会对横线敏感,某些对竖线敏感,某些对拐角敏感。层数多了以后,浅层看边缘,中层看笔画部件,深层看整体形状。它没有被告知“7有一横一折”,它自己从数据里长出了这种分层表示。
听起来像调音台,对吧?一轨吉他太闷,你推高一点高频。人声被鼓盖住,你压一点低频。深度学习训练就是同时调几百万、几十亿个旋钮。只不过它调的旋钮不是给人听的,是给误差听的。
不过话说回来,这解释有一个容易让人误会的地方:机器不是先理解“7”的概念,再去识别。它是在高维空间里找分界面。换句话说,它把像素点搬到另一个空间,让“7”和“2”更容易被一条曲面分开。这个过程叫表示学习。名字很学术,画面感倒像搬家具:原来的房间里,沙发和茶几挤在一起;换个房间,各归各位。
它不是在“思考”,更像在压缩和赌概率
有人问:深度学习是不是把答案背下来了?
有点背,但不全是。死记硬背对应过拟合。训练集里每张猫图都记得,换一张橘猫侧脸就翻车。真正有用的模型要在没见过的图上表现稳定。于是有了验证集、正则化、Dropout、早停这些招。它们不增加知识,反而限制模型别太狂。
换个角度,深度学习像在做极端压缩。原始图片几百万像素,信息冗余很大。网络一层层压,把“猫”这件事压成一组抽象特征:有毛、有胡须、有三角耳、眼睛在脸的前方。到输出层,它赌哪个类别概率大。注意,概率大不等于事实对。所以你会看到模型把遥控器认成手枪,把哈士奇认成狼,还把空白背景里的噪点认成数字。

卷积神经网络擅长处理图像,靠的是局部连接和权重共享。一个卷积核在图上滑来滑去,像拿放大镜找同一类纹理。Transformer 擅长处理序列,靠注意力机制让每个词跟其他词发生关系。你读“南京下雨,我收衣服”,知道“收”和“衣服”有关,也知道“下雨”是原因。注意力机制就在算这种关系权重。
但别急着说它“理解”了。它算的是统计关联,而且算得极狠。数据里如果“医生”旁边总出现“他”,模型就会继承这种偏见。数据里如果猫总在草地上,模型可能把草地当成猫的一部分。你给它一张沙发上的猫,它反而犹豫。这不是模型故意使坏,这是它学到的世界跟你以为的世界有偏差。
我见过一个很典型的误解:把大模型当成数据库。数据库查询是精确匹配,给条件,返回行。大模型不是。它更像一个被训练过的文本接龙器,根据上下文算下一个 token 的概率。它能记住一些事实,也能编出看似合理的事实。前者让人惊喜,后者让人头疼。
从感知机到注意力,中间摔过很多跟头
深度学习不是某天突然蹦出来的。它的根扎得很早。1943年,McCulloch 和 Pitts 提出一个简化的神经元模型。1958年,Rosenblatt 做出感知机,能学简单的线性分类。后来 Minsky 和 Papert 指出感知机连 XOR 都搞不定,研究冷了一阵。
1986年,反向传播被重新推到台前,多层网络有了训练方法。1998年,LeCun 等人把卷积网络用于手写数字识别,LeNet 在真实场景里跑起来。真正让圈外人开始沸腾的,是2012年 ImageNet 比赛里 AlexNet 的表现。那一年,GPU 训练、大数据、深层网络三件事撞到一起。再往后,2017年 Transformer 出现,注意力机制接管了自然语言处理。2020年之后,大模型开始进入普通人的聊天框。
这条线不是平滑上升。中间有算力不够、数据不够、梯度消失、过拟合、标注昂贵。很多人以为技术史是天才灵光一闪。其实更像修路。今天铺一段,明天塌一段。有人在实验室里熬到凌晨,只为了让模型少抖一点。
误区辨析:别把“大”和“懂”划等号

参数多,确实能带来更强的拟合能力。但参数多不等于推理可靠。一个模型可以在考试题上拿高分,也可以在简单常识上摔跤。为什么?因为它的目标函数不是“追求真理”,而是“降低训练损失”。训练数据没覆盖的角落,它只能猜。猜得流畅,不代表猜得对。
还有一个误区:以为深度学习可以完全替代特征工程。早年的机器学习,专家要手工设计特征:边缘、角点、纹理、词频、TF-IDF。深度学习把这一步自动化了,但不是消灭了人类判断。你选什么网络结构,喂什么数据,怎么定义损失,怎么清洗标签,仍然依赖人。自动化的是旋钮调节,不是问题定义。
再一个误区:以为模型越大越安全。规模上去以后,能力会涌现,风险也会涌现。幻觉、偏见、隐私泄露、对抗样本,都不是小问题。对抗样本这事很有意思:给图片加一层人眼几乎看不出的噪声,模型就可能把熊猫认成长臂猿。因为它看的是像素统计,不是人类语义。
聊到这儿,一个朋友插话:“那深度学习是不是没法学因果?”
不能这么绝对。传统深度学习主要学相关性,但因果推断和深度学习正在结合。比如用结构因果模型约束表示,或者用干预数据训练。只是这条路不轻松。相关性能让模型预测,因果性能让模型决策。两者差着不少。
深夜机房之外,它正在往哪里走
趋势有很多,我不太想列清单。列清单容易变成营销话术。只说几个我真正在意的方向。
一个是端侧。手机、耳机、摄像头、汽车,都在塞进小模型。不是所有任务都需要云端大模型。端侧推理省带宽,也少一些隐私顾虑。另一个是多模态。文字、图像、声音、动作混在一起训练,模型对世界的表示会更接近真实场景。还有 Agent。让模型不只回答问题,还能调用工具、拆任务、检查结果。但 Agent 的可靠性,目前还像刚学骑车的小孩,扶着能走,松手就晃。

能耗也是躲不开的话题。训练大模型要电,要水,要显卡。有人拿它跟航班比,有人拿它跟数据中心比。具体数字各有口径,但方向清楚:算力不是免费午餐。未来如果只在云端堆参数,成本和环境压力都会顶到天花板。所以模型压缩、稀疏化、混合专家、蒸馏,这些词会越来越常见。
可解释性也重要。医疗、金融、司法这些场景,不能只给一个分数。人需要知道模型为什么这么判。注意力图、显著性图、概念激活向量,都是尝试。它们不完美,有时还会骗人。但总比黑箱里伸手摸强。
下次听到深度学习,可以问这三个问题
它训练的目标是什么?损失函数怎么定义,往往决定了模型往哪偏。
数据从哪来?标签谁标的?覆盖了哪些人、哪些场景、哪些边缘情况?数据偏差会变成模型偏差。
它在什么分布上评估?如果测试集和真实世界差很远,分数再漂亮也白搭。
回到九月二十三号的南京。雨停了,机房风扇还在转。屏幕上那条损失曲线终于平了些。模型没开悟,也没成精。它只是从无数个错误里,拧好了一堆旋钮。知道这一点,既不会把它神化,也不会把它看扁。深度学习真正有意思的地方,大概就在这里:它用笨办法,逼近了某种聪明。
作者|科技
排版|科技
审核|小北