上周三在南京紫金山下的实验室蹲到晚上九点。
保安都锁了半层门了。
我还盯着示波器上跳的那串亮线发呆。
那线是亮蓝色的,跳一下,就代表光在芯片上跑了几公里的等效距离。
之前我对光子计算的所有认知,都停留在科技新闻里的套话——什么“后摩尔时代的核心路径”“硅基芯片的终极替代”。直到那天实验室的张博士捏着一块比指甲盖还小的硅片递到我眼前,我才反应过来,我之前全理解错了。
别拿“替代硅基芯片”吹了,光根本不是你想的那么算的
之前我总觉得,所谓光子计算,不就是把芯片里跑的电子换成光,速度能快上成百上千倍?
错得离谱。
张博士指着硅片表面刻的那些细纹给我看——那不是现在CPU上的金属电路,是一根根比头发丝细百分之一的硅基波导。光就在这些弯弯曲曲的微米级沟道里跑,碰到分束器就拆成好几束,碰到相位调制器就偏个角度,最后到另一端的光电探测器上,光强的变化直接对应成计算结果。
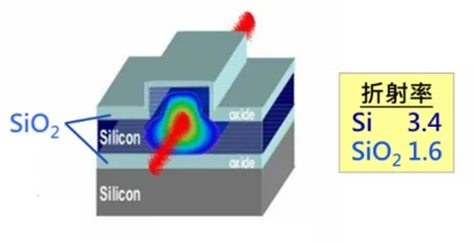
说实话,我第一次凑到显微镜下看这些波导的时候,鸡皮疙瘩都起来了。
人类为了让光乖乖听话,在指甲盖大的地方刻了几百公里长的弯弯曲曲的沟,就为了让光在里面跑的时候,不偏不倚,不散射,不损耗。
很多自媒体吹的神乎其神,说光子计算出来,现在的显卡、CPU全要淘汰。
扯。
光跑的是快,可光记不住东西。你想啊,光在波导里跑完全程也就几皮秒的事,快到你根本来不及让它停下来存个中间值。现在的光芯片根本没有传统意义上的内存结构,它最擅长的,从来不是像CPU那样做通用的逻辑运算,而是算那种“一锤子买卖”的大矩阵乘法——刚好就是现在AI大模型训练里占了90%以上算力消耗的那部分任务。
你把一整坨要算的数,折成光的相位和强度值,顺着波导走一遍,出来的光强变化直接就是矩阵乘完的最终结果。根本不用像现在的电子芯片那样,一个数一个数从内存搬到运算单元,算完再搬回去存着,来回折腾的能耗,有时候甚至比计算本身的能耗还高。
现在的光子计算,离能用上还有多少“蠢卡点”
我翻了近三年的公开论文,又拉着在实验室做流片的师弟喝了两顿鸭血粉丝汤,才知道现在的技术卡点有多好笑。
不是光跑的不够快。
是你要让光按你想的路径拐弯,得给波导装微型加热电极——给波导局部加热个几十度,靠热胀冷缩改变硅的折射率,光才会乖乖拐到指定的方向。
好家伙。
为了让光拐个弯,你得先给芯片做局部“艾灸”。

之前看宣传说光子计算零功耗,纯纯误导人。你要把电信号转成光信号,要把光信号再转成电信号,这两头的转换功耗,现在其实和你手里的高端GPU比,根本没差多少。真正省功耗的,是中间那部分计算传输的过程——毕竟光在波导里跑的时候,没有电子那种在硅晶格之间撞来撞去的发热,只要波导壁做的够光滑,光在里面跑个几厘米,损失的能量都可以忽略不计。
还有个更要命的问题:良率。
你想啊,那波导细到比头发丝细一百倍,流片的时候稍微沾点直径一微米的灰尘,那根波导就废了,光直接就散射没了。现在一片8英寸晶圆上,能挑出来功能完整的光芯片,良率还不到10%。要知道现在主流的先进电子芯片,良率都能稳定在90%以上。这中间的成本差,根本不是一个量级的。
我之前在实验室见过师弟拿着一片废片蹲在走廊叹气——就因为流片那天车间的空气过滤系统出了点小问题,半片晶圆全沾了灰尘,小几十万的流片费直接打了水漂。
这种糟心事,做硬科技的人都懂。
别等“光子算力革命”了,它根本不会按剧本走
很多人总在等,等哪天光芯片突然成本打下来,能装在自己的游戏本里,跑3A游戏的帧率直接翻十倍。
别等了。
最先用上光子计算的地方,根本不是消费电子。
是那些每天要跑几亿次矩阵乘法的大模型训练集群。你想啊,现在的大模型训练,大部分的电费,其实都花在把数据从内存搬到运算单元的路上——也就是整个行业卡了十几年的内存墙问题。光子计算刚好就治这个病:它把传输和计算合二为一了,光在波导里走的过程,就把矩阵乘给算了,根本不用来回搬数。
上次张博士给我算过一笔账,现在实验室做出来的原型机,算同样的大模型推理任务,功耗大概是同性能电子芯片的三分之一。但离量产普及,还差得远。
有个做硬科技投资的朋友之前问我,现在投光子计算是不是太早?
我给他的回答是,你要是抱着“投个项目两年就能上市赚快钱”的想法,趁早别碰。这东西不是那种靠堆产品经理、靠改改UI就能快速迭代的消费电子,是要一点点把波导做的更光滑,把调制器做的更省电,把良率一点点提上去的硬骨头。
急不来的。
从实验室出来的时候,已经快十点了。山脚下的风带着桂花香,保安大叔已经在门口等我了,笑着说“小姑娘今天又看芯片看到这么晚”。我口袋里揣着张博士给我的那块流片失败的废片——上面的波导因为沾了点灰尘,光根本跑不通。
我盯着那片小硅片看了半天。
哪有什么突然砸下来的算力革命啊。
都是一群人蹲在实验室里,熬了一个又一个的晚上,把那根细到看不见的波导,一点点磨出来的。
作者|科技
排版|科技
审核|安然