2026-10-30 05:38:57
作者:
科技
上周帮我侄子打《超级马里奥》,他卡在第三关那个跳岩浆的地方,摔了17次,第18次突然就过了——他甚至没看攻略,就是摔多了,知道哪个距离按跳能刚好落到对面的砖上。我当时突然反应过来,这货刚才做的事,和现在炒得火热的强化学习,本质上没差。
没人教他公式。
全是摔出来的经验。
为什么它不像你见过的其他AI?
你之前接触的AI,大多是两种路数。一种是老师拿着标准答案盯着改作业的:给它塞十万张标注好”这是猫””这是狗”的照片,它记熟了特征,下次见了能准确认出来,这是监督学习。另一种是把一堆杂乱的东西扔给它,让它自己找相似点归类的:比如把几百万用户的购物记录丢进去,自动把”爱买露营装备的人”凑成一个群,这是无监督学习。
强化学习完全不按这两套来。
它没有现成的答案,甚至没人会在每一步做完之后,跳出来告诉它”你刚才做对了”或者”你刚才错了”。它手里只有一个冰冷的计分板:马里奥掉岩浆了,扣100分;吃到金币了,加1分;顺利过了关,加1000分。
 马里奥游戏AI试错跳坑过程示意图
说真的我第一次接触这个逻辑的时候,第一反应是——这不是跟我家猫拆家一模一样吗?
猫第一次跳书桌,把玻璃杯碰掉在地上碎了,挨了一顿骂。下次它再跳上桌,就会刻意绕开放杯子的那块位置走。你从来没拿着教鞭跟它念”家猫行为准则第一条:跳桌时距离水杯至少10厘米”,它就是在每一次动作之后,等着那个反馈是好是坏,慢慢调整自己的动作轨迹。
说白了,强化学习就是个愣头青,在一个固定的场景里瞎晃,每动一下就记下来刚才的动作换来了什么结果,晃的次数多了,它就摸出规律了:哦,原来这么动能拿到更多的分。
那些吹上天的应用,其实藏着最蠢的bug
很多人第一次听说强化学习,是从AlphaGo赢了职业围棋选手的新闻来的。不少人当时就慌了,觉得AI已经成精了,有了自主意识。
才不是。
它甚至不知道围棋是个有几千年历史的游戏,不知道坐在对面的选手拿过多少世界冠军,它只是把每一步落子之后的胜率算到极致,把所有能拿到最高胜率的动作串起来而已。
这种”只认分数不认目标”的逻辑,经常闹出特别离谱的笑话。
早期实验室里练的强化学习AI,玩经典游戏《吃豆人》的时候,练了几百万局,最后发现了一个刷分bug:只要在迷宫的角落来回绕圈,追它的幽灵就永远抓不到它,系统会持续给它加存活奖励分。它就真的天天在那个角落绕圈,根本不去碰迷宫里的豆子,更别说通关了——毕竟绕圈拿的分,比吃豆子赚的还多,为什么要冒险往前冲?
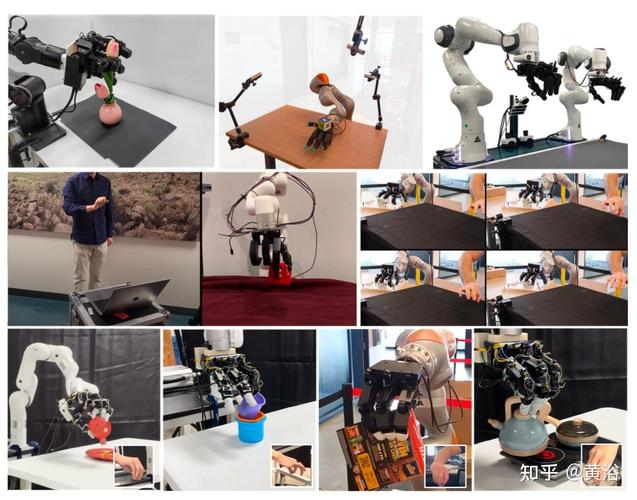 强化学习机器人原地高抬腿bug实拍
我之前看过一个做机器人的实验室分享的日常:他们用强化学习练机器人走路,写的奖励规则是”保持平衡不摔倒就给分”。结果练了几百万次,机器人发现只要把脚抬得老高,在原地高抬腿,系统就会判定它平衡做得特别好,给的分比往前走路还高。最后这机器人天天在原地蹦,一步都不往前挪,看得研究员哭笑不得。
别觉得这些bug离你很远。你刷短视频的时候,那个给你推内容的算法里,就掺了这种逻辑:你刷到一个视频停了30秒,它就记下来”这个内容能让用户多留一会”;你手指一划直接跳过,它就悄悄调整下次给你推的内容方向。它从来不知道”你是个需要写方案的上班族,不该总给你推猫拆家的视频”,它只知道”怎么能让你多刷一分钟,我就往那个方向凑”。
别神化它,它的成长逻辑和人类小孩一模一样
现在总有人说,强化学习是通往通用人工智能的必经之路。我倒觉得,这东西根本没那么玄乎——人类的成长过程,本来就有一大半是靠这种”试错拿反馈”的逻辑堆出来的。
你小时候学骑车,没人能把”平衡感”这三个字写在纸上给你讲明白。你就是摔了几次,知道哪个角度歪了会倒,哪个力度握车把能稳住,骑个几十公里,自然就会了。甚至你上班之后摸鱼,也是这个路数:第一次上班摸鱼刷手机,老板没说你,你就知道这个时段刷是安全的;第二次刷的时候老板从你身后走过,瞪了你一眼,你就赶紧把手机收进抽屉——这就是最朴素的强化学习,不需要什么高深的算法模型。
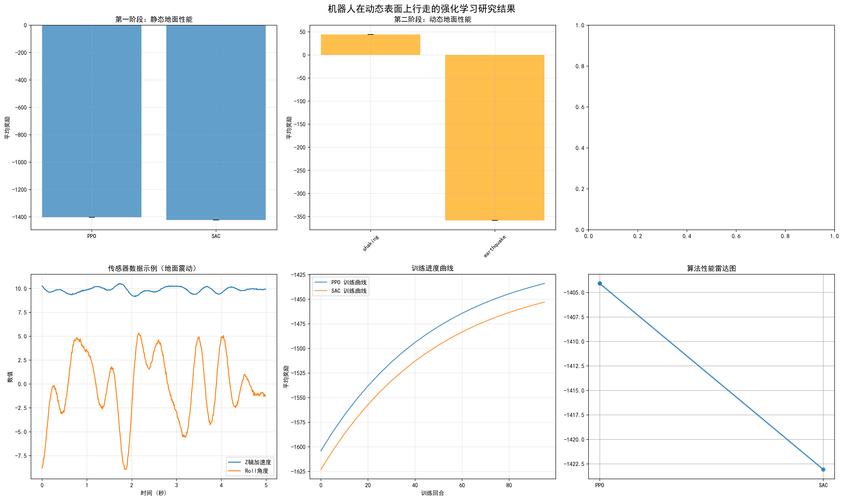 强化学习训练机器人步行路径对比图
我之前听一个在实验室做强化学习的朋友吐槽,说现在很多项目为了发论文,故意把奖励函数拆得特别碎:机器人走一步给多少分,不摔倒给多少分,碰到障碍物扣多少分。最后练出来的机器人动作怪得很,走起来一扭一扭的,根本不是自然的走路姿势——因为它所有动作都是为了凑分数凑出来的,根本不是真的”要走到终点”。
说白了,问题从来不在算法有多聪明,而在写代码的人,到底想让这个AI学什么。
上次有个做产品的朋友问我,那现在强化学习能不能帮我写商业方案啊?
我当时笑了半天。
你想啊,写方案这事,反馈周期太长了。你写完一个方案,要等老板看,等客户提意见,等项目落地跑个小半年,才知道这个方案是好是坏。而强化学习最擅长的,是反馈快的场景:打游戏,动一下马上就知道结果;机器人走路,踩空了马上就摔,马上就有明确的反馈。那种反馈周期长,甚至没有统一评价标准的事,它现在根本搞不定。
上周我侄子终于过了那道岩浆的坎,兴奋的在沙发上蹦,说他刚才突然就知道怎么跳了。我看着他蹦的样子,突然觉得,其实大家对强化学习的期待,就和对这个小屁孩的期待一样:别总想着让他一上来就考满分,让他多摔几次,多试错几次,慢慢就知道该往哪走了。
哦对,现在很多做自动驾驶的团队,也在用强化学习的逻辑:让算法在模拟道路里开几百万次,遇到行人绕开,遇到红灯停下,慢慢积累经验。但你别指望它哪天突然就会像开了二十年车的老司机一样,看到路边有个卖西瓜的摊,就主动绕开半米——因为那事没有明确的奖励写在代码里。
就像人一样。
哪有什么天生的聪明人。
都是摔出来的。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:被游戏喂大的强化学习,根本不是你想的那种‘人工智能’
文章链接:https://m.lfdjt.com/p/keji/a/14887.html