上周加班到十点,我趴在桌上整理线下展的动线草稿,画得满纸乱线,旁边还洇了半圈咖啡印。本来想拍了发给同组的同事,结果手滑,直接把图发给了手机里存的多模态大模型。
我当时都准备好撤回了。
三秒。
它的回复弹出来:”你把签到台放在入口拐角了?哦对,旁边那个歪歪扭扭的圆圈,是不是上次我们吐槽的、给观众送免费美式的位置?”
我盯着屏幕愣了半分钟。
别再说它是“会看图的聊天机器人”了
很多人对多模态的误解,还停留在“给原来的文字聊天模型加个图片识别插件”的阶段——就像给功能机硬塞个凑数的摄像头,能拍就行,根本谈不上什么深度理解。
真不是。
上个月我朋友去看演唱会,现场太挤,拍的图全糊了,台上的人影虚成一团,灯牌只露出半块写着“宇”字的角,地面上飘着点没扫干净的金箔。她本来想发朋友圈凑个热闹,顺手把图丢给了多模态模型,本来以为会收到“图片清晰度不足无法识别”的套话,结果对方回:”你是去的长沙场收尾场?我记得那场散场的时候,场馆地上全是没扫干净的金箔。”
她当时鸡皮疙瘩都起来了。
它从来不是把所有输入都翻译成文字再思考。你可以把它的训练逻辑理解成一个铺得无限大的共享地图:从训练最开始,它就把见过的所有文字、图片、音频、甚至几秒钟的短视频帧,都按照语义的远近摆在这张地图上——“猫”这个汉字,和猫跑起来的照片,和猫叫的音频,在地图上的距离挨得特别近,“狗”的位置就离得远一点。
不管你扔给它什么形式的输入,它第一反应不是先把图转成文字、把语音转成文字,而是先在这张地图上找到和你给的内容最匹配的坐标,再顺着坐标周围的关联信息给你反馈。
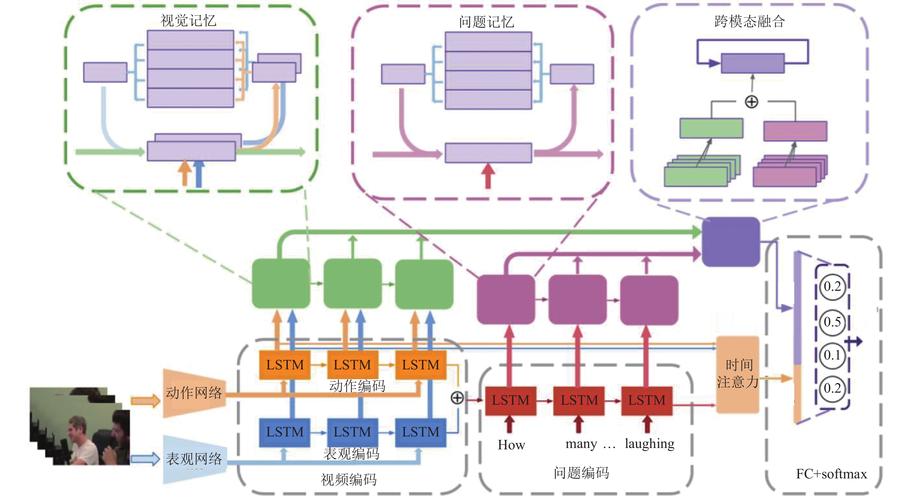
你根本不需要把所有信息都整理成标准的书面语才能跟它对话。比如你随手拍一张吃火锅的照片,它不会只干巴巴给你列“图中有毛肚、黄喉、蘸料”,它能注意到你蘸料碗里多舀了一勺折耳根,猜到你是习惯吃川味的老食客,甚至能从照片角落的空调显示屏,猜到你是不是又被火锅店的冷风吹得胳膊疼。
那些你吐槽的“bug”,其实是它的思考痕迹

我之前录过一段15秒的音频,是我家猫踩在键盘上跑酷的声音,中间混着冰箱启动的低频嗡鸣,还有猫不小心压到空格键的长音。换做以前的语音识别工具,大概率直接返回“背景噪音过大,识别失败”。
结果多模态模型听完直接给我回:”你家猫又踩你键盘了?听着哒哒的频率还不低,是不是刚跳上桌的时候压到空格了?”
准确得离谱。
很多人吐槽多模态模型“爱瞎编”,也就是大家常说的幻觉——比如你给它看一只狸花猫的照片,它有时候会一本正经告诉你“这是一只三岁的蓝白英短”。这真不是它故意骗你。你把那张语义地图摊开就懂了:当你给的图片坐标离“蓝白英短三岁”的语义簇特别近的时候,它顺着最近的点给你输出信息,就像你在街上远远看到个穿黑外套的人,第一反应觉得是你上次约了饭的朋友,走近了才发现认错了人。
不是故意撒谎。
是距离太远的时候,坐标的边界本来就没那么清晰。
那些厂商吹得神乎其神的“零幻觉”,其实根本就是骗外行。真要是把每个坐标的边界划得丝毫不差,那它看到带艺术加工的插画、拍糊的生活照的时候,反而会因为找不到完全匹配的坐标直接宕机。人跟人聊天的时候还会认错人、记错细节呢,太完美的模型,反而不像个能好好聊天的对象。
离“真的懂你”,它还差得远
不过话说回来,现在市面上很多号称“全模态”的模型,其实根本就是在凑数。
我上周试了某款宣传得很凶的全模态模型,给它发了一张下雨天在路边等车的照片:我的裤脚被溅湿了一块,手里攥着半张被雨打皱的电影票,旁边的树叶子还在往下滴水。结果它给我返回的内容,是干巴巴的标签拼接:“场景:雨天;主体:人物;元素:树木;特征:湿裤脚”。
就完了?
它根本没意识到,这张照片背后是我看完晚场电影,赶不上末班车,站在路边打了十分钟车的狼狈。真正的多模态,核心从来不是“支持多少种输入形式”,是能不能把这些零散的碎片,串成有上下文的、带着情绪的完整场景。
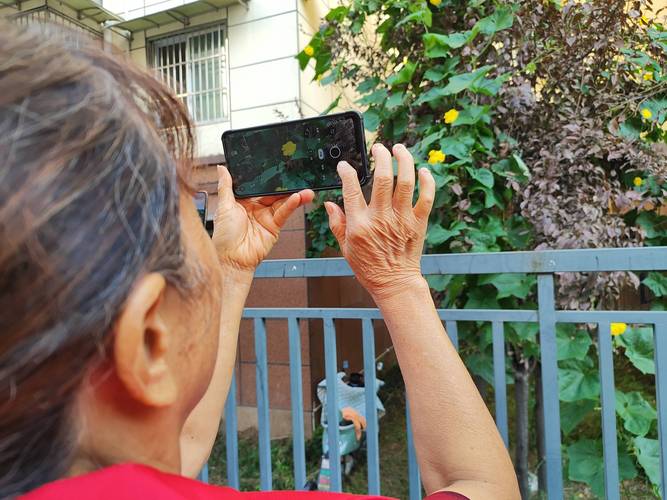
说实话,我第一次真正觉得多模态有温度,根本不是看厂商发布会的演示视频。是我奶奶,不会用智能手机打复杂的字,她对着手机给多模态模型发了一段10秒的视频:阳台的三角梅开得满枝都是,她自己的手在镜头前面晃了晃,配了一段带着方言口音的语音:”这花今年开得比去年早,上次你说要拿回去插瓶的。”
模型直接把语音转成通顺的文字,发给了我,连她话里那点盼着我回家的情绪,都顺着文字透了出来。我当时盯着手机屏幕,鼻子一下就酸了。
多模态最珍贵的地方,从来不是能在多少个行业里搞出什么“颠覆性解决方案”,是它把人和AI之间的对话门槛拆得稀碎。你不需要字斟句酌组织成标准的书面语,不需要把图拍得没有一点糊边,不需要把话说得没有一点歧义,你随便扔过去什么零散的、没头没尾的东西——可能是半张草稿纸,可能是跑调的哼歌,可能是你拍的阳台开了的花,它都能接得住。
真的。
下次你跟它聊天的时候,别总拿那些规整的测试题考它。随手拍张你桌上的半杯咖啡,录两句你路上听到的歌的副歌,看看它能不能接住你没说出口的话。
作者|科技
排版|科技
审核|知知