上周六在老门东斜对面的社区咖啡馆坐了一下午。邻座的男生把笔记本架在支架上,屏幕亮着《超级玛丽》的像素界面,那个戴红帽子的小人从最左边的起点出发,走三步掉坑,跳早了撞乌龟,被火喷得掉半管血,来来回回摔了快两百次。我正端着冰美式盯着屏幕走神,他突然“嗷”一嗓子,把邻桌女生的芋泥奶冻卷都吓掉了渣——小人居然跳过了那个最难的岩浆坑,一脚踩在旗杆上通了关。
他挠挠头笑,说自己调的强化学习模型,跑了整整27个小时,终于见着回头钱了。
别把它和你刷到吐的推荐算法混为一谈
我之前一直以为,刷抖音的时候算法给你推你爱看的猫视频,就是强化学习。毕竟你刷得越久,它给你推的东西越合你心意,不就是“做对了给奖励”吗?
错得离谱。
你刷视频的时候,算法是有明确的“标准答案”的:系统提前给你打标签,喜欢猫,喜欢南京本地美食,讨厌职场鸡汤,然后给你匹配对应的内容。它学的是“什么内容最可能让你划不走”,全程有人类标注的样本当参照,是有人在旁边举着小牌子说“这个对,那个不对”的。
但强化学习不是。
它从来没有拿到过一本写满标准答案的课本。
就像那个在超级玛丽里反复摔的小人,没人提前跟它说“看到乌龟要从头上踩过去”“掉坑里就没分了”“岩浆的伤害比乌龟高”。它一开始所有的动作都是随机乱按的:有时候往左走,有时候往右跳,有时候站在原地不动。每次做完一个动作,系统就给它算个分:走了一步,加1分;掉坑里,扣100分;吃到蘑菇变大,加50分;通关,加1000分。它要做的事,就是在几百万次随机尝试里,把所有能拿高分的动作串起来,变成一套自己的行动路径。
我之前还听人说,外卖平台给你推满减券是强化学习。扯什么呢。
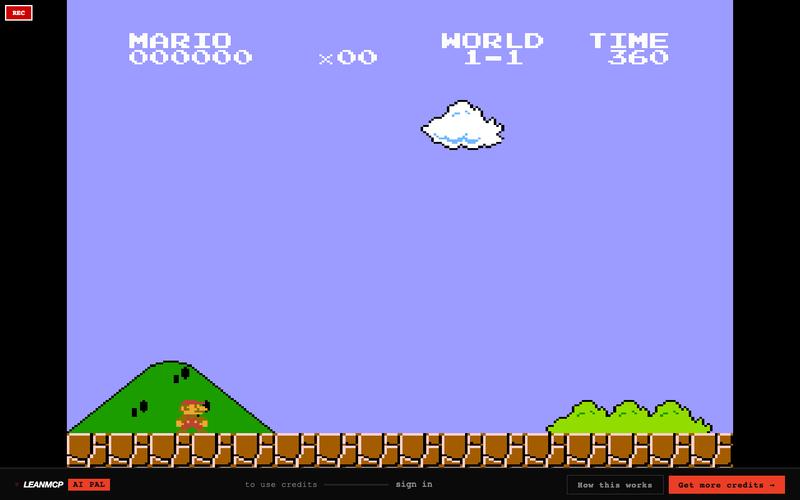
说实话,我第一次意识到两者的区别的时候,突然觉得之前的认知全错了。之前总觉得AI是个被人喂了满肚子标准答案的好学生,直到看见那个小人在关卡里摔得七荤八素的样子,才反应过来——这哪是好学生啊,这是个没人管的野孩子,全靠自己摸爬滚打攒经验。
你看到的“神操作”,本质是算明白了“哪种亏最划算”
很多人看强化学习的演示视频,总觉得它像开了上帝视角。比如那个赢了围棋的模型,下出了人类几百年都没走过的步;那个控制机械臂的模型,能把形状歪歪扭扭的零件卡进严丝合缝的卡槽里。好像它天生就比人聪明。
哪有什么天生的聪明。
它算的东西特别朴素:我现在做的这个选择,短期看可能要亏点分,但长期算下来,总收益是不是最高?
举个最直白的例子。你玩开放世界游戏的时候,前面三不远的地方有个Boss,掉最好的装备,但你现在等级低,打它可能要掉半管血。你是绕开它先去旁边的新手村刷怪升级,还是硬着头皮上去拼?
换做是人,可能要纠结半天,甚至为了省点时间硬刚,结果死了读档重来。但强化学习的模型,会把所有可能的选择拆成细碎的即时反馈:硬刚Boss,有30%概率赢,拿1000分,70%概率输,扣200分;绕路去刷10个小怪,每个怪给10分,刷完刚好够升级,回来打Boss赢的概率升到90%,总收益算下来,比硬刚高太多。哪怕绕路要多花两分钟,它也会选这条路。
它从来不会为了眼前的一点小便宜,放弃长期的收益。
我之前看过一个做机器人抓取的实验,机械臂要把散在托盘里的一堆螺丝按大小分类。一开始它把螺丝扫得满天飞,捏碎了两个塑料托盘,扣了快一千分。后来它慢慢摸出规律:先轻轻扫一下托盘边缘,把螺丝都聚到中间,再用刚好3牛的力度捏起螺丝,放到对应的格子里。整个过程,没有人教它“扫托盘要轻”“捏螺丝力度不能太大”,它就是在一次次的试错里,把所有可能亏的账都算明白,最后找出最不亏的那条路。
上次跟那个咖啡馆的男生聊天,他说他最开始给模型设奖励的时候,为了让小人快点通关,特意把“走到旗杆”的分设得特别高。结果跑了半天发现,模型根本不往终点走——它在关卡里反复来回踩那个加分的砖块,踩一次给1分,踩了几万次,分数比通关的1000分还高。给它气得当场删了两行代码。
你看,哪有什么神。你要是规则定得有漏洞,它比谁都会钻空子。
现在吹得越凶的落地,越要盯着它的试错成本看
这两年总有人说,强化学习要颠覆所有行业了。从自动驾驶到工业机器人,从药物研发到电商定价,好像只要把强化学习套上去,就能立马变出个能自己进化的AI系统。
我每次听这种话,就想起那个在高速上开得比老年代步车还慢的自动驾驶测试车。
上个月在绕城高速上碰到的,车身印着某自动驾驶公司的标,旁边的大货车按了三次喇叭,它还是以60码的速度在中间车道晃,连变道都不敢。我坐朋友的车超过去的时候,特意看了一眼副驾的测试员,正攥着手里的接管按钮,手心都出汗了。
为啥不敢快?
因为强化学习的试错,在数字世界里是零成本的。超级玛丽摔了,点一下重开就行,跑一百万次也耗不了几个电费。但现实世界的试错,是有真金白银的成本的。你让强化学习控制的机械臂在车间里随便试错,要是一下撞在价值几十万的机床上,谁赔?你让自动驾驶的AI在高速上随便试变道,要是旁边突然窜出来个外卖电动车,试错一次的代价可能就是人命。
所有不敢大规模落地的强化学习项目,本质上都卡在了试错成本上。
我那个在工业机器人行业做了快十年的朋友说,现在车间里用的机械臂,八成还是靠人写死的程序,哪敢全靠强化学习。之前有个同行试着在装配线上用强化学习,结果模型为了多拧两个螺丝赚分,把零件都拧滑丝了,一上午废了三千多个零件,老板直接把他的权限收了。
也不是说它不好。
就是别把它吹得像万能药似的。它本质上就是个在数字世界里摔了无数次的小孩,你把它放到没有摔过的现实场景里,它还是会慌,还是会犯错。
那天从咖啡馆走的时候,那个男生已经收拾好东西准备走了,屏幕上的超级玛丽小人已经通了三次关,他说接下来要给模型加个新关卡,看看它能不能摔几百次又摸出新的路径。
南京秋天的风刚好吹过来,梧桐叶飘在咖啡馆的玻璃窗上。
我突然觉得,其实人跟这模型也没差多少。
你摔的那些跤,那些走的弯路,那些一开始怎么都搞不懂的事,本质上不就是在给自己算分吗?哪有人一开始就知道哪条路是对的。
摔多了,自然就会了。
作者|科技
排版|科技
审核|见微