上周去设计师朋友家蹭饭,刚进门就撞见他家那只三花猫,一爪子把他摊在桌上的手绘草稿扫进了半冷的冰咖啡里。纸面上的线条晕开一大片,他盯着那团湿纸愣了三秒,本来以为熬了三个晚上的稿直接废了,结果掏出手机对着晕开的纸扫了一下,丢进多模态大模型的输入框,点了下还原。
半分钟。
屏幕上出来的线稿,跟他原稿的构图、线条走向差不了多少,连他本来标在边角的小注释都没漏。我当时第一反应是,这东西根本不是我之前以为的“会发图的聊天机器人”。
不是给文字模型“配了个看图插件”
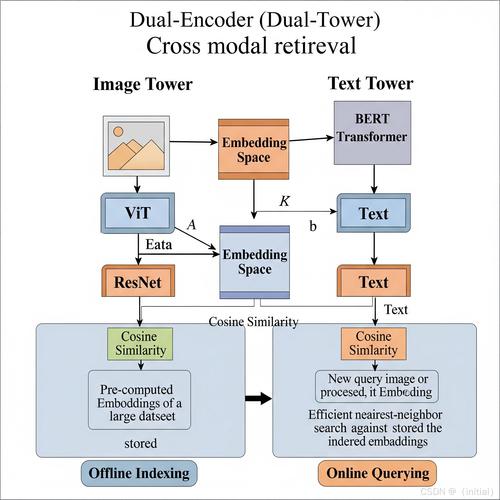
太多人对多模态大模型的认知还停留在几年前的水平——觉得就是原来的文字大模型外面套了个图片识别的壳,先把图片转成一段文字描述,再丢给原来的模型去理解。
多模态大模型从来不是给传统文字模型外挂一个图片识别插件。
它的训练逻辑从根上就不一样:训练的时候,就把文字、图片、声音、视频这些所有不同格式的信息,全部拆解成能互相对应的数字向量,你不用费劲把所有东西都转成文字,它能直接接住你扔过去的碎片——哪怕你只发了半张拍糊了的图,配了一句没头没尾的语音,它也能顺着这些碎片把逻辑串起来。
我之前自己测过,拍了张皱巴巴的超市购物小票,上面的字因为放了太久磨掉了一半,既没给参考信息,也没配文字,它居然能顺着小票的排版、字的轮廓,甚至结合我之前跟它提过的上周买过的东西,把那几个模糊的字猜了个八九不离十。
这才是真的跨模态。
不是硬转译。
它最有用的地方,根本不是“生成好看的图”
很多人提到多模态大模型,第一反应就是“哦,就是那个能画图的AI”。说真的,这个认知真的把它的能力说小了。
现在的多模态模型,最核心的能力不是“生成”,而是“接住散落在各个地方的碎片信息”。
你想啊,我们平时攒的信息有多碎:开会的时候在白板上拍的糊到看不清字的思维导图,路上走路的时候随手录的三十秒灵感语音,找了半天从网上扒下来的三张参考图,甚至是翻到的去年写在便签上的半句想法。换做以前,你得把这些东西挨个整理成通顺的文字,才能丢给AI当素材。现在不用了,全选了直接扔进去,让它帮你理出一份能直接用的框架就行。
我上次赶季度汇报的时候试了,省了至少两个小时的整理时间。
说真的,那两个小时我摸鱼喝了三杯冰美式。
我之前见过有人把自己三年来在地铁上拍的、没特意构图的、甚至因为晃悠拍得全是重影的街景照片全导进去,让它帮着拼一段关于城市通勤的散文。出来的东西没有那种AI写的空洞的华丽辞藻,全是那些他自己可能都忘了的细节——比如某一站的风里总带着糖炒栗子的香味,某节车厢的扶手总是留着上个人碰过的余温。
不是那种冷冰冰的拼接。
是真的能把你散在各个角落的记忆,给捡起来拼到一块。
别被宣传里的“全知全能”骗了
当然,吹得太狠的话,也容易让人摔跟头。
所有的跨模态理解,本质上还是靠训练数据里的关联映射撑着的。它能看懂你拍的血常规化验单上的数值箭头,但是它不知道你看到那个偏高的指标的时候,手心冒的冷汗;它能听出来你发的语音里带着感冒的鼻音,但是它不知道你是因为上周淋了半小时的雨才冻感冒的——毕竟你没说。
上次我拍了张我家猫趴在我电脑键盘上的照片,它回我“你的猫好可爱,在帮你敲字”。但它不知道我当时已经因为它把我写了一半的文档删了半页,正对着屏幕生气呢。
这些没被说出来的情绪、没被记录的细节,现在的多模态模型是接不住的。
不过话说回来,哪有技术一开始就完美的啊。
上周我妈给我发了段四十秒的视频,是她跟着多模态大模型的提示,给家里养了五年的君子兰换了盆,之前黄了半片的叶子,过了两周居然真的缓过来了。她对着镜头举着君子兰笑,说原来这东西不是年轻人玩的花架子,真能帮上忙。
你说这东西到底能走多远?谁知道呢。
反正现在,我家那只总把东西扒到地上的三花猫,再也不用为我朋友的设计稿背锅了。
作者|科技
排版|科技
审核|阿辰