 大讲堂

泛函的“原罪”:不是算不准,是你没打对补丁
从1960年代霍恩伯格-科恩定理出来,密度泛函从最开始的LDA,到后来的GGA,再到杂化泛函,一路迭代到现在,本质上都是在“近似”那个没法精确求解的交换关联能。没有哪个泛函是万能的。PBE算块体材料的共价键结构准到离谱,算分子间的弱相互作用——比如氢键、范德华力,差得能让人崩溃。B3LYP算有机分子的反应能很顺,算过渡金属的d轨道电子,自相互作用误差能把催化活性位的能量算偏到天上去。 说白了,泛函修正就是在原本的泛函输出结果上,叠加一个针对性的修正项,把那些被泛函本身忽略的、或者算错的能量部分补回来。现在工业界用得最广的,一个是色散修正,也就是针对范德华相互作用的补偿,从最开始的D2,到现在的D3、D4,基本上算有机分子、MOF、电解质体系,不加这个修正的结果根本没人信。另一个是自相互作用修正,针对的是泛函里电子和自己产生的虚假相互作用,这个问题在过渡金属、氧化物催化体系里特别突出,原来算个氧还原反应的过电位,能差出1V的数值,加了自相互作用修正之后,才能和实验值对上。
产业端的真实付费场景:修正比泛函本身值钱
现在国内做计算化学落地的团队,真正赚钱的根本不是卖泛函的授权,是卖配套的泛函修正参数包。比如做创新药的团队,要算PROTAC分子和靶点蛋白的结合能,原来用纯的B3LYP算,误差能到5kcal/mol,根本没法用来筛选候选分子——毕竟结合能差1kcal/mol,结合亲和力就差近一个数量级。后来他们给B3LYP加了D4色散修正,再叠加上基组重叠误差的修正项,直接把误差压到了1.2kcal/mol以内,原来要合成100个候选分子做实验,现在筛10个就能找到最优的,光实验成本就省了几百万。 还有做锂电材料的团队,算硫化物固态电解质的离子迁移能垒,原来用PBE算,因为忽略了部分弱相互作用,算出来的能垒比实验值高了0.3eV,直接导致筛选出来的电解质材料根本不导电。后来加了针对硫化物体系的专属色散修正参数,能垒的计算误差直接降到了0.05eV以内,现在他们团队的材料筛选周期,比原来缩短了60%。 说真的,很多做学术的人看不起这种“打补丁”的工作,觉得不够“原创”。但产业端不管这个。能把误差压到实验可接受的范围,能减少试错成本,就是真金白银的价值。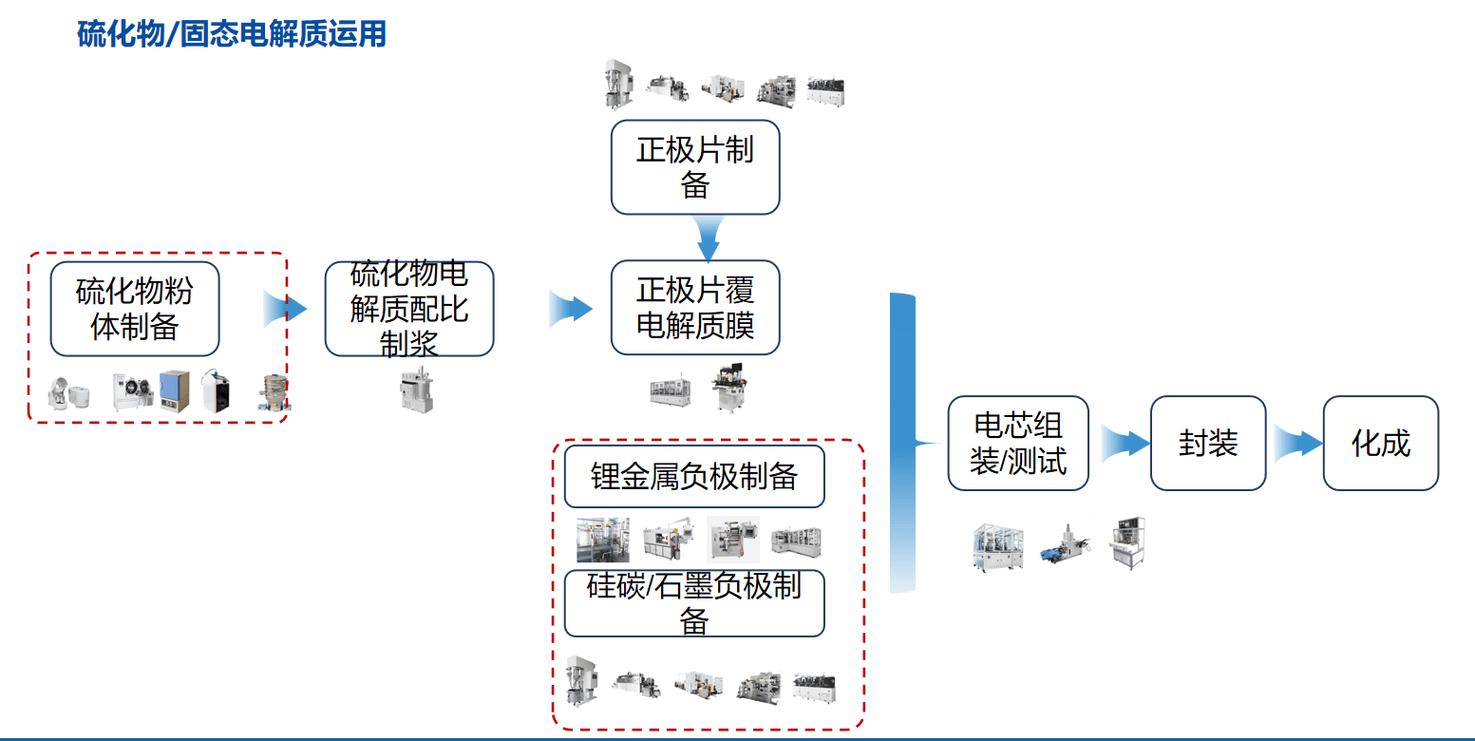
藏在黑箱里的风险:别让修正当了“学术化妆术”
现在这个赛道有个挺隐蔽的问题:很多泛函修正的参数是不透明的。比如有些商用软件里的修正模块,用户根本不知道参数是怎么拟合的,甚至同一个D3修正,在不同软件里的阻尼参数都不一样,导致跨实验室的计算结果根本没法复现。 更离谱的是,有些团队为了发论文,故意反复调整修正的参数,把计算结果“凑”得和实验值完全对上。去年某顶刊撤掉的那篇MOF吸附二氧化碳的论文,就是故意把色散修正的阻尼参数调小了30%,算出来的吸附能比真实值高了近40%,用来证明自己的材料是“顶级吸附材料”。 这种操作真的挺恶心的。本来计算化学是用来减少实验试错成本的工具,结果现在变成了给实验结果“打圆场”的道具。你想啊,当一个人可以随便调整修正参数来得到自己想要的结果,那计算的可信度就完全没了。 现在的治理方向也很明确,国内的计算化学产业联盟,去年开始就在推泛函修正的参数溯源标准——要求所有公开发布的计算结果,必须明确标注用的是哪个版本的修正方法、参数的拟合数据集是什么、有没有针对特定体系做过参数调整。不然就算你算出来的结果再好看,行业里也不认。未来3-5年的产业判断
第一,泛函修正会从通用型走向体系专属型。现在大家用的D3、D4都是通用参数,未来针对固态电池的硫化物电解质、针对ADC药物的抗体-小分子结合界面、针对绿氢生产的催化剂表面,会出现专门的修正参数包,精度比通用参数高一个量级,用户连调参的步骤都省了。 第二,机器学习会把泛函修正的成本打下来。现在的修正参数都是靠人工拟合的,未来会有小模型自动学习高精度DFT计算的偏差,针对不同的体系自动生成修正项,不用再靠人工花几个月拟合参数。现在已经有团队在做这个事了,算出来的修正精度和人工拟合的差不多,速度快了几十倍。 第三,这个方向不会是那种炒概念的赛道。毕竟现在不管是锂电、创新药还是催化剂,研发的试错成本太高了——一个新药的临床前研发成本动辄几个亿,一个锂电材料的中试成本也是几千万。能把计算的误差压到可接受范围的修正技术,就是真的有付费意愿的硬通货。 没人愿意为不准的计算付钱。那些看起来不起眼的补丁,迟早会变成整个计算化学产业的核心壁垒。作者|大讲堂
排版|大讲堂
审核|柚子