2026-10-24 22:27:00 作者:大讲堂
上周和某头部大模型厂的算法负责人喝酒,他喝到第三杯的时候骂了句脏话——说外面吹的什么”大模型革命全靠多头注意力”,纯纯是把论文摘要当产业圣经卖。
我当时愣了一下,毕竟从2017年Transformer论文出来到现在,多头注意力几乎成了整个AI行业的”政治正确”,谁敢说它不好,就会被扣上”不懂技术趋势”的帽子。但真沉到产业一线算过账就会发现,这个被写进每一本AI教材的核心技术,根本没有外界吹的那么神。
别被论文骗了:多头注意力本质就是”拆任务查资料”
很多人读多头注意力的论文,上来就被QKV矩阵、 softmax权重、维度投影这些术语绕晕,其实根本没那么复杂。
你要读一篇1000字的行业报告,不会盯着每个字逐字死磕对吧?你会下意识拆分角度:有人抓政策表述,有人算营收数据,有人盯竞品动态,最后把这几个人的笔记拼起来,比你一个人从头到尾逐字读要快得多,对核心信息的把握也更准。
多头注意力干的就是这件事——把原来一个人要干的”找文本内词语关联”的活,拆成好几个并行的”小分头”,每个小分头只负责抓某一类关联:比如有的头专门抓语法搭配,有的头专门抓实体之间的指代关系,有的头专门抓长距离的逻辑关联,最后把所有头算出来的结果拼到一起,就得到了对整个文本的完整理解。
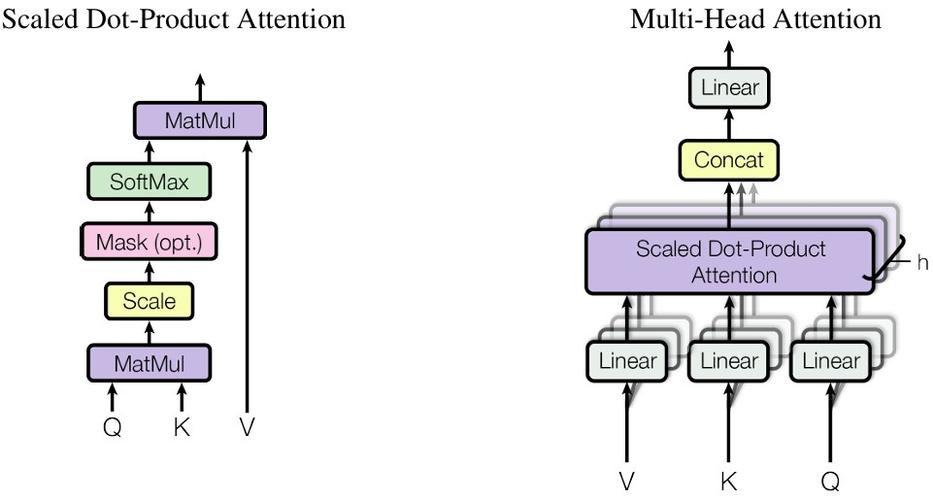 多头注意力QKV拆分计算流程示意图
但它从诞生第一天起就带了个天生的毛病:算得越细,算力烧得越凶。
最早的单头注意力时代,你要算100个词之间的关联,只需要做一次矩阵乘法,开销很低。拆成多头之后,哪怕每个头的计算维度砍到原来的1/8,你也要做8次独立的矩阵计算,最后拼接结果的时候还要再过一层全连接权重,整体的算力开销直接比单头翻了近两倍。更别说现在主流大模型动不动搞128头、256头的配置,上下文长度拉到128k的时候,光注意力层的算力开销就占了整个模型推理成本的70%以上——这不是什么技术优势,这是实打实的成本炸弹。
现在的行业现状:一半人在堆头数,一半人在拆算力
前两年大模型卷参数规模的时候,整个行业真的把多头注意力当万能药。
大家默认一个逻辑:头数越多,模型能抓到的关联维度越多,智能水平就越高。所以你能看到从GPT-3的96头配置,到后来开源模型动不动冲200头,甚至有团队测下来,128头比32头的模型在通用评测集上高2个百分点,就敢直接把模型整体的参数规模翻一倍去堆硬件。
但这两年算完账回过味来的团队都发现了不对劲:多出来的那近100个头,有差不多6成的头算出来的权重矩阵高度趋同。说白了就是你派了128个人去查资料,有70多个人的笔记全是抄的同一份,纯纯浪费人力和算力。
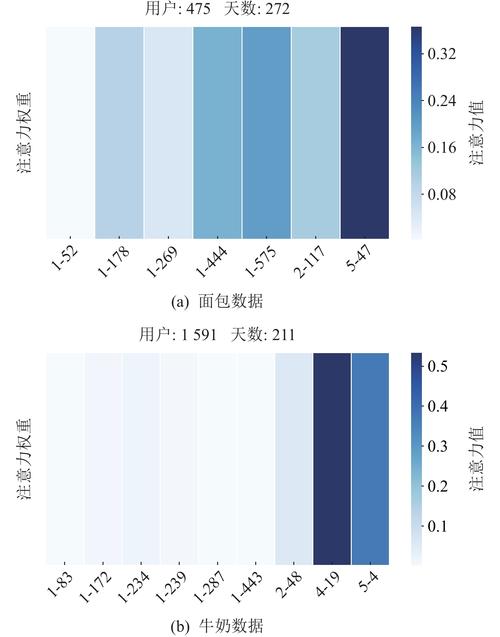 大模型不同头数注意力权重分布热力图
现在整个行业的动作其实特别分裂:一半的团队还在跟着评测榜的指标堆头数,毕竟只要分数涨了,就能去资本市场讲新的故事;另一半从一开始就算推理成本的团队,早就绕开了”堆头数”的死胡同——你现在听到的FlashAttention、PagedAttention、稀疏注意力、线性注意力,这些技术没有一个是真的改了多头注意力的核心逻辑,全是在给原来的高计算量打补丁。
比如FlashAttention根本没有减少计算量,只是把原来来回在显存和内存之间搬运计算数据的流程省了,相当于原来你每次查资料都要把书从图书馆搬回家,看完再搬回去,现在直接在图书馆的阅览桌上算,省了来回跑的时间,但是你要读的书、要算的内容一点没少。至于稀疏注意力,更直接——原来每个词要和所有其他词算关联,现在只和排名前10%的强相关词算,剩下的直接跳过,算出来的效果差不了多少,算力直接砍到原来的1/10。
绕不开的坎:多头注意力的成本账,迟早要算到C端头上
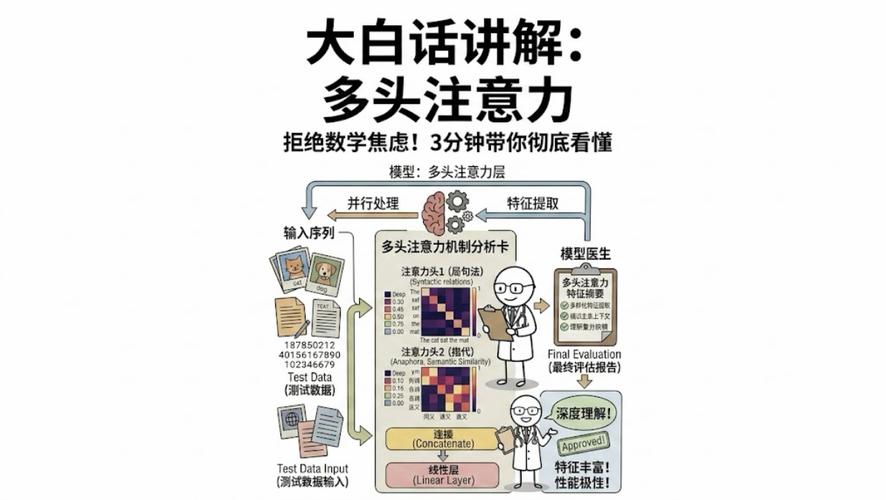 绕不开的坎:多头注意力的成本账,迟早要算到C端头上
现在很多人说大模型的推理价格已经打下来了,从去年的几块钱千token降到现在的几分钱千token,普通人用得起了。但真要算长远的账就会发现,只要多头注意力的核心逻辑不变,成本的下降空间迟早会摸到天花板。
核心原因特别简单:标准多头注意力的计算开销,是和上下文长度的平方成正比的。你想把上下文从4k拉到128k,不是翻32倍的算力,是翻1024倍。
之前接触过一个做本地AI助手的创业团队,去年本来想做个”能读完整本《红楼梦》陪用户聊剧情”的功能,算完账直接放弃了:原来跑4k上下文的时候,用户用RTX3060显卡就能流畅跑,要跑128k的话,得换RTX4090,相当于每个用户要多掏3000块的硬件成本,这账根本算不过来。
更麻烦的是,长文本场景下多头注意力的”注意力稀释”问题,到现在都没有完美的解决方案。比如你给AI的初始prompt是”写一篇关于养猫的科普文章”,等它读到10万字的参考资料之后,最开始的”写养猫科普”的指令权重已经被稀释到几乎可以忽略,最后输出的内容可能跑题到火星上去。现在大家吹的那些”长文本理解能力”,本质上都是靠在中间层加了点缓存机制,不是从根本上解决了权重稀释的问题。
站在现在往3年看,多头注意力根本不会像很多人吹的那样,成为所有AI场景的通用底座。
纯堆头数的路线已经走到头了。接下来的主流方案肯定是”动态头数”——简单的闲聊问题用2个头算,复杂的逻辑推理问题自动切到16个头算,不会再像现在一样不管什么问题都拉满256头的配置,光这一项就能把推理成本砍60%以上。
现在行业里吵得很凶的”注意力机制是不是AGI的必经之路”,3年内肯定会有明确答案。如果线性注意力的方案能在长文本推理上追上标准多头注意力的效果,那现在占了整个大模型生态9成以上的标准多头注意力架构,会像当年的循环神经网络一样,快速被替换掉——毕竟没有哪个企业会放着1/10成本的方案不用,抱着原来的技术死磕。
对普通用户来说,你根本不需要关心什么多头注意力、单头注意力的术语区别。3年之后你只会有一个直观感受:原来要花10块钱才能让AI读完你一整本工作文档的功能,到时候花1毛钱就能在你自己的手机上流畅跑。这才是技术落地的本质——不是让用户记住多少拗口的术语,是让用户用更低的成本拿到更好的结果。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:多头注意力:被吹到神坛的Transformer核心,到底卡在哪了?
文章链接:https://m.lfdjt.com/info_23_28106.html
 大讲堂
