 大讲堂

被拆穿的技术神话:核心逻辑其实没有任何玄学
之前的AI模型,处理文本或者序列数据,靠的是循环神经网络。说白了就是排队——一个词接一个词算,算完第一个再算第二个,串行跑下来速度慢不说,等处理到段落末尾的时候,早就把开头的指代关系忘得一干二净。 Transformer解决的第一个问题,就是不用排队了。 它的核心叫自注意力机制,逻辑说穿了很简单:处理一段内容的时候,每个元素都要和所有其他元素算一遍关联度,不用等前面的算完再跑后面的。比如句子”小明把刚买的猫抱给小红,因为她加班三天累到不想动”,这里的”她”到底指谁?老模型可能要靠额外的规则补丁去猜,Transformer会直接给”她”和”小红”的关联权重打最高的分,和”小明””猫”的关联度压到最低。
产业落地的真瓶颈:不是技术不够强,是成本扛不住
现在行业里绕不开的一个话题是Scaling Law——只要堆更多的参数、更多的训练数据、更多的算力,模型效果就会持续提升。这个规律在过去五年确实管用,直接把GPT系列的效果推到了普通人能感知到的”智能”水平。 但问题也跟着来了。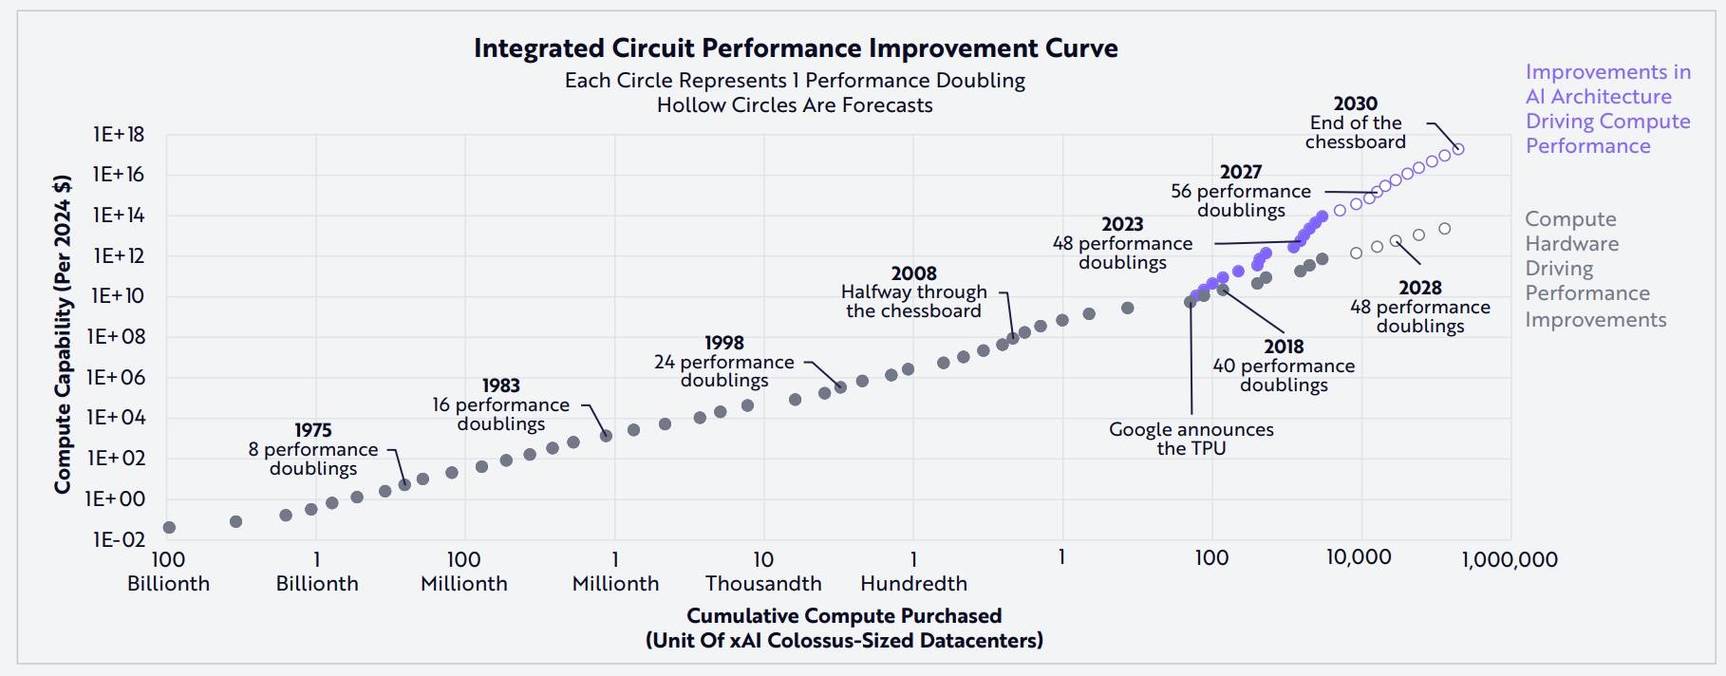
没人愿意摆到台面上的治理暗礁
Transformer的黑盒问题,从它诞生第一天就存在。 因为它的判断逻辑完全是从海量训练数据里”学”出来的,没有人工写死的规则,你根本没法追溯它为什么会输出某个结果。比如之前多次出现的大模型编造虚假信息、输出歧视性内容的问题,厂商能做的只有事后加补丁,没法从根源上定位是哪部分权重出了问题。黑盒可解释性的缺失,是它进入医疗、金融这些强监管行业的最大障碍——你总不能让一个会随便编理由的模型,直接给病人开处方吧? 还有数据合规的问题。现在训练通用Transformer模型的语料,绝大多数是从互联网上爬的公开内容,里面有作家的作品、记者的报道、论坛的用户发言,这些内容的版权归属根本没有理清。过去一年,全球已经有几十起作家、媒体起诉大模型厂商的案件,要求赔偿未经授权使用内容的损失。更不用说能耗问题——训练一个顶级的Transformer模型,耗电量相当于一个中型县城一年的居民用电量,对应的碳排放早就引起了欧洲监管机构的注意。 我之前参加闭门行业会的时候,有个做合规的朋友吐槽,现在的大模型厂商就像十年前的共享单车企业,先把摊子铺出去占市场,等监管找上门了再想办法擦屁股。 聊点实在的,未来三五年,Transformer不会变成什么能统治世界的通用人工智能,也不会像有些技术博主说的那样,马上被新的架构淘汰。 几个很明确的判断: 第一,无脑堆参数的时代马上要结束了。现在Scaling Law的边际效益正在快速衰减,从70亿参数到700亿参数,模型效果能提升一大截,但从700亿到4000亿参数,提升的幅度已经小到很多场景感知不到。接下来的技术迭代方向,是怎么把Transformer的计算效率提上来——比如稀疏注意力、模型量化,让小参数的模型也能达到现在大模型的效果,把推理成本打下来。 第二,产业链的话语权会慢慢从上游往下游移。现在全行业都在抢英伟达的显卡,是因为Transformer的计算需求刚好匹配GPU的性能。等未来模型优化到不需要那么多通用算力的时候,不管是国产GPU,还是专门为Transformer设计的AI芯片,都会有很大的替代空间。 第三,垂直领域的落地会先跑通。那些需要封闭语料、合规要求清晰的场景,比如工业质检、医疗影像辅助诊断、企业内部知识库问答,会比通用大模型更早实现商业化闭环。毕竟这些场景不需要爬全网的公开数据,也不需要模型有什么天马行空的创造力,只要稳定、准确、成本可控,就有人愿意买单。 最后说句题外话。 2017年那篇Transformer论文的作者,当时写这篇文章,只是为了把机器翻译的速度提上去。他们肯定没想到,这个用来做翻译的小工具,后来会变成整个数字世界的底层基础设施。 技术从来都不是按剧本走的。 你永远不知道,下一个改变世界的东西,会不会就藏在某个没人在意的论文附录里。作者|大讲堂
排版|大讲堂
审核|白杨