 大讲堂

先把“微调”的神坛拆了
很多人对微调的认知,还停留在“把自己的私有数据喂给大模型,让它把这些知识都记住,变成专属的行业专家”。 错得离谱。 当前主流的微调本质上是“参数定向偏移”,根本不是让大模型学会新的知识。现在大家常用的LoRA、QLoRA这些微调方法,核心逻辑是完全冻结开源大模型的主干参数,只训练一个占原模型参数总量1%-2%的小型旁路矩阵,本质上是给模型的输出方向加个软约束——让它在碰到类似问题的时候,优先按照你想要的风格、边界来回答,而不是把你喂进去的训练数据真的“学进”模型的长期记忆里。 举个最直白的例子:你花了几千条自家客服的对话记录做微调,想让模型能准确回答客户关于退款时效的问题。但如果你的训练数据里根本没提你们公司去年刚改的“VIP客户24小时极速退款”规则,就算你把微调权重训到100%准确率,模型碰到相关问题还是会按照通用大模型的记忆,给你说个行业平均的72小时时效。别信那些吹“微调能让通用大模型变成你的专属行业模型”的销售,真那么神,OpenAI自己干嘛不把所有行业的模型都微调完了卖?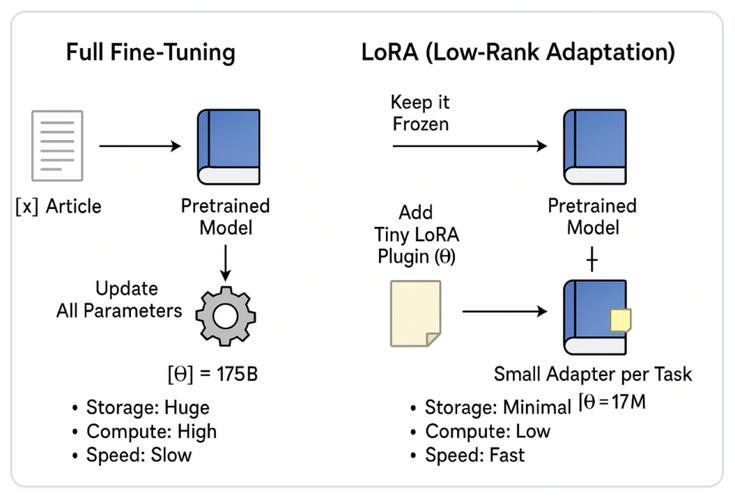
现在的微调产业,一半是生意,一半是泡沫
现在整个大模型微调的产业链,分层特别明显。 最上层是开源底座的提供方,比如Llama、Qwen、Mistral这些模型团队,人家根本不赚微调的钱,靠的是生态影响力吸引开发者;中间层是做微调工具链的服务商,把本来完全开源的PEFT、Axolotl这些框架套个可视化UI,改个名字,就敢对着企业收几十万的“专属微调部署费”;最下面是真正的落地客户,从金融机构到制造工厂,很多连自己要微调什么目标都没想清楚,就被“降本增效”的概念忽悠着先掏了钱。 我见过最离谱的一个客户,是做连锁零售的,说要给内部的员工培训系统做微调,结果准备了三个月的训练数据集,全是从官网扒的品牌宣传稿,连内部的门店操作手册都没整理全,最后微调出来的模型,回答新员工问题的时候,输出的内容比官网的新闻稿还空洞。 但这不代表微调完全没用。 真正把微调跑通的场景,从来不是什么高大上的行业认知,反而是特别细碎的需求:比如电商平台要让大模型的客服回复去掉过度亲昵的“亲”字,符合品牌正式沟通的定位;比如律所要让模型在审阅合同时,不要随便给用户下确定的法律结论,必须加上“本内容仅供参考,不构成正式法律意见”的固定免责话术;比如游戏公司要让NPC的说话风格符合古代仙侠的设定,不要蹦出来现代的网络烂梗。这些场景,只要准备个几千条标注好的样本,用开源工具跑几个小时,成本可能就几十块钱,根本不需要几十万的预算。
被所有人忽略的微调“隐性成本”
现在市面上所有讲微调性价比的内容,都在故意漏算一笔账:你看到的几十块、几百块的算力成本,只是整个微调流程里最小的一部分。 大部分人算成本的时候,只会算“训一次模型花多少GPU钱”,但从来没人提:你要整理高质量的、没有错误的训练数据集,要安排专人天天盯着模型的输出有没有跑偏,要每隔两三个月就重新微调一次——因为开源基础模型每隔几个月就会迭代版本,你基于旧版本训出来的微调权重,到新版本里根本不兼容,所有工作都得重来。 我之前接触过一个做金融科技的团队,去年基于Llama 2花了三个月时间,训了一套专门用来做理财产品合规审核的微调模型,结果今年Meta发布Llama 3的时候,他们试了下旧的微调权重,发现输出的合规判定结果偏差了快40%,之前三个月的工作直接打了水漂,光重新整理数据、重新训练的人力成本,就花了快50万。这部分的隐性成本,比最开始的算力投入高了10倍都不止。 更别说这里面藏着的安全和伦理风险。 很多服务商跟企业吹“微调是本地部署,数据绝对安全”,但实际上大部分中小服务商的微调流程,是把企业的私有数据传到自己的云端服务器上跑,客户根本没办法核实,这些数据会不会被服务商偷偷拿去训自己的通用模型。之前有个做医疗AI的朋友说,他们本来想把医院的脱敏病例数据拿去做微调,结果调研了一圈国内的服务商,发现没有一家能做到真正的“数据不出域”的无感知微调,最后只能自己掏几百万搭本地的算力集群。 还有更隐蔽的偏见放大问题。之前有个做招聘平台的团队,用过去五年的历史招聘数据做微调,想让模型自动筛选简历,结果上线之后才发现,模型自动把所有女性候选人的综合评分打低了15%——因为过去的招聘数据里,本来就存在对女性候选人的隐性偏见,微调的过程相当于把这些偏见直接固化到了模型的参数里,你要是不专门去检查,根本发现不了。 最后说点我自己对未来3-5年的判断。 我不觉得微调这个赛道会跑出什么百亿市值的巨头。 毕竟核心技术太透明了,开源的工具链越来越成熟,原来需要专业算法工程师花几周才能做完的微调工作,以后普通的业务人员拖个数据集进去,点个按钮就能完成。未来的竞争根本不是谁的微调技术更好,而是谁能帮客户想明白“到底要让模型改成什么样”——毕竟大部分客户连自己的需求都理不清,再好的技术也没用。 再往远了说,5年之后,可能根本没有“微调”这个单独的技术环节了。现在大家觉得微调是个很高深的技术,以后就像你现在用微信设置自定义表情包一样——你不需要懂什么参数、什么矩阵,只要把自己想要的输出规则告诉模型,系统在后台自动帮你完成调整,整个过程你连界面都看不到。 上周那个做SaaS的朋友跟我说,他把之前花120万做的微调项目停了,现在用开源的微调工具,找了个刚毕业的计算机系学生,花了两周时间,把客服回复的风格调整到位,总共花了不到5000块。 你看。 很多时候,所谓的技术壁垒,本质上就是信息差而已。作者|大讲堂
排版|大讲堂
审核|见微