 大讲堂

打开任何一个科技媒体首页,十个AI相关的头条,八个都绕不开大语言模型。出门见创投圈的朋友,三句话不离大模型,好像不蹭上这个概念,都不好意思说自己做科技。
去年大模型火的时候,连卖养生茶的老板都来找我问,能不能蹭个大模型概念做智能直播,我当时差点一口茶喷出来。太扯了。
技术的真相:不是魔法,是堆出来的概率游戏
很多营销号把大语言模型吹得像即将诞生的AGI(通用人工智能),仿佛明天就能取代所有白领上班。
大语言模型本质就是基于统计规律的下一个词预测器。核心架构基于Transformer的注意力机制,训练的时候喂进去几乎整个互联网的公开文本,让模型反复学习不同字词之间的关联概率,用户输入提示词,它就从第一个词开始,一个接一个概率最高的词往下拼,拼出一整段回答。
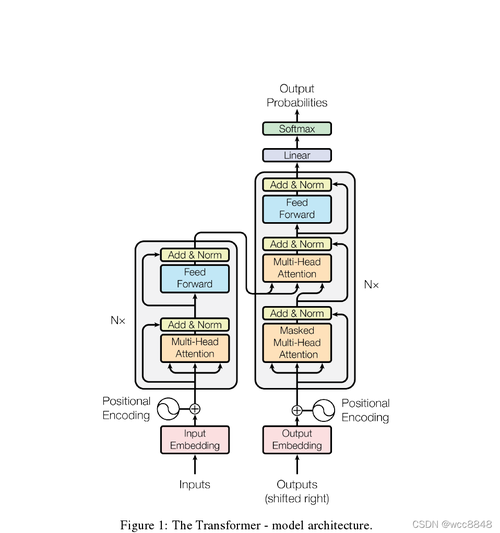
这个逻辑说透了一点都不神秘。你觉得它能写代码能写作文,其实它根本不知道自己写的是什么,它只是在按概率拼出最符合人类语言习惯的内容而已。
你让它算12345乘以67890等于多少,它十次有八次给你错结果。不是它不会算,是它根本就不理解“乘法”到底是什么,它只是见过太多乘法题,拼出一个看起来像答案的数字而已。
很多人吹大模型参数越大越聪明,其实参数增长到一定程度,性能的提升曲线早就平了。现在上千亿参数的模型,比百亿参数的模型,在很多日常任务上,体验差不了多少,成本却翻了好几倍。
产业落地:卡在幻觉和成本之间的现实
To C端的大模型产品,火了一年多,现在日活掉得厉害。大多数用户就是新鲜两周,问几个脑筋急转弯,生成几首歪诗,之后该用搜索用搜索,该写文档写文档,根本离不开老工具。
真正能落地赚到钱的,几乎都在To B端。
我接触过几家头部车企,已经把定制化的大模型放进了新车座舱,原来的语音交互听不懂连续指令,现在你说“把温度调低两度,打开窗户,放一首上周我听过的摇滚”,一次就能搞定,体验确实提升了不止一个档次。还有投行的研究部,原来分析师整理几十份研报要花两三天,现在大模型半个小时就能把核心观点提炼出来,效率翻了十倍都不止。
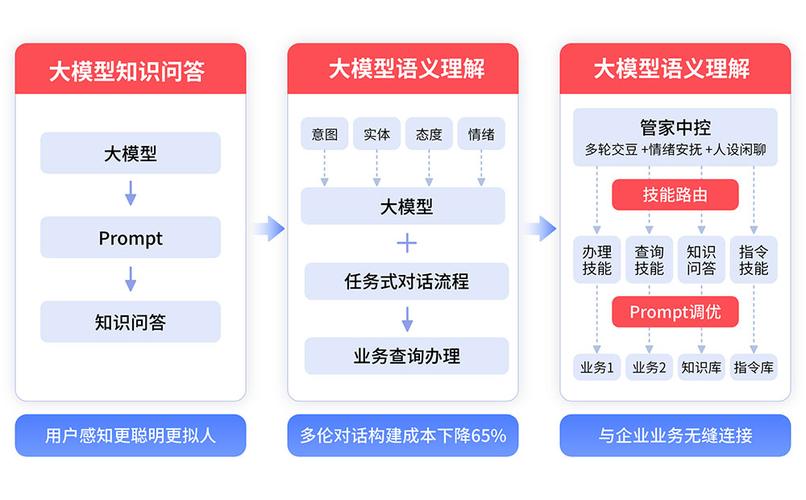
不过话说回来,现在To B落地也卡着两个过不去的坎。第一个就是幻觉。大模型瞎编事实这个事,到现在都没彻底解决。你让它帮律师整理案情,它敢给你编出根本不存在的判例,你敢用吗?第二个就是成本。一个千亿参数的大模型,单次训练的成本就超过千万,更别说后续推理的算力成本,中小客户根本用不起,就算用得起,算下来比雇个实习生还贵,为什么要用?
现在很多做通用大模型的创业公司,烧钱烧得飞快,却拿不出几个能赚钱的落地项目,全靠融资撑着。等资本的热潮退了,裸泳的人一抓一大把。
未来三到五年:泡沫破碎后剩下的机会
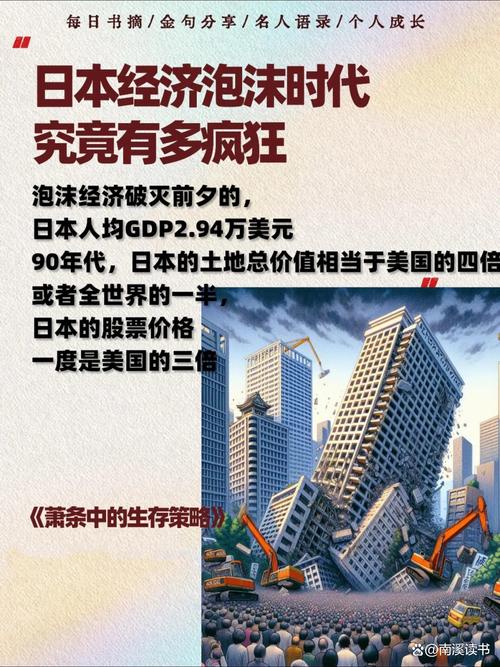
先说说风险和治理。现在大模型带来的问题已经越来越明显:深度伪造的谣言可以轻松骗过人,训练数据里的版权争议还没扯清楚,模型自带的偏见会放大社会歧视,各国都在抓紧出规则,未来不合规的模型根本没法上线商用。
说实话,我对未来三年大语言模型的格局判断很简单。
第一,通用大模型的赛道最后只会剩下三到五家头部玩家。这个游戏太烧钱了,从算力到数据到人才,全是重兵把守的门槛,中小玩家根本玩不起,要么被收购,要么转去做垂直场景,别想跟头部拼参数。
第二,垂直领域的轻量化微调才是大部分创业者的真正机会。你不需要做千亿参数的通用大模型,你只要拿头部的开源底座,针对法律、医疗、工业这些垂直场景,用专业数据微调,做一个够用、准确、便宜的垂直大模型,就能活下去赚到钱。比如做医疗的,只要能准确读懂病历整理医嘱,比通用大模型还好用,根本不需要它会写代码会生成诗歌。
第三,大语言模型不会取代大多数工作,它只会取代不会用大模型的人。现在已经有不少公司把文案、基础运营、初级代码这些工作,交给大模型+一个会提示词的员工来做,原来三个人干的活,现在一个人就能搞定,效率提升是实打实的。
大语言模型确实是最近十年AI领域最有冲击力的突破,它打开了一扇新的大门,没错。但别被市面上的神话冲昏了头。它现在还只是一个能力很强的工具,远不到颠覆一切的地步。潮水退去之后,真正做事的人才能留下来。
作者|大讲堂
排版|大讲堂
审核|知知