 大讲堂

2026年的RAG骗局争议
上个月深圳的大模型产业沙龙,我坐在第一排。散场的时候被一个知识付费赛道的老板拉住吐槽。他说去年花了四十八万找某AI团队做了自家平台的定制RAG,号称能给用户做一对一的个性化知识问答,结果上线三个月,用户投诉率超过40%,十道题有三道瞎编,把他积累十年的内容口碑都快砸没了。他当场就把对接的销售拉黑了,钱也要不回来。
这事不是个例。说实话,今年年初我跑了大半个国内的AI圈子,十个人聊RAG,有八个在骂,还有两个在骗。
公开数据显示,2025年国内公开披露的RAG落地项目,客户次年留存率只有21%。相当于每五个付费客户就跑掉四个。这个淘汰率,比共享风口那会还夸张。
很多人说,检索增强生成就是用来补大模型幻觉的补丁。客户有定制化知识需求,把文档塞进去,让大模型回答的时候先查文档,不就不会瞎说了吗?
骗鬼呢。大部分创业公司做的RAG,就是把文档切吧切吧剁了,扔去向量数据库存起来,搜索到啥算啥,连最基本的行业知识权重调整都不做。你把一本专业药典和一篇小编写的养生公众号文章放进去,权重一样,大模型当然会把公众号的瞎扯当正确答案用。
收几十万定制费,赚的就是信息差的定金。这群人把整个赛道的名声都搞臭了。
不过话说回来,骂归骂,为什么大厂小厂还都在拼命推RAG?真的是为了补幻觉吗?
藏在技术背后的产业链话语权博弈
把大模型进化比作生物演化,预训练得到的是写在基因里的先天本能,而检索增强生成就是个体后天获得的免疫记忆——不用每次遇到新病毒都重新进化一遍基因,只需要把新病毒的特征存进记忆库,下次遇到直接调出来识别就行。
这个逻辑,听起来就是个技术优化,对不对?其实本质是产业链利润的重新分配。
我们算一笔账,做百万级文档企业知识库的向量存储,成本是传统关系型数据库的7倍,单次检索延迟比传统存储高120毫秒,对年检索量百万级的企业来说,一年多出来的运营成本,足够招三个三年经验的算法工程师。
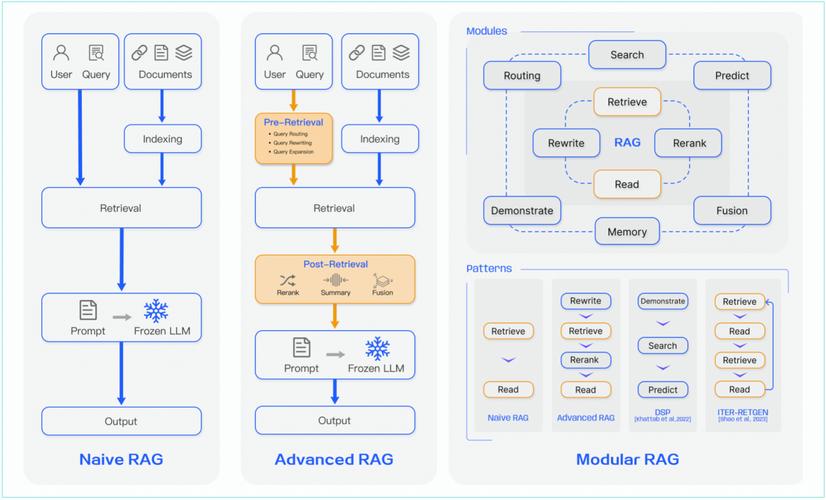
原来大模型厂商赚钱,靠的是按token收费,你用的越多我赚的越多。RAG出来之后,企业把核心数据存在自己的本地或者厂商的专有库里,大部分内容不用重复塞给大模型,token消耗反而下降了,大模型厂反而少赚了token的钱。那为什么国内的智谱AI、百度文心这些头部,去年都免费开放RAG定制工具给企业用?
说白了,抢的是数据入口。你把所有的核心业务知识、客户数据都存在我的RAG生态里,你还走得掉吗?智谱AI去年企业客户数涨了三倍,靠的不是大模型参数比别人大,就是靠免费RAG绑住了客户的数据,后续每年收的服务费,比一次性卖模型赚的多好几倍。
最有意思的是上游的向量数据库厂商,比如国内的Zilliz,去年国内RAG相关的向量数据库市场,他们占了超过42%的份额,毛利率超过80%,比大部分大模型厂商的毛利率还高30个点。这就是产业链博弈的结果——所有人都要做RAG,都要买向量存储的账,基础设施先赚了第一波大头。
原来大家卷大模型参数,卷训练成本,现在卷RAG,卷数据入口,逻辑完全变了。谁绑住了客户的知识,谁就拿到了长期的饭票。
落在普通从业者头上的真机会
很多人一提到AI新技术,第一反应就是我一个小从业者,轮不到我喝汤,都是大厂的游戏。不对。RAG这个事,反而给很多有行业积累的普通人开了新口子。
我上个月在杭州见了一个95年的小伙子,原来就是做跨境亚马逊运营的,干了六年,攒了一堆行业数据,去年辞职自己做了一个针对小卖家的选品RAG工具。他把过去五年亚马逊所有类目的排名数据、用户评论、供应链价格全部爬下来,自己做了权重标引,把选品的行业经验都揉进了检索逻辑里,年费只收399块,现在已经有两万多付费用户,一年赚的钱,是原来打工的五倍还多。
他说,大平台的通用大模型根本做不好这个事,因为他们不知道小卖家选品的时候最看重什么,哪些数据是没用的,哪些是命根子。只有天天泡在这个行业里的人,才能把检索的权重调对,出来的结果才有用。
这话戳到点子上了。RAG根本不是纯技术活,行业知识的权重调优,这个活AI干不了,大厂的算法工程师也干不了,只有懂这个行业的老人才能干。
原来大模型出来的时候,很多初级文案、运营、顾问都慌,说自己要失业了。现在RAG出来,反而创造了一堆新岗位:专门给垂直领域做知识库标引的标引师,专门调RAG检索逻辑的提示工程师,专门帮中小企业做RAG落地的行业顾问,这些岗位现在开价都比原来同级别高30%,还招不到人。
当然,坑也很多。那些只会套开源框架赚差价的骗子,今年估计就会被市场清出去,客户也不是傻子,上当一次不可能上第二次。
你手里攒了十年的行业经验和知识,打算什么时候做成自己的专属RAG?
作者|大讲堂
排版|大讲堂
审核|柚子