 大讲堂

为什么模型并行成了必选项?
大模型的参数增长速度,远快于单卡显存的增长速度。过去十年,单卡显存容量涨了大概10倍,大模型参数涨了快1000倍。这个缺口,只能靠拆分模型填。
模型并行本质就是一句话:把一个大模型拆成N块,每块放不同的卡上,分别计算再拼结果。和数据并行的核心区别是什么?数据并行是每个卡都有完整模型,切的是数据;模型并行切的是模型本身,数据是完整走下来的。
哪怕是现在大火的端侧大模型,要把70亿级别参数塞进手机,也会用到模型并行的思路——把不同层拆分到本地运存和云端显存,协同计算,对吧?这已经延伸到推理阶段了。
拆分模型的两种主流路径:怎么并行才高效?
现在工业界用得最多的两种拆分思路,张量并行和流水线并行,没有绝对的优劣,都是拿来搭配用的。
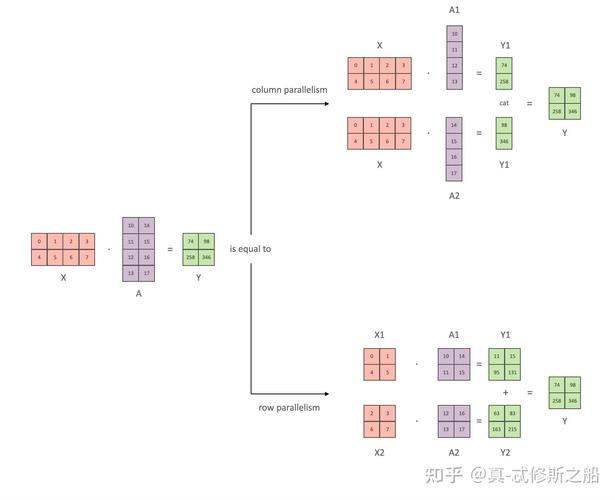
张量并行是横向切,把一个大的权重矩阵直接拆成小矩阵,每个卡负责一块。比如Transformer里的QKV投影矩阵,本来是一个大矩阵,拆成四块放四个卡,计算的时候每个卡算自己的部分,算完做一次全局通信汇总结果。思路简单,但问题也大,每一步计算都要通信,通信瓶颈被放得很大。卡越多,通信占的时间比例越高,很多场景下一半以上时间都在等数据传完,根本没在算。真的坑。
流水线并行是纵向切,按模型的层拆,把前几层放卡1,中间几层放卡2,最后几层放卡3,就像工厂流水线,卡1算完传给卡2,卡2算完传卡3,一路走下来。通信次数比张量并行少很多,只有层之间传激活的时候才需要通信,效率高不少。但也有问题,流水线会有空泡,就是上游卡算完了等下游,下游算完了等上游,卡的利用率上不去。
说实话,现在没人单独用某一种了。都是混合并行,模型并行加数据并行,张量并行加流水线并行混着来,根据自己的集群情况调拆分策略,把利用率拉到最高。OpenAI训练GPT-3的时候,就是搭的多层混合并行拓扑,才把1750亿参数塞下。
产业落地痛点与未来三年判断
现在模型并行已经是大模型训练的标配了,但门槛依然高得吓人,绝大多数玩家摸不到门槛。
第一个是硬件门槛。模型并行对卡之间的互联带宽要求极高,用普通的万兆以太网跑,慢到根本没法用,必须用NVLink或者IB互联,一套万卡集群光互联成本就占了三分之一还多,中小创业公司根本掏不起这个钱。现在很多号称做千亿大模型的小团队,其实都是用的静态拆分,偷工减料,实际训练效率低到发指。
第二个是软件门槛。拆分策略、通信优化、容错,每一步都是坑,很多团队凑够了卡,最后模型训练的利用率不到30%,相当于七成卡都在空转,太浪费了。调试一次错,几十万的成本就打了水漂。
从产业风险的角度看,现在整个技术栈都掌控在少数玩家手里,硬件是英伟达一家独大,成熟的框架也是几家大厂掌控,中小玩家根本没有议价权,整个大模型创业的入门成本被抬得很高,不利于创新。
不过话说回来,这个局面正在破。我对未来三到五年有几个明确的判断:
第一,模型并行的技术会快速下放到中小团队。现在已经有DeepSpeed、Megatron-LM这些开源框架把大量优化做了封装,未来会越来越易用,不需要你自己手动调拆分策略,框架会自动根据你的硬件情况做最优分配,再过两三年,可能小团队拿几十张中端卡,就能训自己的千亿参数模型了。
第二,硬件厂商会专门针对模型并行做优化。现在不少国产AI芯片已经在片间互联上堆料了,就是为了抢模型并行的市场,未来互联成本会降下来,不会像现在这样,互联比卡还贵。
第三,模型并行会变成云服务的标准能力。你不需要自己攒集群,直接在云上申请,云厂商给你做好了互联和优化,按训练步数付费,小团队也能玩得起大模型,不需要砸几个亿进去搭集群。
大模型不是只有大厂的游戏,模型并行就是撬开这个格局的核心技术之一。等门槛降下来的那一天,才会有真正百花齐放的创新。
作者|大讲堂
排版|大讲堂
审核|白杨