 大讲堂

2026万卡招标的三倍价差
今年开春,国内十家主流大模型厂商联合发起万卡训练集群的公开招标,标书刚挂出来,业内就炸了。同规格的需求,端到端跑通一个70B参数模型,头部集成商报出1.2亿的总价,而深圳一家刚做了两年分布式的创业公司,报价只有3800万。
差了三倍还多。
所有人第一反应都是,报价低的那个是不是偷换了卡的型号?用旧卡翻新骗标?查下来根本不是。卡都是全新的H800,交付周期还比头部厂商短了半个月。为什么差这么多?说白了,贵的那部分钱,大半不是花在算力上,是花在传统分布式架构的无效通信损耗上了。
说实话,我最早听到这个报价差的时候,也吓了一跳。之前所有人都在喊,大模型训练卡脖子,卡的是买不到先进芯片。原来就算给你一模一样的芯片,不同的分布式训练方案,能把总成本差出三倍。
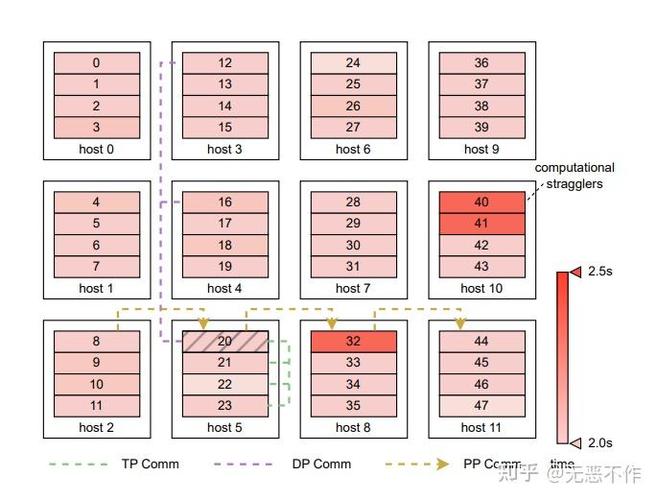
很多人对分布式训练的理解,还停留在“把一百张一千张卡堆在一起,一起跑模型”。就像拼乐高,零件够了拼起来就行。真做过的都知道,那堆卡凑在一起,一百张卡能跑出八十张的活,已经算顶级水平。一千张卡能跑出四百张的活,都能拿顶会论文了。
剩下的算力都耗在哪了?卡和卡之间传数据啊。你梯度算完了要传给所有卡同步,更新完参数再发回来,一堆卡挤在有限的通信通道里,一半时间都在排队等数据,根本没在干活。对吧。
看不见的博弈:谁在赚分布式的冤枉钱
要讲清楚这里的底层逻辑,其实不难,我用古代军团行军打个比方。十万大军要往前线开进,你只有一条羊肠小道,先锋部队早就打完了,后面大部队还挤在山谷里挪不动步,人再多也发挥不出作用。好的分布式训练,就是给你修好多条平行的高速路,还安排调度员随时疏导车流,让每个作战单位都能准时赶到战场。
原来这个修路和调度的活,九成国内厂商都用英伟达的现成方案。从NVLink互联硬件,到NCCL通信库,全套打包买。英伟达收你多少钱?每一张卡,一年的license费就是1200美元,一万张卡就是一千二百万美元一年,折合人民币八千多万,这还不算互联硬件的溢价。
更狠的是,你的卡堆得越多,通信损耗越大,你要想维持基本的利用率,就得买英伟达更贵的高带宽互联配件,相当于你每多堆一百张卡,就要多付一倍的互联钱,这就是人家躺赚的商业模式。你越卷模型参数大小,人家赚的越多。
不过话说回来,国内大厂早就看不惯这套了。字节跳动近几年在自研分布式训练架构上下的功夫,外界知道的不多,他们的ByteMesh全对等拓扑方案,去年内部测1024卡跑70B模型,有效算力利用率从行业平均的38%拉到了62%。什么概念?相当于同样一万张卡,原来只能当三千八百张用,现在能当六千二百张用,直接多出来两千四百张卡的算力,相当于省了好几个亿的采购和租赁成本。
百度的百舸平台最近推的2.0版本,针对国产卡做的分布式异构优化,也把千卡集群的利用率拉到了60%以上。这不是简单的技术比拼,这是实打实的商业模式博弈。原来大家都是给英伟达交过路费,现在自己修路,过路费自然自己赚了。
你以为这个只是省点钱的事?不对。国内最近两年推国产GPU,为什么一直打不开大规模落地的局面?很大一个原因就是国产卡的互联带宽不如英伟达,原来的通用分布式方案适配不好,利用率上不去,就算单卡便宜,算下来总训练成本还更高。现在本土厂商把分布式框架的优化做上去了,就算互联带宽低一点,靠拓扑设计和动态调度就能补回大部分损失,相当于给国产卡打开了生存空间。这个意义比省几个亿大多了。
被重构的产业链,每个从业者都要变
很多人说,分布式训练是底层技术,跟普通算法工程师、跟中小创业者有什么关系?大错特错。技术底层的一点点变化,放到应用层就是天翻地覆的重构。
原来你要训一个大模型,核心团队里必须有两三个资深的分布式调优专家,专门解决卡死人的各种奇葩bug:梯度丢包、节点掉线、集群死锁…这些人年薪动辄两三百万,还挖不动,因为会调大规模分布式的人太少了。现在呢?成熟的分布式框架把这些问题都封装到底层了,自动调优,自动容错,一个刚毕业两年的算法工程师,就能带着几十张卡训一个十几B参数的模型,根本不用专门找人蹲在那调分布式。
原来的核心竞争力,现在成了免费的基础设施,自然不值钱了。我上个月跟一个做互联网科技的猎头朋友吃饭,他说现在大厂招资深分布式调优专家,年薪已经降了三成了,还没有之前那么多HC了,因为很多团队根本不需要专门养这么一波人了。
那对中小创业团队呢?2023年你要训一个7B参数的通用大模型,加上调参适配,总成本大概要120万到150万,2025年下半年,这个成本已经降到了45万左右,降了65%还多,大半都是分布式训练效率提升带来的。原来你要融个几千万才能启动大模型项目,现在融个几百万就能试错,小团队也敢碰大模型了。那些原来靠占着卡坑、攒着集群资源赚差价的中间商,现在日子越来越不好过了。
我一直觉得,过去两年大模型创业的卷,是不正常的卷。大家都卷谁能拿到更多卡,谁能租到更大的集群,根本没人卷模型本身的创意和应用落地。现在分布式训练把资源的门槛踩平了,真正能做出落地产品的小团队,才能用脚投票把靠资源堆出来的老玩家干下去。这个方向才是对的。
当原来靠攒卡堆出来的壁垒,被分布式技术一脚踢碎,你手里的那点优势,还能撑多久?
作者|大讲堂
排版|大讲堂
审核|柚子