2026-10-02 01:10:12 作者:大讲堂
大模型火了快三年,满网都是预训练、无监督、通用智能的口号。很少有人愿意再提监督学习这个老概念。
说实话,市面上90%以上已经落地盈利的AI应用,核心骨架都是监督学习。那些喊着旧范式已死的新势力,真碰到具体行业的落地需求,最后还是得回监督学习的框架找解法。
什么是产业级的监督学习,它的边界在哪
说穿了原理一点都不复杂。给模型喂一堆已经打好「正确标签」的数据,让模型学到输入和输出之间的映射规律。你给一千张打了「猫」「狗」标签的图片,模型学会了看到新图片就能说出是什么动物。你给一万份打了「 fraudulent」「正常」标签的交易记录,模型就能识别新交易里的风险。
就是这么朴素的思路,撑起来了AI产业过去二十年的商业化基本盘。从人脸识别闸机,到银行的反欺诈系统,到医院的肺结节影像筛查,全是监督学习跑出来的。
哪怕现在生成式AI爆火,你用的ChatGPT,背后对齐人类偏好的第一步,还是用人工标注的问答数据做监督微调。大模型是搭好了骨架,最后填肉校准还是得靠监督学习干活。
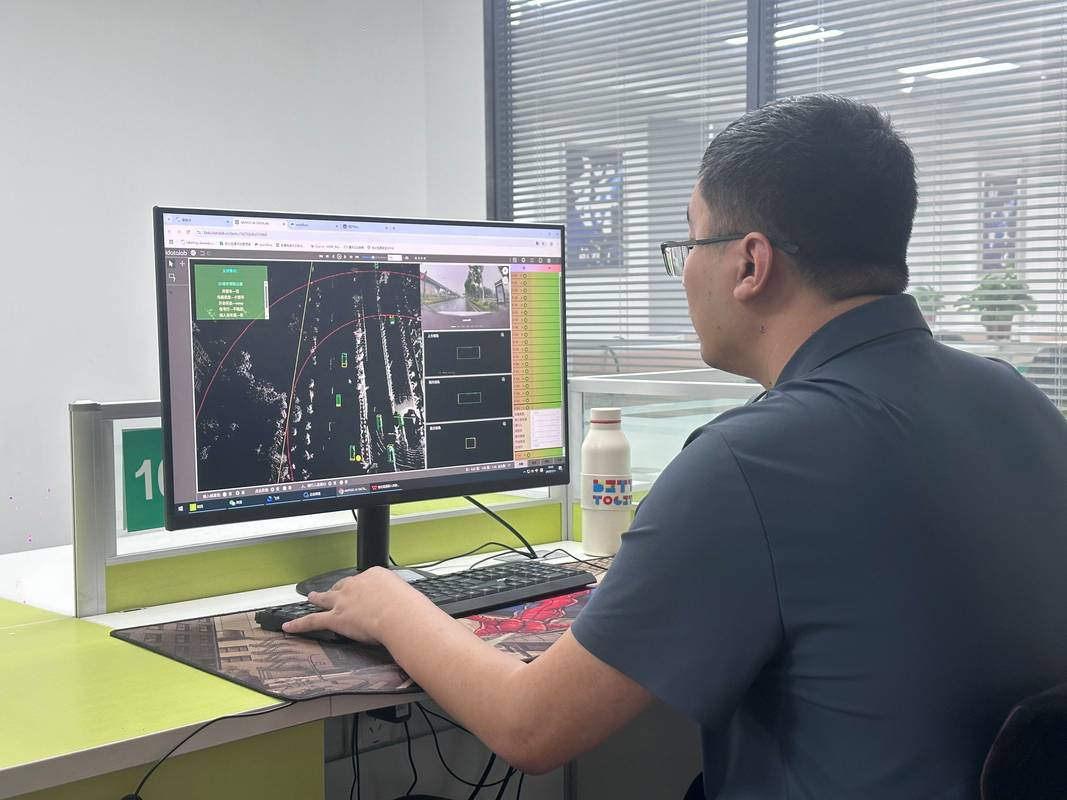 AI监督学习数据标注车间工作场景
它的边界其实很清晰:监督学习只能解决「你明确知道自己要找什么」的问题。你要找缺陷,就得提前把缺陷标出来;你要识别欺诈,就得提前把欺诈案例标出来。它不会自己凭空长出新的认知,所有能力都是从你给的标签里挖出来的。
产业化卡住的三重死结
现在很多人看不起监督学习,不是它没用,是它真的太烧钱,太容易卡壳。我接触过不下十个做行业AI的创业团队,最后死都死在监督学习的老问题上。
第一个死结,标签成本高到离谱。普通的互联网数据标注,一条几毛钱,看起来不贵。放到专业领域呢?一张罕见病的影像标注,找资深医生标一张要一两百块。一个工业生产线的缺陷样本,有些缺陷几个月才出一个,攒样本攒一年都攒不够能训模型的量,更别说标注了。
不少创业团队拿了天使轮,一半钱都砸去标注,最后数据还没凑齐,钱烧完了,公司没了。太常见了。
第二个死结,泛化能力差到发指。你在A工厂的生产线上训出来的缺陷检测模型,换到B工厂同类型的生产线,只要灯光角度变一点,材料换一款,准确率直接掉20%以上。换个新产品,所有标注全部推翻重来。团队大半年时间都在标数据,根本没工夫交付项目赚钱。
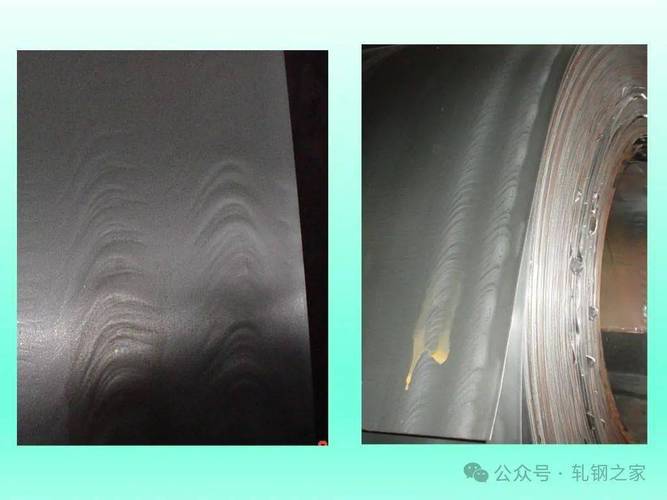 工业钢板缺陷监督学习样本对比图
第三个死结,分布偏移躲不开。训练数据永远是过去的,实际场景永远在变。你做网约车的派单模型,训练的时候是平峰的订单分布,到了节假日大堵车,数据分布全变了,模型直接懵。更别说极端场景,自动驾驶的事故场景,哪来那么多带标签的训练数据?
不过话说回来,这些问题不是今天才有的。这么多年,产业界也一直在找破局的办法。
未来三年,监督学习会变成什么样子
 未来三年,监督学习会变成什么样子
现在最大的进展,就是大模型底座加小样本监督学习的组合。原来你要几千个标注才能训出来能用的模型,现在有了预训练好的通用大模型,你只需要标几十个甚至十几个领域样本,做个监督微调,就能达到原来的效果。
已经有不少工业AI公司靠这个思路活的不错。广东那边做家具板材缺陷检测的团队,原来一款新产品要标上千张样本,现在只用标二十张,一周就能上线模型,成本直接砍到原来的十分之一。
这个方向接下来三年肯定会跑出来更多落地项目。监督学习不会被无监督取代,反而会变成大模型落地的最后一公里核心工具。毕竟大模型再通用,落到具体行业,你就是要它输出明确的结果:这个零件有没有缺陷?这份合同有没有风险?这些明确的需求,永远需要带标签的监督数据来校准,永远绕不开监督学习。
当然,风险也不能忽略。标签本身带的偏见,是监督学习绕不开的伦理问题。训练招聘筛选模型的数据里,过去十年招的男性多,模型就会天然给男性简历打高分,这种偏见藏在标签里,很难彻底清除。还有数据隐私,很多领域的标注数据涉及用户隐私、企业机密,怎么在合规的前提下做数据流转,还是一个没解决的问题。
整体看下来,未来三到五年,AI产业的基本盘还是监督学习。那些炒概念说无监督会彻底取代监督学习的,大多是想骗融资的。真能给企业解决问题、赚回真金白银的,还是会把监督学习玩明白,把大模型和监督学习结合好。
毕竟,AI落地从来不是什么炫技的事,能稳定赚钱解决问题,才是真的。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:监督学习:被大模型光环掩盖的AI产业基本盘
文章链接:https://m.lfdjt.com/info_23_23506.html
 大讲堂
