 大讲堂

GPT不是生产力革命,是算账革命
广州4A总监的酒局吐槽 上个月跟一个老兄弟吃饭。他是广州某头部4A的创意总监,酒杯刚碰完,他就开始骂娘。去年公司总部砍了他三分之二的创意外包预算。把原来12个人的全职创意组,砍到只剩3个。剩下的活,全部丢给公司新买的GPT企业版。 说实话,...
广州4A总监的酒局吐槽 上个月跟一个老兄弟吃饭。他是广州某头部4A的创意总监,酒杯刚碰完,他就开始骂娘。去年公司总部砍了他三分之二的创意外包预算。把原来12个人的全职创意组,砍到只剩3个。剩下的活,全部丢给公司新买的GPT企业版。 说实话,...
2026年刚开年,AI圈炸了一个不大不小的瓜。微信搜一搜推新版本,全量把语义排序模块下放到了手机端,用的不是大家喊了三年的7B端侧大模型,是出生快八年的BERT。一堆自媒体跳出来骂,说腾讯技术团队开倒车,放着新潮的生成式大模型不用,去捡十年...
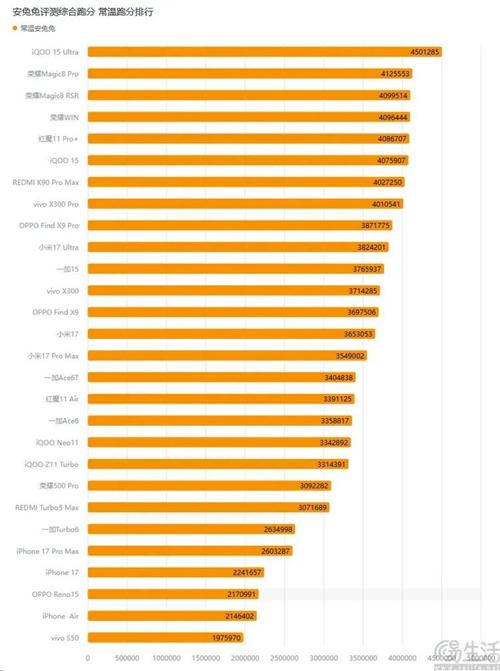
2026年那场刺眼的跑分争议 2026年刚开春,安卓阵营那场端侧大模型跑分骂战,现在想起来还滑稽。某头部安卓厂商新机发布,主推的端侧7B大模型堆了32个多头注意力,跑分比同行16头的高出快20%,发布会吹成“下一代端侧交互革命”。结果用户拿...
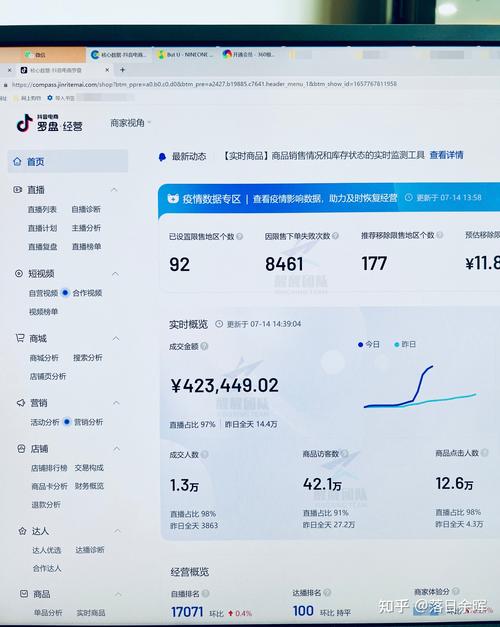
2026年流量战争的新规则:注意力明码标价 2026年初春,我跑杭州的餐饮商家交流会,一桌老板坐下来,全在骂抖音。 投流投不动了。 砸一百万,出去三千个到店。之前这个数是一万二。 平台客服说,算法改了,核心是全量上线了实时注意力机制。不再只...
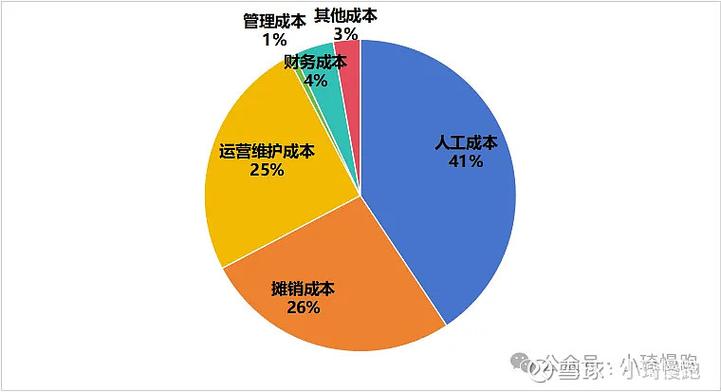
2026年降本潮下的公开秘密 2026年春,深圳大模型创业周的茶歇区,我听到两个创始人蹲在角落抽烟,聊的内容挺扎心。 其中一个刚拿了A+轮,说他们把核心的Transformer全注意力架构换成了基于线性Attention的变种,推理成本直接...
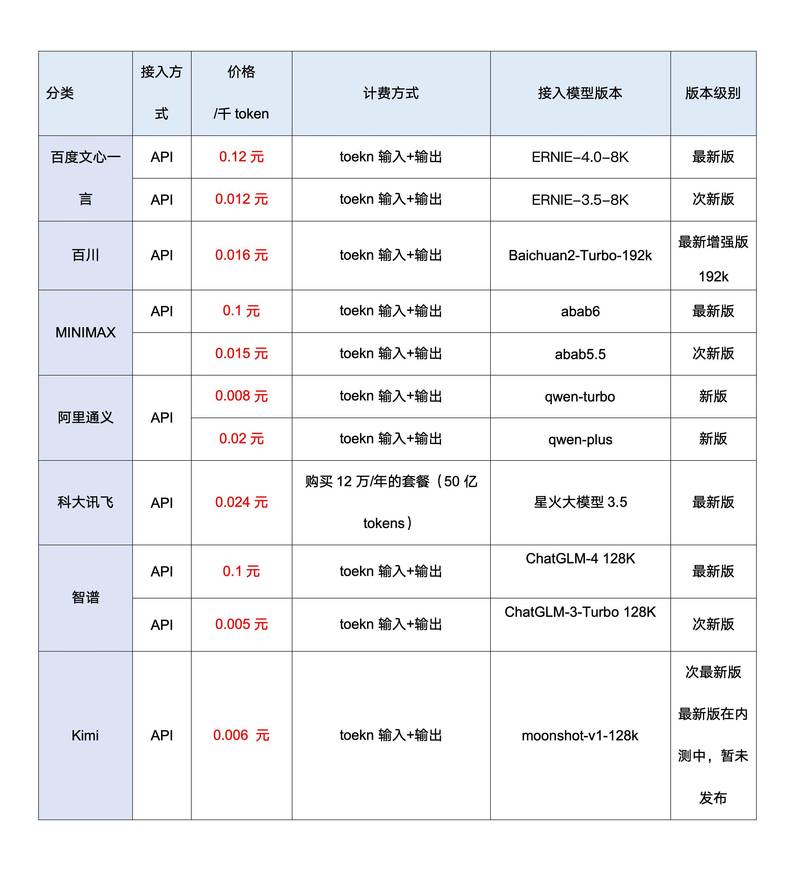
价格战炸出来的隐情 2026年开年,国内大模型圈子就炸了。 几家二线开源模型厂商突然把70B参数的推理报价打到了1元/万tokens,比头部大厂之前的报价低了快80%。一堆要落地大模型应用的企业客户直接用脚投票,半个月就转走了三成订单。 所...
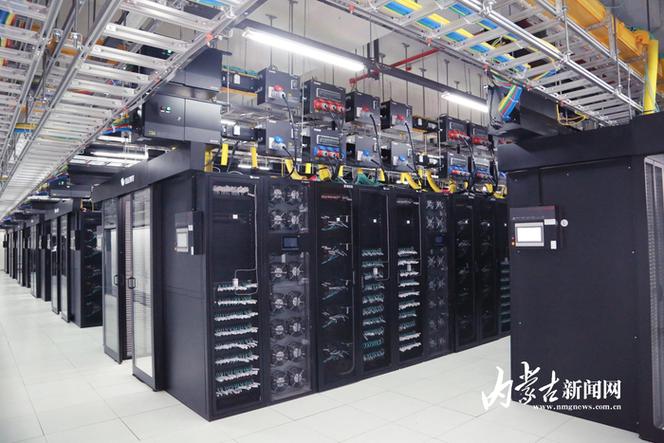
今年三月跟深圳一家做行业大模型的创始人吃饭,酒过三巡他把手机拍我脸上。后台截图停着三个训练任务,红字标着「等待节点分配」。 他说,等了三天了。本来要赶六月份的行业展会发版,现在IDC说给不出整柜的GPU,零散节点拼起来的话,通信延迟扛不住,...
2026年,城商行大模型的合规死结 今年开春我去杭州参加城商行的科技年会,饭桌上一半的CIO都在骂同一件事:总部要求今年必须上线本地化风控大模型,但是数据不能出省,更不能出本行机房,找了三家互联网巨头出方案,全是联邦学习,报价差了三倍,没人...
百模洗牌后的反常识结果 2026年开春,创投圈的酒局上没人再聊通用大模型了。 去年还抢着拿地建智算中心的玩家,现在忙着转租机柜。那些抱着“做中国的OpenAI”梦想拿到融资的团队,去年下半年裁了超过七成的算法岗,剩下的人都转去给本地制造业做...
刚开年的那场内部爆料,把抖音推流的底裤都扒了。2026年开年,抖音直播新上线的强化学习推流模型,直接引爆了主播圈的矛盾。 抖音推流争议炸出的真问题 骂声很大。中小主播集体喊冤,说新模型硬生生把自己的自然流量砍了三成,头部大主播的用户留存却涨...