 大讲堂

价格战炸出来的隐情
2026年开年,国内大模型圈子就炸了。
几家二线开源模型厂商突然把70B参数的推理报价打到了1元/万tokens,比头部大厂之前的报价低了快80%。一堆要落地大模型应用的企业客户直接用脚投票,半个月就转走了三成订单。
所有人都在问,怎么做到的?难道这帮人拿到了比大厂更便宜的H100供货渠道?还是说偷换了参数造假?
扒开底裤看,答案既不高科技也不意外。人家只是把模型拆明白了,靠模型并行把一张高端卡才能扛的活,分给了好几张低端卡一起干。性能降了不到5%,直接把成本砍了70%。
说实话,我听到这个消息第一反应是,早该这样了。之前不少大厂,抱着“堆钱就能出奇迹”的思路,一出手就是几千张H100塞机柜,结果呢?推理成本压不下来,To B单子报价比客户全年IT预算还高,这不扯吗。
四块消费级3090的采购总价不到两万,比一块H100便宜三倍还多,跑拆分后的70B模型推理,效率仅比全量放H100低不到6%。这个账,只要不是脑子发热堆指标骗融资,谁都算得过来。
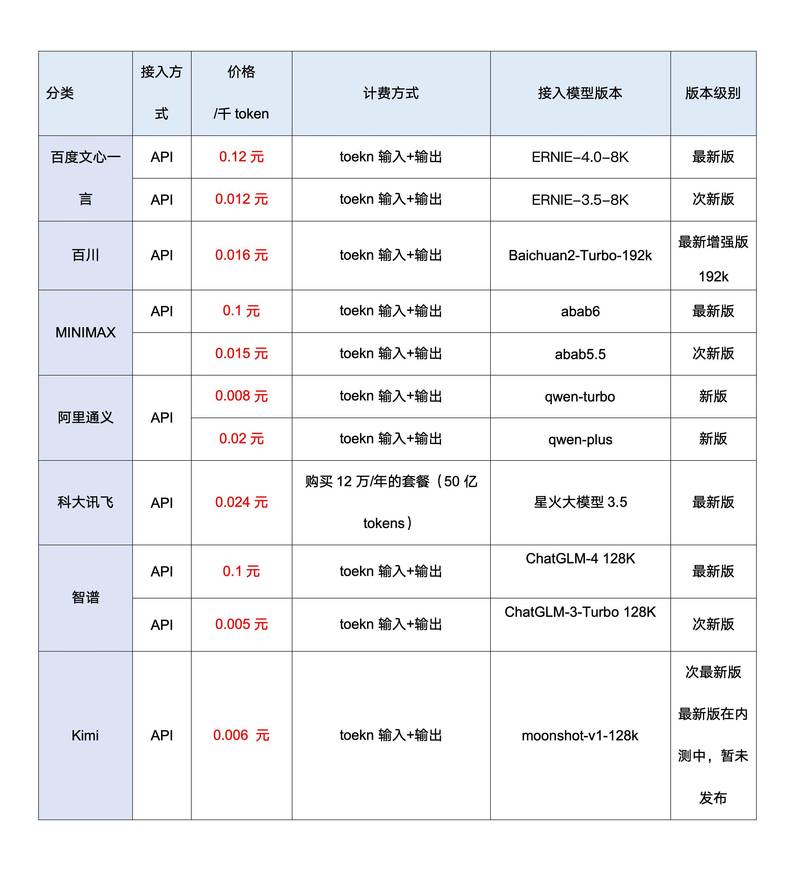
很多人说,模型并行不就是十几年前就有的老技术吗?有什么好说的。可老技术碰到新环境,玩出了新的生意,对吧?原来大家都盯着参数竞赛,比谁的模型大,谁卡多,谁融资多,根本没人在乎成本能不能落地,现在卷不动了,才回头抠老技术的价值。
拆模型背后的生意博弈
很多人觉得模型并行就是个技术活,是算法工程师调调框架的事。不对,这里头全是芯片厂商和大模型厂的利益博弈。
说两个国内本土的真实例子。
百川智能去年给国内某头部新势力车企做座舱大模型,客户要求12B参数的模型,功耗不能超过80W,成本控制在一千块以内,放一块高端车规芯片根本放不下。最后他们用张量模型并行,把模型拆成三块,分别跑在车上三块国产昇腾车规NPU上,刚好满足要求,总功耗比放一块高端芯片低了40%,成本直接砍了一半。
寒武纪的一个架构师上个月跟我喝酒,说现在国内训一个千亿参数模型,用模型并行拆分到128张国产芯片上,总用电量相当于一个30万人口中小县城一天的居民用电量,比整模型堆高端卡省了快60%的电。光是电费一年就能省出小一个亿。
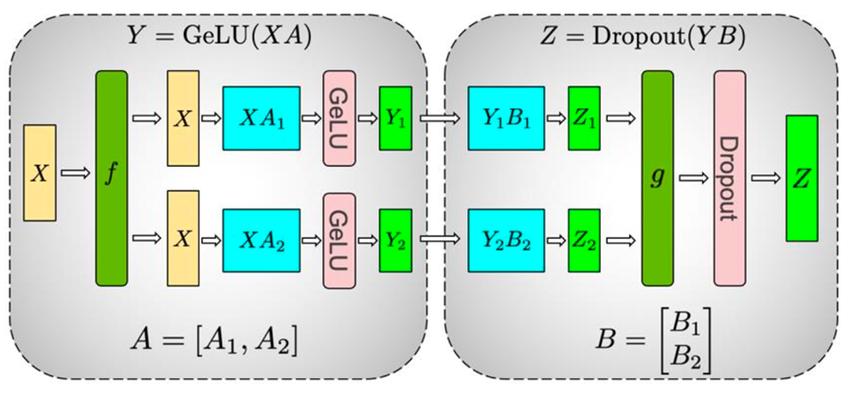
模型并行本质是什么?说个跨行业的类比,其实就像连锁餐饮的中央厨房。原来你要做烤全羊,非得把整只羊放在主店的大烤炉里烤好,再运去各个分店,不仅装不下,运到地方都凉了,成本还高得离谱。现在把羊切好分块,腌料配好,各个分店自己烤,出餐速度快,成本低,口味还没差多少。
这里头的博弈就很有意思了。原来英伟达赚的是什么钱?是你堆高端卡的钱,你模型越大,需要的显存越多,买的高端卡越多,人家赚的越多。你模型并行做的越好,同样的模型需要的高端卡越少,人家的营收就越少。所以你看,英伟达的并行框架从来都不会把最优的拆分方案免费开放给你,想要更好的利用率?加钱买企业级授权。
那国产芯片厂商为什么拼了命推模型并行?太简单了。国产芯片单卡显存拼不过英伟达,但是我靠模型并行,让你用多张中低端芯片就能跑得起大模型,这不就把市场撕开了吗?原来你买一张H100的钱,能买八张国产中低端卡,拆完模型性能还够用,客户当然愿意用脚投票。
这个方向我认为走偏了的,是那些为了参数竞赛强行堆卡的玩家,为了抢个“最大模型”的名头,不惜花几十个亿堆高端卡,结果落地成本根本下不来,最后只能变成融资PPT上的数字,毫无产业价值。
饭碗被悄悄改变的普通人
别觉得模型并行只是巨头玩的游戏,跟普通从业者没关系。这波技术落地,已经悄悄改了很多人的饭碗。
我认识一个从字节跳出来的算法工程师,原来在大厂做通用大模型调参,年薪也就八十多万,去年去一家做AI推理的创业公司专门做模型并行优化,年薪直接开到了180万,翻了一倍还多。现在整个行业,会拆模型、做并行优化的架构师,根本抢不到,大厂都在挖人,开价随便涨。
原来做IDC机柜租赁的,前两年都在抢一线城市核心地段的大机柜,放高端大模型集群,租金贵的离谱,很多小机房根本拿不到资源。现在呢?很多创业公司做模型并行,把大模型拆成很多小块,放在全国各地的小机房的低端卡上跑,小机房的租金反而比大机柜便宜三成,很多原本快要倒闭的小IDC,去年一年营收翻了两倍,赚的盆满钵满。
也有倒霉的。原来做二手高端英伟达显卡倒货的贩子,今年市场价跌了快三成,囤了一仓库A100、H100的老板,现在哭都没地方哭。原来一张二手A100能卖十万,现在六万都没人要,大家都去拆模型用中低端卡拼了,谁买你那贵的离谱的高端卡?
不过话说回来,这才是技术进步该有的样子。原来只有巨头玩得起的大模型,拆完了,中小公司也能用得起,创业公司也能做推理服务,也能抢巨头的生意,这不是好事吗?
卡脖子卡了这么多年,原来绕开高端卡垄断的路,不是造出来一块比H100更强的单卡,而是把模型拆好,把分工做好,用一堆不那么顶尖的卡,干成原来顶尖卡才能干的活。这个思路,其实很多行业都适用,对吧?
当未来所有大模型都被拆成细碎的小块,跑遍全国无数边缘节点,最先被淘汰的,会是卖高价卡的中间商,还是死守堆卡思路的老派巨头?
作者|大讲堂
排版|大讲堂
审核|阿辰