 大讲堂

大语言模型:被神话的通用智能,和没说透的产业真相
打开任何一个科技媒体首页,十个AI相关的头条,八个都绕不开大语言模型。出门见创投圈的朋友,三句话不离大模型,好像不蹭上这个概念,都不好意思说自己做科技。 去年大模型火的时候,连卖养生茶的老板都来找我问,能不能蹭个大模型概念做智能直播,我当时...
打开任何一个科技媒体首页,十个AI相关的头条,八个都绕不开大语言模型。出门见创投圈的朋友,三句话不离大模型,好像不蹭上这个概念,都不好意思说自己做科技。 去年大模型火的时候,连卖养生茶的老板都来找我问,能不能蹭个大模型概念做智能直播,我当时...
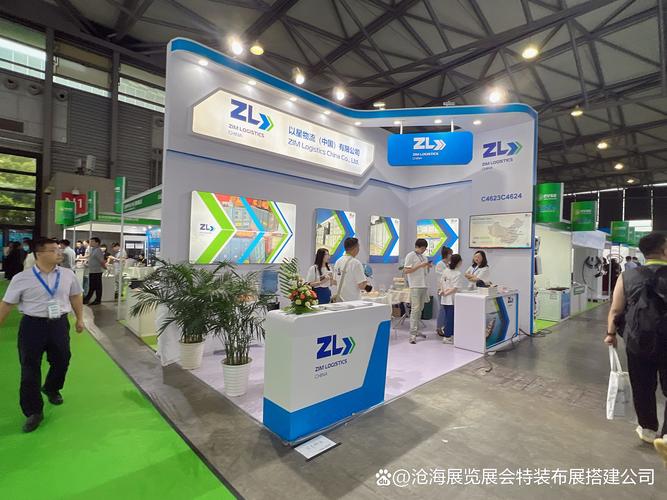
风口退潮,死在算账上 上周刚从深圳的SaaS行业年会回来。进门逛了半小时,吓了一跳。去年挤得水泄不通的LLM创业展区,今年空了一半。八个做垂直领域大模型的参展商,撤了六个,剩下两个,一个摆了展台没人看,另一个创始人蹲在门口抽烟。 烟圈飘得很...
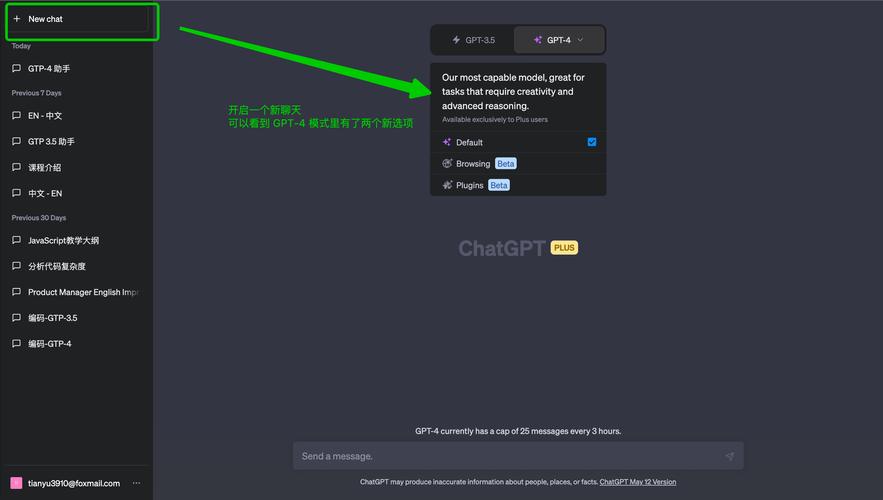
我家楼下巷口,开了十年的晨光打印店,老板老周去年冬天,把那台掉漆掉得连logo都看不清的联想台式机,卖去了废品站。换了台儿子淘汰的游戏本,桌面上多了个GPT的快捷方式。 我一开始还笑他,瞎折腾什么?一个打印复印的店,还玩上硅谷的高科技了? ...
你每天用的搜索引擎、输入法推荐、内容推荐流,底层都跑着同一个模型。很多人追着GPT、Sora的热点跑,却忘了,2018年谷歌放出的那个叫BERT的模型,才真正把自然语言处理从“凑效果”拉到了“能用”的阶段。 打破单向枷锁:BERT的核心改变...
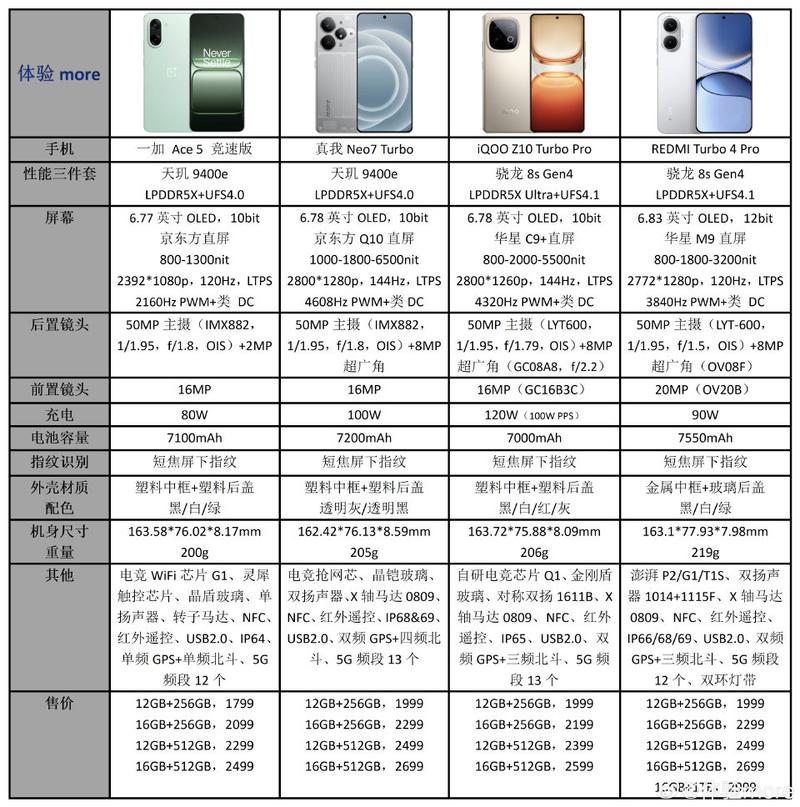
端侧大模型的参数内卷:多头头数成了营销话术 今年2026年春季手机发布会我连续看了三场,看得我浑身难受。 三家厂商发新的端侧大模型,几乎把「多头注意力」四个字打在了发布会PPT封面。A厂说我们上了64头,比上一代翻了一倍。B厂直接喊出128...
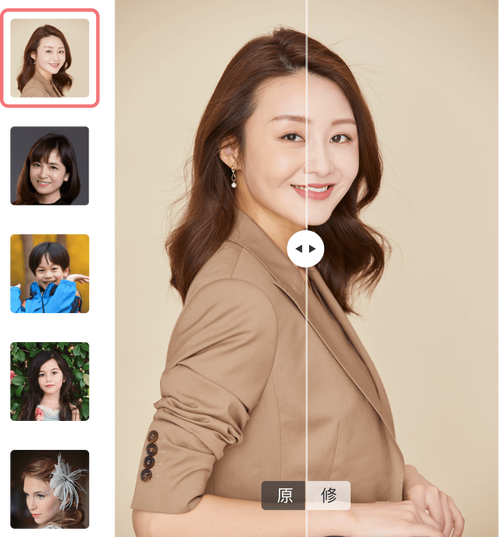
我上周找老陈拿修复好的老照片,推开门就看见他对着显示器拍桌子。 老陈干了十年照片修复,前两年赶AI的风口,把工作室从线下小门店搬进了老写字楼,本来想省点事,没想到麻烦一堆。电梯总是晃。 老陈的麻烦 最早用的开源AI修图模型,说起来神乎其神,...
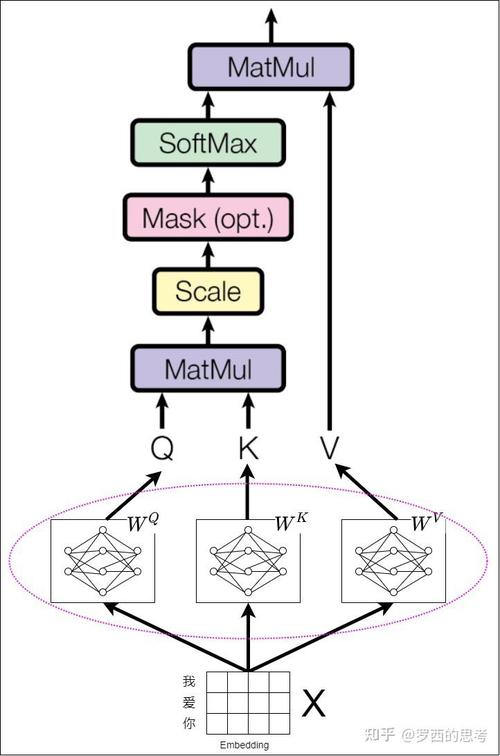
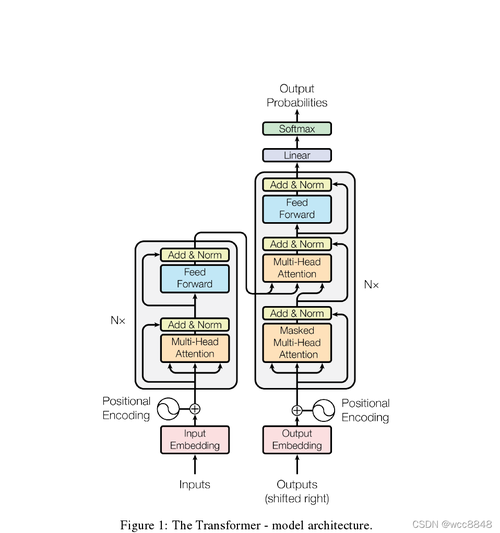
你有没有想过,为什么GPT出来之后,之前火了十几年的RNN、LSTM一夜之间就没人提了? 不是参数堆得不够多。是核心逻辑换了赛道。 自注意力到底解决了什么老问题? 做自然语言处理的老玩家都知道,早年处理序列数据,都是一个字一个字往前啃。RN...
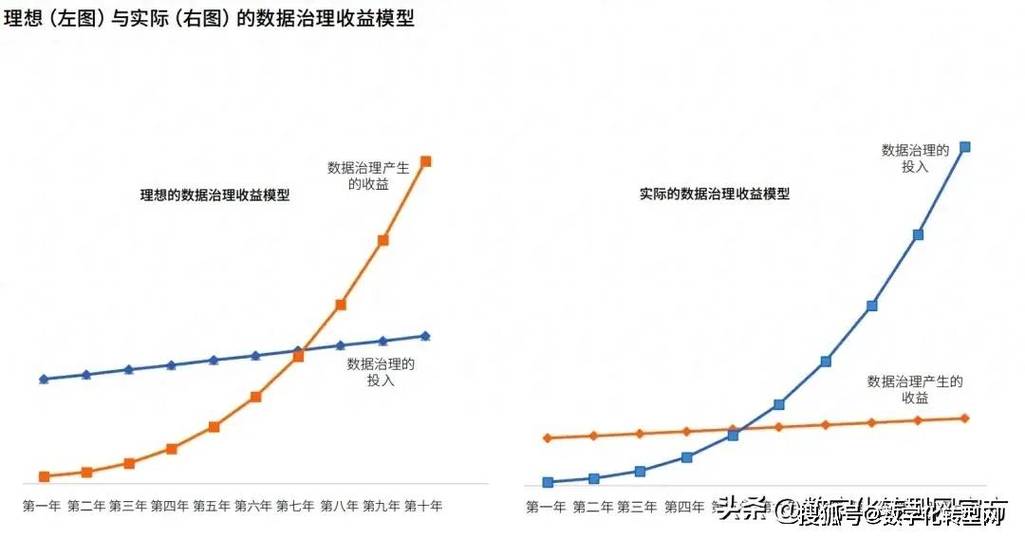
抢着上Transformer的中小玩家,正在集体交智商税 春节后跟一个做腰部电商的老朋友老卢喝酒,他拍着大腿骂街,一口闷了半杯白酒说,去年为了赶AI转型的KPI,把上线五年运行稳定的协同过滤召回模型全下了,全换纯Transformer架构。...
老周换完工服往机房走的时候,门禁系统跳出来的时间是22:17。郊区的风裹着稻田的味道往衣领里钻,这是杭州郊区智算中心少有的舒服时刻。 凌晨三点的显卡风扇声 机房里的温度永远恒定在22度,冷得像刚从冰箱拿出来的可乐。老周隔着厚重的隔音门都能听...
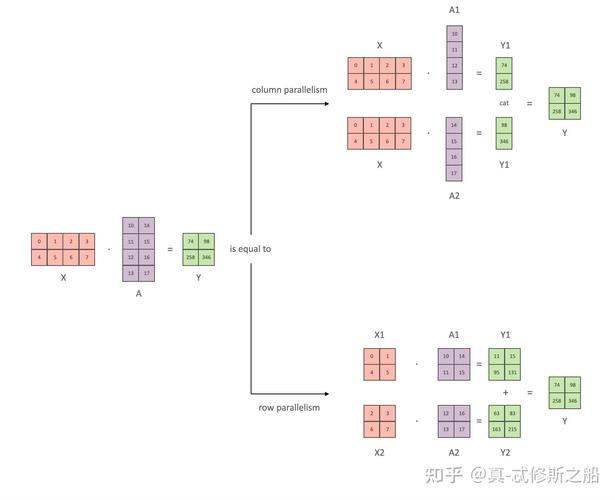
去年帮朋友算过一笔账,一个千亿参数的大模型,全精度存下来需要快4TB的空间。你找遍现在消费级甚至企业级的单卡,最大也就80GB显存。塞不下,怎么办? 最早的分布式训练玩的是数据并行,模型小的时候没问题,每个卡存完整模型,各跑一部分数据,最后...