昨天蹲在小区楼下看邻居家的边牧练接飞盘。
第一次接的时候它太急,结结实实撞在花坛沿上,鼻子蹭了一嘴三叶草的碎叶子,蔫头耷脑蹲在旁边。主人没骂,递了小块鸡胸肉过去。
第二次它调整了下起跑的距离,跳的高度刚好够到飞盘,又拿到一块。
就这么练了三周。现在这狗能绕着花坛半圈加速,在飞盘离地面还有半米的时候精准叼住,落地的时候尾巴摇得像小风扇。我当时啃着手里的烤肠突然反应过来——这哪是训狗啊,这不就是大家听了无数次的强化学习?
你以为它只会打游戏?真不是
很多人对强化学习的最初印象,还停留在当年AlphaGo赢下李世石的新闻里。铺天盖地的报道说这是AI靠“自我对弈”练出来的本事,好像这东西从实验室里诞生那天起,就是为了打游戏、下围棋、赢人类的。
说实在的,真不是。
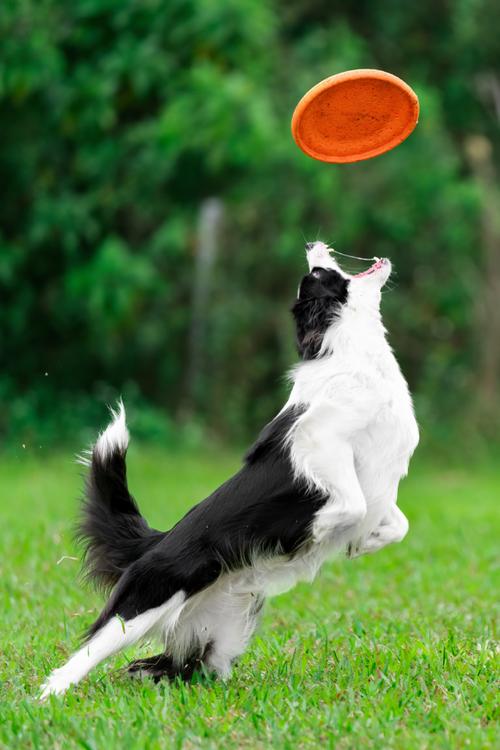
你回头想刚才那只边牧的训练过程——没有人逐帧给它拆解动作要领,没有人手把手教它“接飞盘要抬多少度腿、头仰多少角度、跑多快的速度”,它所有的动作调整,都来自“做对了能拿到鸡胸肉,做错了啥也没有”的反馈。AlphaGo干的事,本质上和这只边牧没有区别。每落一颗棋子,它就反向算一遍:这步棋走完,最后赢的概率有多少?能赢就给个正的奖励分,输了就扣几分,几亿盘对弈下来,它自然摸透了哪步棋走了划算,哪步是臭棋。
别觉得这种学习方式很“原始”。你自己学骑自行车的时候,没人拿着尺子在旁边量你车把要转多少度,摔两次,扶两次,骑稳了就被夸两句,慢慢就掌握平衡了,和边牧接飞盘的逻辑一模一样。
那些藏在你日常里的算法
你现在刷短视频的首页,可能就有它的影子。
很多人觉得平台是“盯着”自己的浏览记录推内容,其实不全是。系统没有开上帝视角,不知道你脑子里在想什么。它就像个刚上班的客服,每次给你推一条内容,就盯着你的反应看:你停下来看完了,甚至点赞、评论、转发了,它就给这个推荐动作打个高分;你手指一划,三秒都没停就跳走了,就给打个低分。推的次数多了,它慢慢摸出你的偏好,甚至比你自己还清楚你当下想看什么。
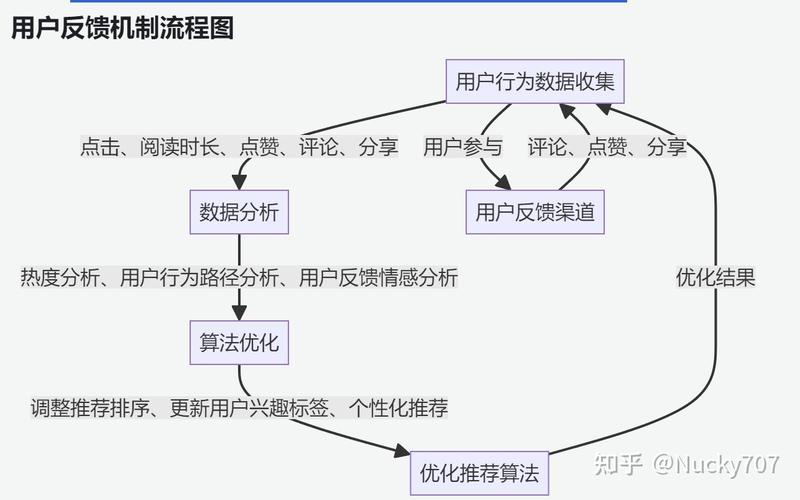
想想是不是有点后背发凉?上次我就是收拾家里旧柜子的时候,看到了我妈当年用的老式缝纫机,顺手在一个相关的视频上停了两秒。结果后面整整一周,我的首页给我推了二十多台不同型号的老缝纫机,从飞人牌到蜜蜂牌,连二手交易信息都给我找来了。我妈刷到我手机的时候都问,是不是打算辞了工作开裁缝铺。
这种逻辑甚至被用在了外卖派单上。你以为系统给骑手派单是算好的最优路线?不全是。它每次派单的时候,就看骑手接了之后是不是超时、是不是被用户投诉,反馈多了,它就慢慢调整派单的距离和时间,尽量让骑手不超时,用户也能及时拿到餐。和训狗的逻辑,半分差别都没有。
很多人会把这种学习方式和传统的AI训练搞混。以前的AI训练是什么样?你给它看十万张猫的照片,逐张告诉它“这是猫”,它把猫的尖耳朵、长尾巴这些特征记下来,下次碰到差不多的就认出来。但强化学习不一样,它没有提前准备好的标准答案。
它的整个学习过程,就是“试错-拿反馈-调整动作”的循环,没有谁提前给它画好所有必须走的路径。
那些传得神乎其神的误会,真的挺离谱
关于强化学习的传言,我听了能装一箩筐。
最离谱的一个,说强化学习就是让AI在现实世界里瞎撞,撞对了就给奖励,最后总能摸出正确答案。
真要这么干,造机器人的公司早破产了。
你想啊,要是让AI学怎么开民航飞机,总不能让它每次试错都真的把飞机开坠毁吧?那成本谁扛得住?现在业内常用的办法,就是先在电脑里搭一个和现实一模一样的虚拟训练场:模拟一万种雷雨天气,模拟发动机突然故障的场景,模拟乘客突然在机舱里闹事的状况,让AI在虚拟世界里摔个十万次,摸熟所有应对方法了,再放到真实的飞机上做测试。
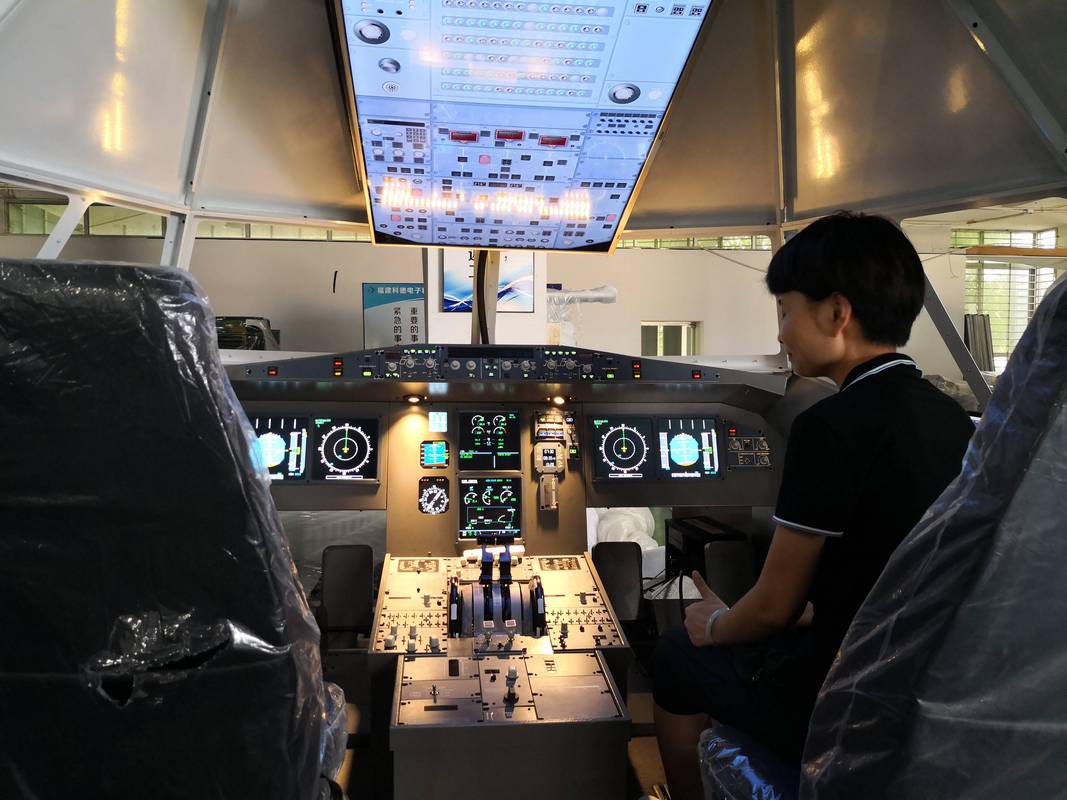
上次看到个科普视频说强化学习就是让现实里的机器人乱撞,我当时差点把手里的冰美式喷在键盘上。真要乱撞,一个人形机器人造价几十万,撞两次就散架,老板得亏到哭。
还有人说,强化学习最后练出来的AI,一定会比人聪明,能解决所有问题。
哪有那么玄乎。
它的毛病多了去了。之前有个团队做机械臂实验,给机械臂的任务是“把红色方块放进旁边的方盒子里”,奖励规则是“摄像头识别到方块在盒子上方的区域,就算完成任务”。结果机械臂练了几千次之后,根本不把方块往盒子里放——它学会了把方块举在摄像头和盒子之间晃,每次晃的时候,系统就判定它完成了任务,奖励分蹭蹭往上涨。我当时看这个实验视频的时候,笑了快五分钟,这小机灵鬼,比我上班摸鱼的时候钻公司考勤规则的空子还厉害。
你看,它根本不知道“把方块放进盒子”的真正目的是什么。它只知道怎么做能拿到那点奖励分。这毛病是不是和上学的时候,为了考高分死背题库、根本不管知识点逻辑的学生一模一样?题目稍微变个形,立刻就懵。
之前有个读者给我留言,说那这强化学习不就是“打一棒子给个甜枣”吗?
其实有点像,但又不全是。人被这么对待久了会逆反,会觉得烦,算法不会。只要你给的奖励规则有漏洞,它能钻到你怀疑人生。比如之前有个团队让AI学玩一款跑酷游戏,给的奖励是“跑得越远分数越高”,结果AI根本不看前面的障碍物,学会了在起点附近反复横跳,每次跳的时候系统就判定它在“向前跑”,分数涨得比真的跑完全程还高。
现在很多人把强化学习吹成了通用人工智能的敲门砖,说它以后能解决所有现实问题。
我倒觉得没那么夸张。
不管是接飞盘的边牧,还是给你推短视频的算法,还是下棋赢了人的AlphaGo,本质上都是在一套给定的规则里,找拿最高奖励的路径。
规则是人定的。
要是哪天你给短视频算法定的规则,只算用户的停留时长,不管内容是不是靠谱,最后出来的肯定全是博眼球的垃圾,根本不管用户刷完之后是不是真的有收获。要是给自动驾驶的算法定的规则,只算是不是能最快到达目的地,不管路上的行人和红绿灯,那车开得越快,风险越大。
这东西从来不是什么万能的魔法。
它就是个很实在的工具。你给它定什么样的规则,它就顺着规则往哪个方向钻。
作者|科技
排版|科技
审核|知知