2026-10-08 23:13:53
作者:
科技
上周六9月23号逛南京老门东,挤过满街卖梅花糕的队伍,拐进巷口一家小小的奶茶店歇脚。老板戴个黑框眼镜,闲得在那边敲笔记本,凑过去一看,屏幕上飘着一堆我眼熟的曲线,居然是强化学习的训练日志。
我吓了一跳,你一个开奶茶店的,还玩这个?
他挠挠头笑,说之前调定价调得头秃,索性瞎试,没想到真管用。
别听到「强化学习」就只想到AlphaGo下围棋
大部分人对强化学习的第一印象,就是AlphaGo把顶级围棋棋手杀得丢盔弃甲的名场面,觉得这是只有顶尖实验室、巨头AI团队才玩得起的黑科技,跟日常生活八竿子打不着。
其实真不是。
这个奶茶店老板的玩法很简单:把天气、周末/工作日、地段人流分成不同的环境状态,把不同奶茶的定价区间分成不同的动作,当天赚的钱减去原材料损耗算奖励——赚得多给正反馈,赔了给负反馈。模型跑了两个多月,现在每天的定价会自动跟着环境变:下雨天冷门款降个一块钱拉人流,周末热门商圈的招牌款涨个一块两块,反而比原来一口价赚得多。
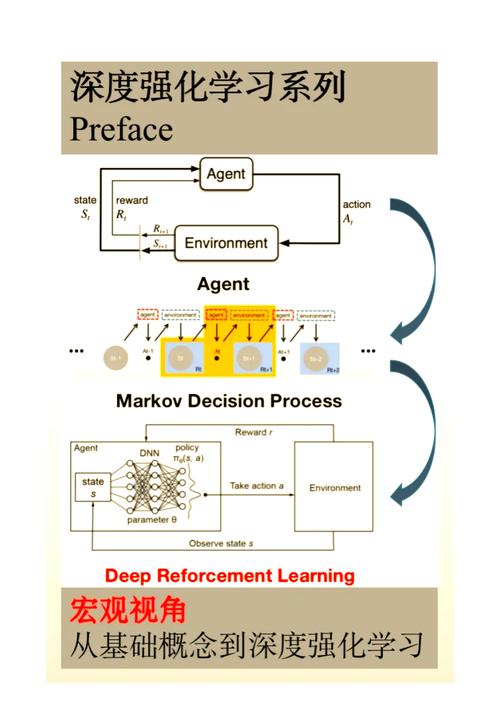 奶茶店动态定价强化学习逻辑图
是不是一点都不玄乎?说白了就是把老板天天试错调定价的过程,交给算法自动跑而已。原来老板要试大半年才能摸清楚的规律,算法一两个月就摸明白了,还比老板记得准,不会记错上周三雨天卖了多少杯。
强化学习最核心的逻辑,其实就是「试错赚奖励」
说实话我刚接触AI的时候,翻教材看什么马尔可夫决策过程、价值网络,绕得我头都大,后来蹲在奶茶店喝着桂花酿想明白,这不就是我们每个人从小到大天天在干的事吗?
你小时候学骑自行车。拐弯歪了撞到树,疼,这就是负反馈。走直了顺顺当当骑到路口便利店买到冰棒,这就是正反馈。摔个三四天,你自然就会骑了。
这个过程,就是活脱脱的强化学习。
没有老师提前给你标准答案说”你要把龙头向左打三度才能不撞树”,全靠你自己一次次试,攒出来经验,知道什么情况做什么动作能拿到最好的结果。和你上学时候做练习题不一样,练习题有标准答案,强化学习没有,它甚至还要你考虑长远奖励,不能只捡眼前的小便宜。
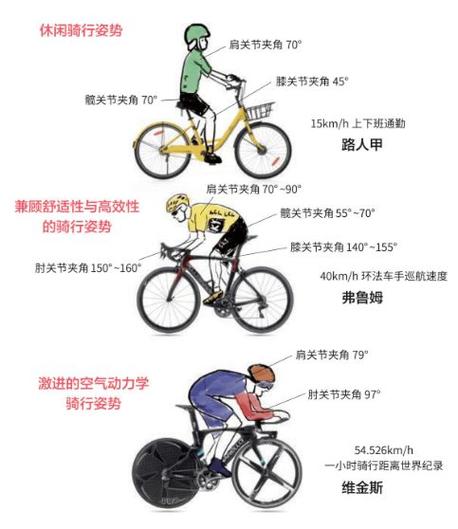 人类学骑自行车强化学习过程示意图
比如你玩开放世界游戏,现在你面前有两条路:一条是刷小怪拿10个金币,另一条是跑半小时开隐藏宝箱拿100个金币。新手会选第一条,成熟的强化学习模型会选第二条,因为它算得出来,长期总奖励更高。
换成人话,这不就是”不要为了眼前的蝇头小利放弃长远收益”嘛,哪有什么玄乎的。
别吹神了,强化学习有它解决不了的事
 别吹神了,强化学习有它解决不了的事
现在很多自媒体把强化学习吹得天花乱坠,说什么离通用人工智能就差一步,什么能解决所有行业的问题。我得泼盆冷水。它不是万能的,甚至有很多天生的缺陷。
第一个就是试错成本。你让强化学习学开自动驾驶汽车,总不能真让它在路上撞个几百上千次吧?撞死撞坏了谁负责?这个成本谁都扛不住,所以现在很多自动驾驶的强化学习,都只能先在模拟器里练,练完了再挪到真车上,就是怕试错成本太高。
第二个就是环境变了它就懵。刚才那个奶茶店老板的模型,如果巷口对面开了一家新的连锁奶茶店抢生意,原来的模型就废了,得重新训练。人能很快反应过来”哦对面开了新店我得降价拉客”,模型得重新试好多次才能摸清楚新规律。
不过话说回来,它也早就悄悄钻进你生活的每个角落了,只是你没发现而已。你刷短视频,为什么越刷越停不下来?背后的推荐算法就有强化学习的功劳——你点进去看了十分钟,就是给算法说”我喜欢这个,继续推”,你划走不到三秒,就是说”我不喜欢,别推了”,几次下来,算法就比你自己还懂你喜欢看什么。
网约车的派单也是。怎么派单才能让司机少空跑,乘客少等车,平台整体的收益最高?原来都是靠人工定规则,现在很多都是用强化学习调,比人工定的规则灵活多了。
那天老板跟我说,他刚开始调模型的时候也踩过坑,刚开始只把当日营收当成奖励,结果模型为了赚更多钱,把所有奶茶都涨了两块,结果一个星期下来,老顾客都走光了,营收掉了一半。后来他改了规则,把老顾客的复购率也加进去当成奖励,模型慢慢就摸出来了,不能涨太狠,要留着客人回头,现在反而每个月比原来多赚小两万。
你看,连AI都能明白的道理,很多做生意的人反而不明白,就盯着眼前那点钱,把客人都坑走了。
那天我喝了老板新调的桂花酒酿,确实好喝。他说原来一半时间都在想定价,现在算法帮他干了,他能天天蹲在店里试新配方,跟老顾客聊天,反而舒服多了。
哪有什么高高在上的黑科技,不过是把人过日子试错的道理,写成代码交给机器帮你干活而已。对吧?
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:巷口奶茶店老板,偷偷用强化学习赚了钱?
文章链接:https://m.lfdjt.com/p/keji/a/7961.html