它不是只会生成AI内容的大怪物
很多人提起深度学习,第一反应就是现在能写文案画图的大模型,好像这技术是近几年才从天上掉下来的。其实早在上世纪五十年代,就有人提出类似的思路了,九十年代用来认信封上的手写邮政编码,帮邮局分拣信件,那就是最早落地的深度学习应用。
说白了,它和传统写程序的思路不一样。传统程序是人把规则一条条敲进去,比如认数字,人告诉计算机“1是一根竖线,0是一个圆圈”,碰到写得歪歪扭扭的,就认不出来了。深度学习呢,是给计算机喂几千几万张写好的数字,让它自己找规律,慢慢试错改自己的判断,练熟了以后,哪怕字写得歪到姥姥家,它也能认对。
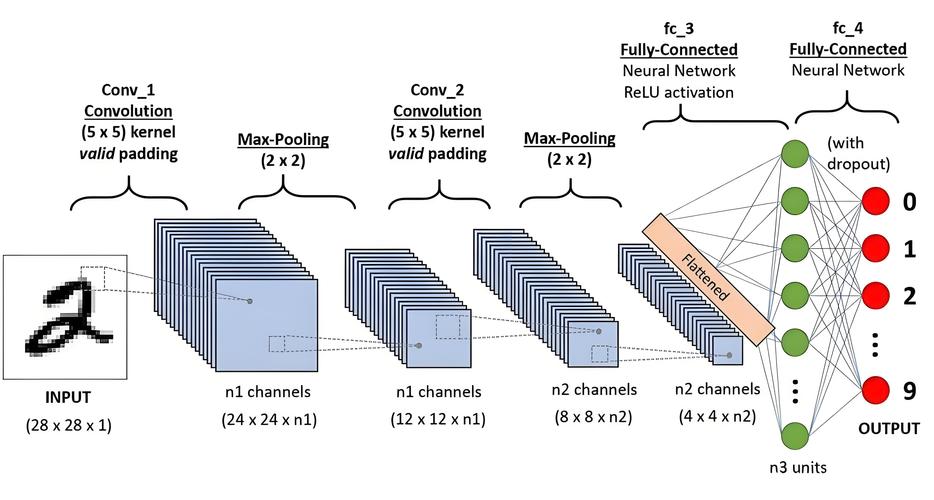
我刚接触这东西的时候,被一堆术语唬得头大:卷积、反向传播、激活函数…好像没个博士学位都摸不着门。后来才想明白,其实整个逻辑和我们上学刷题没区别:喂数据就是做题,改模型就是改错题,练得多了,自然就会了,哪有那么玄乎。
好多自媒体把它吹得像能统治世界的黑科技,其实它就是个工具,帮我们处理那些人懒得找规律、也找不清规律的事。比如从几亿条内容里找出符合你喜好的推荐,这种事让人来干,干到退休都做不完,交给深度学习,几十毫秒就出结果。
普通人对它最常见的三个误区
第一个误区,深度学习必须要有几亿条数据才能跑,小项目碰都碰不得。
真不是。我前阵子帮一个开宠物店的朋友做过一个认猫品种的小工具,就拍了不到一千张不同品种猫的照片,训练出来的模型认猫的准确率能到九成多,足够他给客人做科普用了。现在很多轻量模型,小数据集就能训出能用的结果,不是只有巨头玩得起。
第二个误区,深度学习是完全黑箱,没人知道它到底是怎么得出结论的。
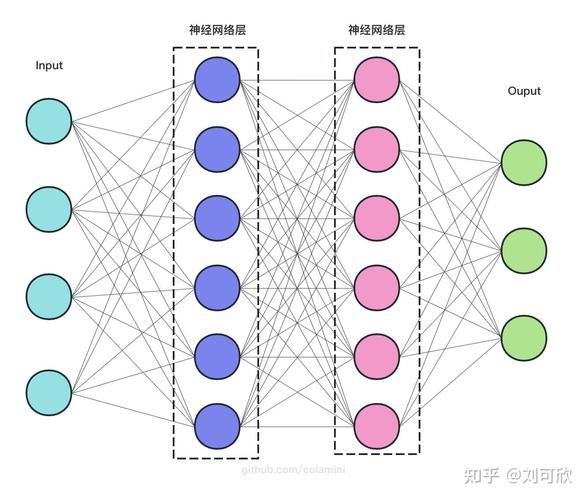
也不对。现在很多研究都在做可解释性,哪怕是复杂的图像模型,拆开来就能看到:第一层网络只认边缘线条,第二层认纹理形状,第三层才会认具体的物体。每一步在做什么,工程师都能看得清清楚楚,不是完全瞎蒙出来的结果。当然大模型确实复杂很多,但也不是完全摸不透的黑箱。
第三个误区,深度学习马上就要把人的工作全取代了。
拉倒吧。它能取代的,都是那些重复套规则、不需要主观判断的活儿,比如把纸质发票信息录入系统,这种重复活交给它干确实比人快还准。但要你去和客户谈需求,要你给产品做决策,要你感知用户的情绪,这些它学不来。
说实话,我见过太多拿着深度学习的名头割韭菜的,什么阿猫阿狗做个产品都要套个深度学习的壳子,圈融资骗投资人,其实内核还是十年前的老算法。这种事见多了,反而觉得真正踏实做应用的人,都不会把深度学习这五个字天天挂在嘴边,把活做好就行,用户不需要知道背后用了什么技术。
藏在未来里的小趋势
现在整个行业都挤破头往大模型方向冲,参数越做越大,烧的钱越来越多。不过话说回来,我反而觉得轻量的端侧深度学习接下来会越来越普及。什么意思?就是不用把你的数据传到云端服务器算,模型直接跑在你自己的手机里,你拍照修图、刷脸解锁,所有计算都在本地完成,既快,又不用担心隐私泄露。
现在新出的手机芯片,都专门给深度学习做了加速单元,以后越来越多的功能都会放到本地来,不用连网就能用,体验会好太多。
你有没有发现,真正改变生活的技术,从来都不是站在聚光灯下天天被人吹的?深度学习火到现在,最有用的应用反而都藏在你看不见的地方:你过高速的ETC自动抬杆,你快递的地址识别,你短视频平台给你推的内容,全都是它默默在干活。
它不会突然就变成统治世界的超级AI,也不会一下子就把所有工作都抢了。它就是一步一步,慢慢渗进你生活的每个角落,帮你省点时间,帮你多省点力气,就够了。
对吧?
作者|科技
排版|科技
审核|柚子