 大讲堂
凌晨两点,机房的空调还在嗡嗡响。屏幕上一个聊天框慢慢吐字:南京明天可能有雨。你盯着它,心里冒出一个很土的问题——它怎么知道的?
它没查天气接口。至少这一刻没有。它只是在做一件事:根据你给的前文,猜下一个词。猜完,再把猜出来的词塞回去,继续猜。听着有点笨,对吧?可大模型算法真正吓人的地方,就藏在这种笨办法里。
它不是在“查资料”,更像在开一场层层叠叠的会
先把大模型算法拆成两个土问题:文字怎么进来,关系怎么算出来。
文字进来先被切成 token。不是字,也不完全是词。中文里可能一个词被切成几块,英文里一个长单词也会被剁开。每个 token 变成一个向量,也就是一串数字。这串数字不是随便给的,是训练出来的。位置也要编码,不然“狗咬人”和“人咬狗”在模型眼里可能差不多。
接下来是 Transformer 里的自注意力。名字听着唬人。你可以想成一场会:每个 token 都拿着三个东西——查询、键、值。它拿自己的查询去问所有 token 的键:我该关注谁?算出一堆权重。然后按权重把大家的值捞回来,混成自己的新表示。注意力不是理解,它是让不同位置的信息互相打折、加权、混合。
多头注意力呢?就是同时开好几场会。有的头盯语法,有的头盯指代,有的头可能盯一些人类不太说得清的模式。你非要说它像人脑,那也过了。它更像很多个矩阵在工作,矩阵里全是数。
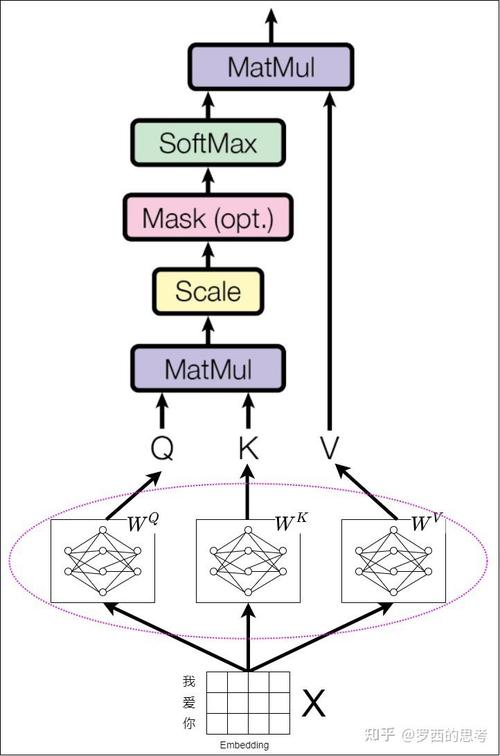
说实话,第一次看到 QKV 那套公式,我也觉得像线性代数老师喝多了。但代码跑起来,它确实能把上下文里的关系揉进向量。神奇吗?有点。神秘吗?倒也没有。
训练阶段:在海量文本里做填空,填着填着就“像”了
预训练做的事,可以粗暴理解成:给模型看半句话,让它猜下一个 token。猜错就改参数。改多少?靠反向传播和梯度。这个过程重复到天荒地老。参数从随机数,慢慢变成一种压缩过的语言统计结构。
别误会,它不是在硬盘里存了一本百科全书。它把规律压进权重里。权重是数字,很多很多数字。你问它一个冷门事实,它可能答对,也可能一本正经地胡扯。为什么?因为它的目标不是“求真”,而是“像下一个词”。
后来有了微调。监督微调,让人写一些问答示范。再往后,人类反馈强化学习,简称 RLHF。人类给回答打分,模型学着往高分方向偏。OpenAI 在 InstructGPT 论文里把这条路讲得比较清楚,时间是 2022 年。再后来 DPO 之类的方法也出来了,省掉一些强化学习的麻烦。
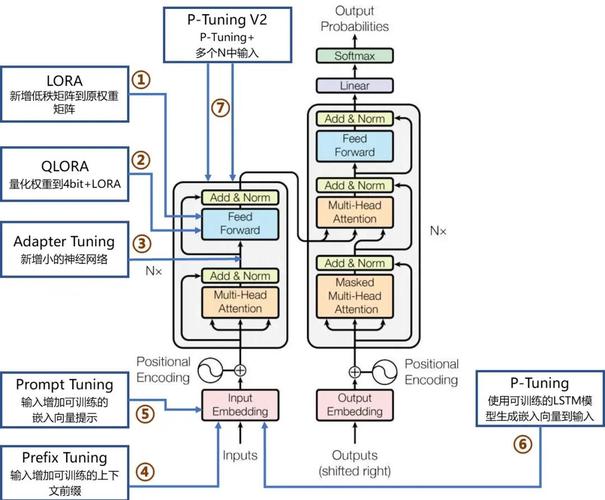
这里有个误区:很多人以为对齐就是给模型装道德芯片。没那么简单。它更像用偏好数据去拧模型的输出分布。拧得好,它更听话。拧不好,它会学会说漂亮话。哎,是的,漂亮话也是数据里的一种模式。
推理时,它为什么能一句接一句,还带点“思考感”

推理阶段,模型每生成一个 token,就要算一遍。为了不重复算前面的东西,工程上会用 KV cache。你可以把它想成草稿纸。前面算过的键和值先存着,后面接着用。可草稿纸很吃显存。上下文越长,草稿纸越厚。显存一炸,服务就抖。
采样策略也在影响你看到的东西。温度低,输出更稳;温度高,更飘。top-p、top-k 这些方法,是在候选词里砍一刀再抽签。同一个问题问两遍,答案不一样,往往不是模型坏了,是随机采样在起作用。
还有量化。把权重从高精度压成低精度,省显存,省带宽。代价是可能掉一点质量。MoE 呢,混合专家。每次只激活一部分参数,像一家大公司只叫几个部门开会。听起来很美,工程复杂度也真不低。
所以大模型算法不是单一招式。它是一串取舍。注意力头数、层数、隐藏维度、并行策略、批大小、缓存管理……每个选择都在拿成本换效果。
几个常被问糊涂的问题,我试着不绕弯
问:它真的理解语言吗?
看你怎么定义理解。它能抓住大量统计关系,能做指代消解、风格迁移、代码补全。但它没有身体,没有连续记忆,也没有人类那种“我经历过”的感受。说它完全不懂,也不公平。说它像人一样懂,那多半是投射。
问:为什么它会幻觉?
因为它在生成很可能的续写,不是在数据库里查真值。训练数据有噪声,目标函数也不惩罚“自信地错”。加上采样随机性,幻觉就冒出来了。检索增强能缓解,但没法根治。
问:大模型算法会取代程序员吗?
会改工作流。写样板、查 API、生成测试,它挺能干。可系统设计、需求取舍、线上排障,还是得有人兜底。工具越强,人的判断越值钱。这话听着像鸡汤,但你真带过项目就懂。
时间线往前拱,但别把它看成一条直线
2017 年,Google 那篇《Attention Is All You Need》把 Transformer 推到台前。2018 年,BERT 和 GPT 分别往理解与生成两条路走。2020 年,GPT-3 论文展示了少样本学习。2022 年,InstructGPT 和 ChatGPT 让普通人开始用对话摸模型。2023 年,开源模型和 LoRA 微调把门槛往下拉了一截。2024 年往后,长上下文、多模态、MoE、端侧推理,全在挤着往前走。
但这不是一条平滑直线。中间有泡沫,有回撤,有工程上的脏活。论文里的漂亮曲线,落到机房里就是电费、散热、调度和报错。
冷思考一句:大模型算法不是魔法,也不是骗局。它是一台会续写的压缩机器。你给它前文,它给你概率上顺滑的后文。人类要做的,是给它边界、给它工具、给它可核验的数据。不然,它就会用很流利的语气,说出很离谱的话。
凌晨两点半,聊天框又吐出一句:需要我帮你整理成表格吗?我笑了笑。它不知道我困了。它只是在猜,我接下来可能想要什么。
作者|科技
排版|科技
审核|安然