 大讲堂
凌晨一点,你搜“某演员的配偶还演过什么”。搜索引擎没丢给你十条蓝链接。它先弹出一张卡片。照片、名字、作品、生日。点一下,跳到另一个人。再点,又跳到一部电影。你大概会愣一下:它怎么知道这些?
答案藏在一个不太像答案的词里——知识图谱。听起来像学术黑话。其实你可以把它想成一张巨大的关系网。节点是人、地点、电影、公司、疾病、零件。边是“出演”“位于”“收购”“导致”“属于”。
它不像表格,更像一墙图钉和毛线
传统数据库爱把东西塞进表。一行一行。列是字段。可现实里的关系会拐弯。张三认识李四。李四在南京工作。南京有家研究所。研究所参与了一个芯片项目。芯片项目又被某公司投资。你用表去查,得 JOIN 好几次。图数据库里,这就是沿着边走。
知识图谱的底层表达,常被拆成三元组。主语—谓语—宾语。比如“南京—位于—江苏”,“江苏—属于—中国”。再加属性。人口、面积、成立时间。也加限定。谁在什么时候担任什么职位。别小看时间。忽略时间,图谱就会把十年前的 CEO 和今天的 CEO 混在一起。
RDF 是一种经典写法。属性图是另一种。Neo4j、JanusGraph 这类系统把节点和边当一等公民。它们不是要把整个维基百科抄一遍。它们要的是可计算的关系。关系能查,能推,能拼。
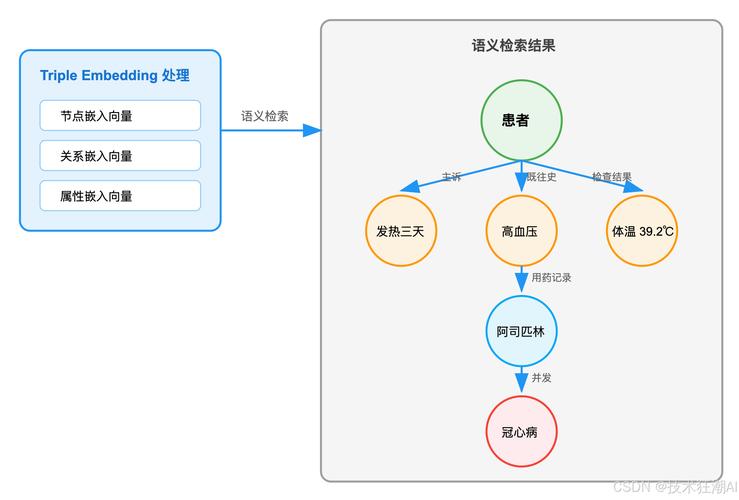
不过,图不是画出来就完了。实体得有身份。关系得有方向。同名的人怎么办?两个“李娜”可能是运动员,也可能是歌手。两个“苹果”,一个是水果,一个是公司。图谱得先做实体消歧,再做实体链接。把文本里的“苹果”连到正确节点上。
搜索引擎怎么把“苹果”认成水果还是公司
你搜“苹果”。如果附近词是“iPhone”“库克”“市值”,它多半往公司走。如果附近词是“维生素”“果园”“派”,它往水果走。这不是读心术。是上下文、共现、点击行为、结构化数据一起投票。
Google 在 2012 年推出 Knowledge Graph。这件事常被拿来讲搜索的转折。之前搜索引擎主要匹配关键词。之后它试着理解实体。你搜一个名人,右侧出现知识面板。你搜一家公司,出现总部、创始人、母公司。面板里的信息不是凭空冒出来的。背后有维基数据、DBpedia、Schema.org 标记、合作数据源。也有大量清洗和融合。
实体融合很麻烦。A 数据源说某人出生在南京。B 数据源说出生在江苏。不矛盾。C 数据源写了个旧名字。D 数据源把另一个人混进来。图谱的质量,往往死在这些脏活上。

再往下走,还有本体。本体听起来玄。其实像一套分类约定。人是一个类。演员是人下面的类。电影是另一个类。演员出演电影,这条关系合法。演员出演城市,就不太对。本体给图谱装上骨架。可骨架太细,也会压死人。现实变化快。今天的新职业,明天的新关系。本体得留缝。
大模型来了,图谱是不是过时了
有人问:现在大模型什么都能聊,还费劲建图谱干嘛?
这话对了一半。大模型擅长语言。它能把一段话写得像人。可它也会一本正经地胡说。你问它某个公司的创始人,它可能给你一个不存在的人名。你问它药物相互作用,它可能编出危险答案。图谱不擅长聊天。但它擅长把事实和关系摆出来。谁和谁相连。通过哪条路径相连。
所以现在常见一种搭配:大模型负责理解和表达,知识图谱负责约束和溯源。检索增强生成,也就是 RAG,常从文档里找片段。图谱增强那一派,会先从图里找相关子图。把实体、关系、路径一起塞给模型。模型再组织成人话。多跳问题尤其明显。“某演员的配偶的导演合作过谁?”这种问题,向量相似度容易飘。图上的路径反而清楚。
但别急着神化。图谱构建贵。维护更贵。数据会腐烂。实体合并错了,错误会沿着边传播。你今天把两个公司合并成一个,明天财报、新闻、股权全乱。时间版本没管好,查询结果会穿越。权限没设计好,一张图可能泄露不该连起来的关系。
还有个冷思考:不是每个业务都需要知识图谱。如果你只有几百条数据,关系也简单。Excel 加外键,或者一张宽表,可能更省事。图谱适合关系复杂、需要多跳、需要解释、需要把不同来源拼起来的场景。比如风控里的团伙识别。比如医疗里的症状、药物、基因、文献。比如工业里的设备、零件、故障、工单。比如内容平台里的用户、兴趣、作者、话题。
判断标准可以很土:你要回答的问题,需不需要沿着关系走三步以上?如果需要,图谱值得考虑。如果一步就查完,别折腾。先问清楚:数据从哪来?关系会变吗?谁来维护?查询要解释吗?答不上来,先别画图。
跟一个做图谱的朋友聊了十分钟

我问:知识图谱和向量数据库啥关系?
他回:一个管相似,一个管关系。向量库像“闻起来像”。图谱像“谁连着谁”。
我问:那 GraphRAG 呢?
他回:先用图找相关子图,再让模型读。省 token,也少胡扯。但图找错了,后面全错。
我问:普通人用得着懂吗?
他笑:你每次看搜索右侧卡片、看电商推荐、看反诈提醒,都在用。只是它躲在后台。
我问:它会消失吗?
他顿了一下:不会。但会变得更像水电。没人天天聊,可很多系统离不开。
我问:怎么开始?
他说:找一个小场景。先做实体和关系。别贪大。别一上来就设计全宇宙本体。先让一个具体问题跑通。
我问:怎么评估?
他说:看问答准不准。看路径能不能解释。看更新麻不麻烦。看错误能不能追到源头。
聊完我有个感觉。知识图谱像一张城市地图。地图不是城市。地图会旧。修路、改名字、开店、封路,地图得跟着动。图谱也一样。它得有人养。得有人清。得有人盯着那些看起来无聊的边。
下次你在搜索框里敲下一个名字,右边弹出一张卡片。你可以停半秒。想想那根看不见的毛线。它从这个人,连到那部电影,连到一座城市,连到另一家公司。知识图谱没让机器突然开悟。它只是把关系,提前缝好了。
作者|科技
排版|科技
审核|白杨