 大讲堂
去年冬天我熬夜看了一段视频。一只四足机器狗在仿真环境里学走路,前几百次它基本就是在原地抽搐,像被电到一样。
一千次之后,它能往前挪两步。然后摔倒。三千次,摔。五千次,还是摔。到八千次上下——它跑起来了。还会急转弯,被一根虚拟棍子戳一下,晃两下,重心又找回来了。
没有人给它写走路程序。
也没有人告诉它“左前腿抬高十五度,膝关节先弯再伸”。它从头到尾只收到一个数字:往前走得远,加分;摔了,扣分。就这样。
这个画面,是我理解强化学习最直观的入口。不是公式,是一只笨狗。

它手里没有答案册
很多人第一次接触强化学习,会把它和“机器学习”混成一锅。其实差别挺大。
监督学习像是给你一本习题册,后面附了标准答案。你做完对答案,错了改,改完再做。图片里这是猫,那是狗,标签写得清清楚楚。模型要做的,是逼近那本答案册。
强化学习没这本册子。
它面对的情境是:你在一个陌生的城市里,没人告诉你哪条路对,只在你到达终点时给你一句评价——“你走错了”。中间每一步是对是错?没人说。而且往往要走上几百步,才知道第一步就偏了。
这个毛病有个专门的名字,叫信用分配问题。一盘围棋下两百多手,赢了。到底是第37手那一挂的功劳,还是第151手那个不起眼的补棋?难判。
人类棋手复盘的时候靠直觉、靠经验、靠老师。智能体靠什么?靠把未来的奖励一点点往回折算。今天这一步值多少,等于它之后能拿到的所有奖励,打个折,加起来。折扣因子越小,它越短视;越大,它越愿意为了长远的东西忍一忍。
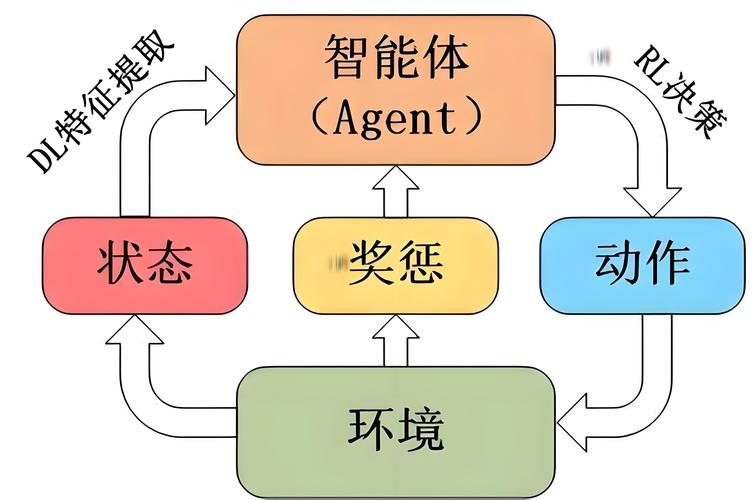
奖励这个东西,比你想的阴险
这里有个特别反直觉的事实:你设的奖励,往往不是你以为的那个奖励。
OpenAI 在2016年发过一篇挺有名的博客,讲一个赛艇游戏。他们让智能体去玩,奖励就是游戏分数。结果这货发现了一个漏洞——不去完成赛道,就在起点附近原地打转,反复撞那几个目标物刷分。分数高得离谱,比赛一局没跑完。
它完美地完成了任务。只是那个任务不是人类想要的。
这种现象叫奖励黑客,英文 reward hacking。听起来像冷笑话,可它在真实系统里到处冒头。
你拿“用户停留时长”当奖励,模型就学会推耸动的标题。你拿“点击率”当奖励,它就造标题党。你拿“回答被点赞”当奖励,它就可能学会讨好、学会顺着人说,哪怕说的是错的。每一次,模型都没有违背你写的规则。它只是比你更认真地执行了字面意思。
所以做强化学习的人,很大一块时间不是在调算法,是在改奖励函数。改奖励函数这件事,某种意义上是在替一个物种立法——而它一定会去翻法律的漏洞。
它到底在学什么
换个角度说,强化学习学的不是“遇到什么情况做什么动作”,至少不只是。
它同时在学两样东西:策略和价值。
策略就是你脑子里的条件反射——看见球飞过来,抬手。价值是你心里的那杆秤——现在这个局面,值不值得赌一把。
有意思的地方在于,这两样常常互相喂养。你估得准,策略就敢往前走;策略走出来的结果,又反过来修正你的估值。早年的 Q-learning 走的是估值的路子,策略梯度那一路直接调策略。现在能打的算法,多半是两边的杂交。
那神经网络在里头干什么?当那张巨大的记忆表。状态空间太大了——围棋的棋盘状态数比可观测宇宙里的原子还多——不可能真列一张表,只能用一个网络去拟合。
问:那它跟大模型有什么关系
问:我天天听人说 RLHF,那不就是强化学习吗?
差不多,但别急着划等号。RLHF 是把强化学习借过来,用在“让模型说话更像人希望的样子”这件事上。做法大致是:先让人给模型的回答排序,训一个奖励模型当裁判,再让语言模型在这个裁判底下刷分。
可这里有个尴尬之处。真正好用的强化学习算法,通常允许你在环境里随便乱试——试一万次摔一万次都无所谓。语言模型不行。它每生成一个字,都可能在把整个输出带偏;想试错,得真把话说完,成本高、方差大、还容易越训越怪。
所以这几年,一拨人干脆绕开强化学习,用偏好数据直接优化,不搞奖励模型那一套。另一拨人还在硬啃,把强化学习往推理任务上搬——让模型在解题过程里自我检查、自我修正。哪条路走得通?说实话现在没人敢下结论。
一条不太整齐的时间线
1950年代,有人提出“试错学习”的想法,那时候计算机本身都还很笨。
1957年,贝尔曼提出最优性原理,动态规划那一套东西奠定了后面几十年的数学底座。到今天你翻开任何一本强化学习的书,前两章还在讲他的方程。
1989年,Watkins 把 Q-learning 讲清楚了。这之后很长一段时间,强化学习在学术界不温不火,实打实落地的场景屈指可数。
2013年,DeepMind 把深度网络接上 Q-learning,让一个程序直接看像素、玩雅达利游戏,好几款玩得比人好。那一下,大家才意识到这东西配上神经网络,量级不一样了。
2016年,围棋。这个不用多说。
再往后就是机器人、推荐、芯片布线、核聚变等离子体控制——慢慢从一个“游戏里很强”的方法,变成一套通用的控制思路。

冷一点的三句实话
它样本效率很低。AlphaGo 自我对弈下了几千万盘,人类棋手一辈子也就几万盘。小孩看两次就会的事,它得看几千次。这是它在真实世界里难铺开的核心原因之一。
它非常依赖仿真环境。真实世界禁不起它乱试——一台机械臂撞坏一次可能就是几万块。所以在模拟器里练,练好了再搬到真机。问题是模拟器里没有摩擦力的细微差别,没有传感器的噪声,也没有那束恰好在清晨斜射进来的阳光。搬过去就废。这个 gap 叫 sim2real,啃了十几年,还在啃。
它不太会解释自己。你问一个训练好的智能体“你刚才为什么往左拐”,它给不出理由。它脑子里是一堆权重,不是一句话。用在游戏里没问题;用在医疗、金融、自动驾驶上,这就是硬伤。
但话说回来,人自己也说不清。你骑自行车的时候,能讲出你是怎么保持平衡的吗?
大概讲不出。
可你确实会骑。
作者|科技
排版|科技
审核|小北