 大讲堂
晚上九点,新街口地铁口。风把梧桐絮吹得人直眯眼。我拎着一袋盐水鸭,手机相册突然弹出一行字:已为你整理“美食”。我愣了一下。它怎么知道我拍的是吃的?我又没打标签。旁边朋友笑,说这背后有深度学习。哦,又是这个词。听上去像某种内功心法,其实拆开看,没那么玄。
但也没那么简单。真的。
它不是在“理解”,更像在拧一堆旋钮
你给机器看一百万张鸭子照片,它不会突然悟出“鸭子是一种禽类”。它做的事,更像调音台上几百个旋钮。像素进来,经过一层层加权、求和、激活,输出一个分数:这是盐水鸭的概率 0.91,是烤鸭的概率 0.07,是塑料袋的概率 0.02。分数错了,就反向传播,把旋钮拧一点点。拧几百万次。嗯,听起来笨。可笨办法堆到一定规模,效果就有点吓人。

关键在参数。一个深度网络动辄几千万、几十亿个参数。每个参数都是一个小旋钮。训练就是找一组旋钮位置,让预测错误变小。数学上叫梯度下降。你可以把它想成蒙眼下山,每一步用脚探一下哪个方向更陡。只不过这座山有几亿维。人脑没法想象,代码可以。
那“深度”呢?别被它唬住。深度指的是层数多。浅层网络可能只有一两层,深度网络堆了很多层。层多了,能拼出更复杂的特征。比如识别猫:浅层看到边缘,中间层看到耳朵轮廓,深层看到“猫脸”组合。可这不等于它懂猫。它只是把像素和标签之间的统计关系,压进了一堆数字里。
为什么它有时神,有时蠢?
你肯定遇到过:人脸识别在白天挺灵,晚上戴个帽子就翻车。语音助手在安静房间能听懂,到了南京公交车上就装死。别急着骂它弱智。它只是没在那种场景里学过。深度学习有个脾气:训练数据长什么样,它就偏向什么。你喂它晴天街景,它默认世界永远阳光灿烂。你喂它精修人像,它看到原相机照片就蒙。
这里有个词,过拟合。模型把训练集背得滚瓜烂熟,连噪声都记住了。换一套题,完蛋。像什么?像考前只刷一套模拟卷,连答案顺序都背了。真到考场,题目换个问法,脑子空白。
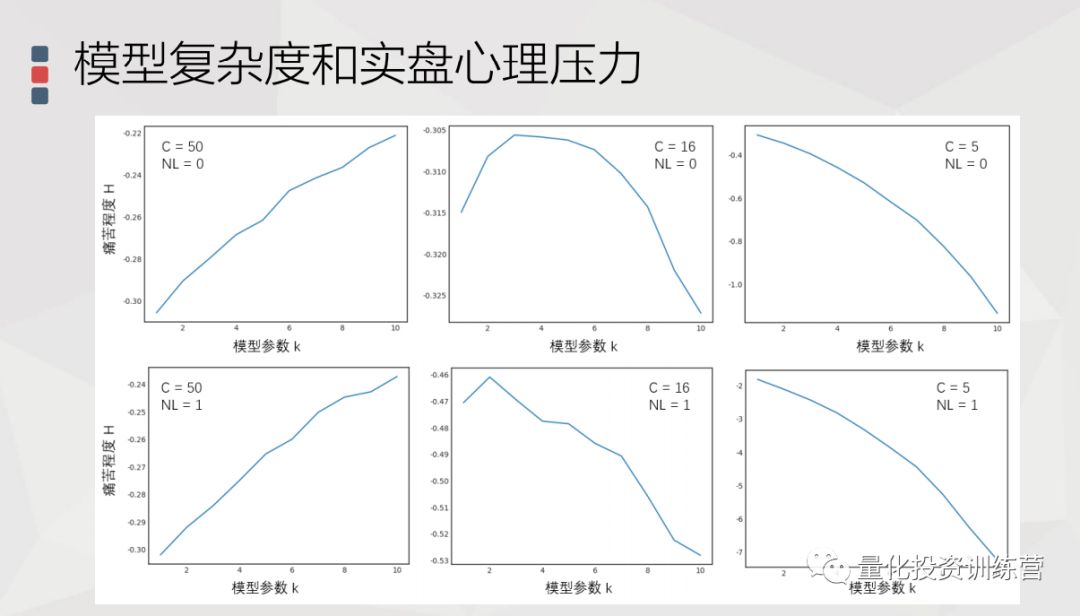
另一个坑:分布偏移。训练时数据来自A场景,上线后用户来自B场景。比如训练用的大多是年轻人自拍,结果小区门禁遇到老人、小孩、戴口罩的人,识别率就往下掉。这不是算法突然变坏。是世界变了,而模型没跟上。
说实话,很多AI新闻里的“翻车”,根子不在神经网络有多深,而在数据有多偏。可大家爱聊模型架构,不爱聊数据清洗。数据清洗多无聊啊。但它是真功夫。
别把深度学习当成“电子大脑”
有些宣传喜欢说:AI理解了你的情绪。AI读懂了你的意图。听着很带劲。可你拆开看,往往还是模式匹配。它能在文本里找到“难过”和“失眠”的统计关联,未必知道你凌晨三点发朋友圈时那种空落落。它可以生成一段像模像样的安慰,但它没有经历。没有经历,就谈不上真正的共情。
当然,我不是说它没用。恰恰相反。深度学习的强项是在模糊、高维、非结构化的数据里找规律。图像、语音、文本,这些规则很难手写。传统程序写if-else,写到头发掉光也写不完。深度学习换了个路子:不写规则,给例子,让它自己调旋钮。于是语音识别、机器翻译、图像生成,一路推进。
不过话说回来,它也很脆弱。你给图片加一层肉眼看不见的噪声,它可能把熊猫认成长臂猿。你换个提问方式,它可能给出完全相反的建议。所以别把它当先知。它更像一个超级实习生。干活快,记忆力惊人,但会自信地胡说八道。你得盯着。
一个外行也能用的判断法
听到“深度学习”四个字,别急着跪。问三件事。它训练时见过什么数据?它在哪些场景里失败过?错了以后谁负责?这三个问题,比看PPT上的网络结构图有用。
如果对方说“我们的模型很先进”,你可以点点头,然后问:有失败案例吗? 真正做过项目的人,通常会给你讲一堆坑。数据标注错漏、长尾样本太少、上线后漂移、算力成本压不住。这些不酷,但真实。
还有,别把深度学习和大模型画等号。大模型是深度学习里的一种路线,偏重 Transformer 那套。深度学习还有卷积网络、循环网络、图神经网络等等。就像南京小吃不止盐水鸭,还有鸭血粉丝、皮肚面、小笼包。你不能拿一种味道代表整条街。
那它接下来会怎样?
我不敢乱预测。真的。技术圈的风向,变得比南京春天还快。昨天还在聊卷积,今天全在聊注意力。明天呢?可能是世界模型,可能是别的。但有些东西不太会变:数据质量、算力成本、场景边界、人的判断。这些老问题,不会因为模型多几层就消失。
我倒是希望,以后大家聊深度学习,少一点“颠覆”,多一点“这玩意儿在什么条件下管用”。少一点“机器觉醒”,多一点“数据从哪来,偏差怎么查”。这不浪漫。可技术落地,本来就带着机油味。
回到新街口那袋盐水鸭。相册把它归进“美食”,大概率是因为照片里有油亮的鸭皮、塑料袋的反光、手拎的姿势,这些像素组合在训练数据里经常和“食物”一起出现。它不知道香不香。它只知道,这样一堆像素,很像。
这就够了。对很多任务来说,够用。对另一些任务来说,远远不够。知道这个边界,比盲目崇拜或者一味恐惧,都更实在。
作者|科技
排版|科技
审核|知知