本来谈的合作很简单:药店这边有近一年来慢病患者的购药记录,社区卫生服务中心有对应的上门随访血压、血糖数据,两边把数据凑一块,就能算出不同种类的降压药、降糖药在真实生活里的控压效果,给后续的慢病管理方案做参考。
谁都不敢先动。
毕竟患者信息是有严格监管要求的,万一数据出了泄露问题,不管是药店还是社区,都得担责。之前也想过找第三方平台来托管数据,结果问了一圈,光等保测评、数据安全审计的流程就得走小半年,算下来成本高到根本划不来。
先把你脑子里的”数据算账”印象掰过来
我们从小到大对”算账”的认知,其实都是从班级凑班费来的。要算全班一共凑了多少钱,就得每个人把兜里的零钱掏出来,堆在教室前面的桌子上,班长挨个数完记在本子上。
这套逻辑放到互联网时代,就是传统的数据协作模式:不管是企业还是机构,只要想跨主体联合算个结果,就得把各自手里的原始数据,全部搬到同一个中心化的平台上,集中存储、集中计算。

问题也恰恰出在这。
数据搬到中心平台的那一刻,数据的持有方就失去了对自己数据的掌控权。万一平台的防护出了漏洞,万一内部员工把数据导出去卖了,原始数据一旦泄露,根本没有挽回的余地。就像你把兜里的钱掏出来堆在桌上,哪怕班长再靠谱,也架不住旁边路过的人顺手牵羊。
隐私计算干的事,从根上就把这套逻辑换了。
根本不用你把钱掏出来。
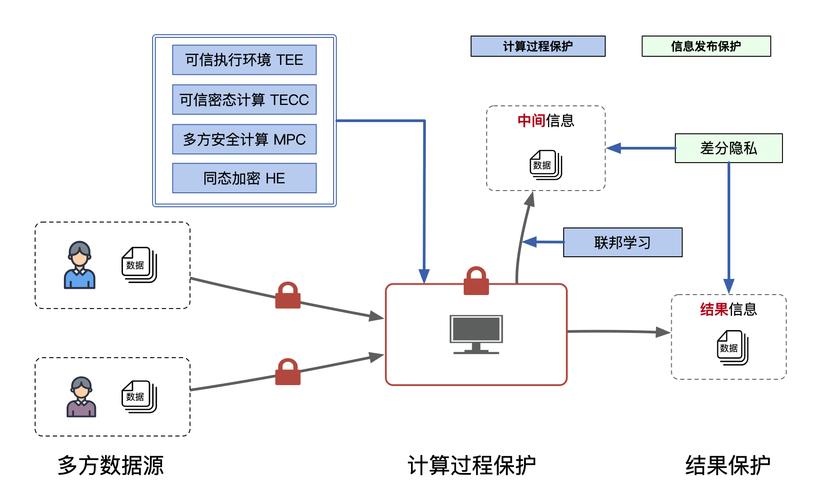
大家还是围坐在桌子边,每个人坐在自己的位置上,把自己手里的计算环节跑完,最后只把计算出来的中间结果传出去,拼起来就是最终想要的答案。全程没人知道别人兜里具体有多少零钱,甚至连中间结果单独拿出来,都拼不成任何有实际意义的个人信息。
说白了,不需要把原始数据集中到同一个平台,只需要把计算的流程拆成碎片,分到每一个持有数据的节点上跑,最后凑出正确结果。
那些被吹上天的概念,其实一半是误区
刚接触这个领域的时候,我也被各种发布会的话术绕晕过。
有人说隐私计算就是把数据加密了存在本地,谁都拿不走。
错。
加密存储这东西,早在十几年前的数据库领域就普及了。就像你把日记本锁在抽屉里,锁得再严实,哪天你要数一下日记本里一共写了多少字,还是得把日记本掏出来翻开逐页数,那把锁根本帮不上忙。隐私计算的核心从来不是”锁数据”,是让数据不用离开自己的服务器,就能参与到跨机构的计算流程里。
还有人吹得更玄,说上了隐私计算,就等于给数据上了全险,百分百不会出现泄露问题。
真的。
说这话的人估计连差分隐私的基本参数都没调明白。我之前跟一个做隐私计算的工程师吃饭,他说最烦客户一上来就问”你们这个技术是不是绝对安全”,每次他都得跟人解释,没有绝对的安全,就像你家里装了防盗门,也架不住有人拿万能钥匙开,无非是你把锁的等级提得高一点,让偷东西的成本高到划不来而已。之前看某高校的公开测试案例,研究团队用常规的联邦学习框架训练用户消费偏好模型,结果攻击者只要对着模型提几个针对性的问题,就能反推出某个特定用户上个月的具体消费记录。这不是技术本身的问题,是落地的时候偷工减料——为了让模型的计算精度高一点,把防护层的噪声参数拉得特别低,就像你给家门装了智能锁,结果密码设成123456,最后被人撬了锁,总不能怪锁的设计不好。
别神化,也别把它当没用的玩具
上个月陪之前那个开药店的老板,去看他们跟社区合作的隐私计算部署现场。
本来以为会看到堆得老高的加密硬盘、穿白大褂的技术人员围着复杂的机柜调试,结果就两台普通的机架式服务器,分别放在药店的机房和社区卫生服务中心的机房里,跑的程序占的内存,还没他店里的收银系统大。
整个流程跑通之后,两边的技术人员把最终的统计结果导出来——不同降压药的半年控压有效率、不同年龄段患者的用药依从性数据,整整齐齐列成了一张表。从始至终,没有任何一方导出过完整的患者姓名、身份证号、家庭住址这些敏感信息。
他当时站在机房门口愣了半天,跟我嘀咕,说之前担心了大半年的合规问题,居然就这么悄没声解决了。
不过话说回来,这东西真不是万能的。
比如你要是想靠隐私计算算清楚”哪个小区的独居老人数量最多”,这本身就是个越界的需求。哪怕技术的防护层做得再严密,只要你能算出这个精确到小区的结果,就存在把具体住户信息定位出来的风险。这就不是技术能兜住的事,是需求本身就踩了隐私保护的红线。
现在很多厂商总喜欢把隐私计算吹成什么”下一代数字经济的核心底座”,其实哪有那么宏大。
说白了就是解决了一个最朴素的矛盾:我手里有数据,你手里有数据,我们俩想一起算个对双方都有用的结果,但谁都不想把自己手里的数据交出去。
就这么简单。
没有什么改变世界的叙事,就是帮大家把之前卡在合规环节、卡在安全顾虑里的事,顺顺当当做了。
作者|科技
排版|科技
审核|阿辰