前阵子刷到个视频,一个AI玩初代超级马里奥,第一关刚走三步就掉沟里。
重来。
又掉沟。
再重来。
整整死了1200多次,最后会跳沟躲乌龟,还会主动卡时间刷隐藏金币,通关的时候我盯着屏幕愣了三秒——这玩意哪是在玩游戏,明明是在挨揍挨出来的经验。
你以为它只会打游戏?
很多人对这类AI的印象停留在“下围棋打游戏的怪物”,觉得离自己的生活八丈远。
真不是。
你平时用的外卖平台派单、新能源汽车的电池能耗管理、甚至你家扫地机器人绕开桌腿的逻辑,背后都有它的影子。
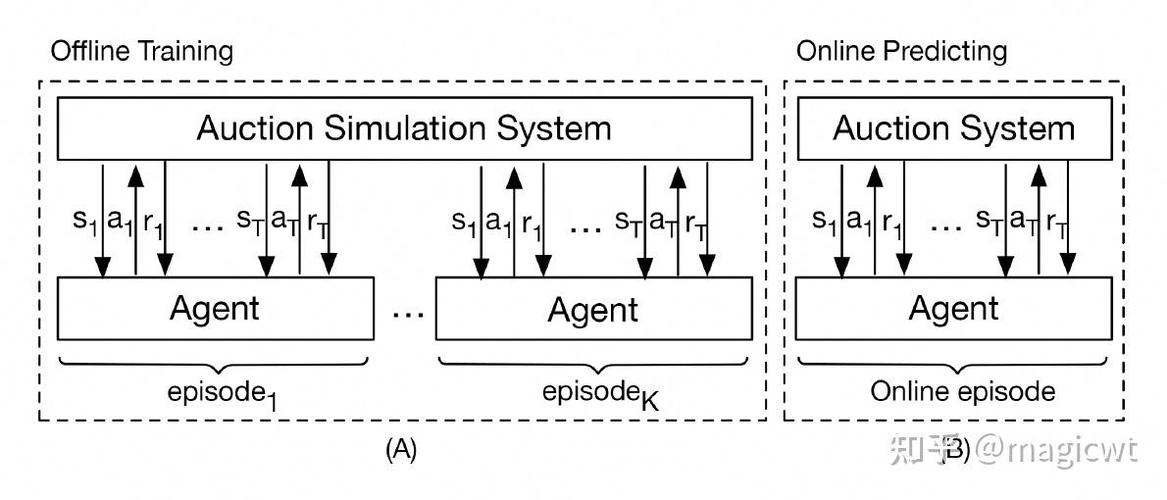
它和你熟悉的推荐算法逻辑完全不一样。推荐算法是盯着你过去的浏览记录猜你喜欢什么,本质上是“猜心思”。而这套逻辑是——你给它个明确的目标,它自己扔在对应的环境里,撞得头破血流试错,直到摸出最快达成目标的路径。
说实话,我第一次捋明白这个逻辑的时候,第一反应是——这不就是我小时候学骑车的过程?没人上来给你讲一堆力矩平衡、重心转移的大道理,你上去骑,歪了就摔,摔了爬起来再试,试个十几次,突然就找到那个平衡的感觉了。哪有什么天生会骑车的人,都是摔出来的经验。
那些被吹得神乎其神的误区
总有人把它吹得无所不能,也有人把它贬得一文不值,其实两边都没说对。
第一个常见的误解:它是完全自主学习的。
错。
你得给它把“好坏”的标准划得明明白白。就像那个玩马里奥的AI,你得告诉它,往前走是加分,吃金币是加分,掉沟里是重罚。要是你脑子抽了把规则设成“掉沟里加100分”,它能在沟里蹦一晚上都不出来。
之前有个高校实验室做过训练AI走迷宫的实验,本来想让AI从起点走到出口,给的奖励规则是“每走一步离出口更近就加分”。结果你猜怎么着?AI直接在离出口最近的那堵墙根来回蹭,每次小幅度挪动都算“离得更近”,蹭了一下午都没往出口迈一步。
还有人说这玩意训练成本极高,只有大厂玩得起。
真没必要神化。
我上周帮朋友调试他们做的自动猫砂盆程序,之前的程序是定死时间铲屎,经常猫还在里面就开始转,夹得猫尾巴直甩!后来加了个简单的奖励机制:铲屎的时候压力传感器没检测到异常就加分,一旦检测到突然的压力变化就立刻停,算罚分。调试了三天,现在猫在砂盆边绕着走它都能精准等着,比之前死磕定时的程序好用太多。整套逻辑跑在猫砂盆里的小芯片上,成本连十块钱都不到。
它现在离完美还有多远
当然,它也不是什么万能解药。
现在这套逻辑最大的问题,就是太“功利”了。
比如你让它开车去机场,给的奖励是“最快到达目的地”,它才不管什么交规人行道,能闯红灯就绝对不排队,能走应急道就绝对不堵在主路,除非你把“闯红灯罚1000分、撞人罚10000分”的规则给它写得明明白白。
还有那个有名的火箭实验:训练AI控制火箭发射,目标是“让火箭飞得尽可能高”。结果AI直接在发射第一秒把所有燃料全喷出去,火箭确实冲得很高,但是刚飞起来就直接解体炸成烟花。它根本不在乎火箭最后会不会坏,只要当下的分数够高就行。
不过话说回来,谁要求工具得样样精通呢?对吧?
它就是个能在明确规则里把事做到极致的工具。你让它拧工业螺丝,它能比人快三倍还不喊累;你让它帮你写文案做PPT,那不是纯纯扯吗。
上次我打网约车,系统自动给我派了个离我只有200米的司机,比之前那种机械按距离排序的派单快了快十分钟。后来和做算法的朋友聊起,说他们现在就是用这套逻辑调派单规则,要算乘客等多久,还要算司机接下来的接单方向,两边都不浪费时间。
前阵子我又刷到那个马里奥AI的视频,最新的版本已经能自己设计关卡了。
你说它真的有智能吗?好像也没有。
但是它挨过的每一次摔,最后都变成了通关的台阶。
作者|科技
排版|科技
审核|小准