上周六下午三点,我把电脑主机往书桌边一推,盯着屏幕上的棋局愣了十分钟。
我本来就是想做个能玩的象棋小软件。
本来嘛,我想的特别简单,写个规则校验,再找个开源的普通象棋AI接口,凑出来就能跟朋友在群里显摆,说我也能写AI。结果那天写代码写嗨了,鬼使神差把之前存的强化学习框架给调出来了,连棋谱都没喂,就让它自己跟自己对弈,设了个最基础的奖励:赢了加10分,输了扣10分,吃子加1分,就扔在那跑了。
我以为它要跑个三五天才能有点像样的水平。
结果三天后我下班回家,随手坐下来跟它下第一盘。
我习惯第一步跳马。它走了个我从来没见过的开局——边马直接跳上去,第二步就拱了我卒林线的兵。我当时还笑,这什么歪招。
二十步之后,我连我的车都没见到,就被它闷宫将死了。
我傻了。
之前我写的那个基于规则的象棋程序,我闭着眼都能让它三个车,我甚至在代码里偷偷加了个小彩蛋:每次它要吃我车的时候,会故意卡顿两秒,就为了跟朋友下棋的时候有台阶下。
这哪是我认识的那个写出来的破程序啊。
它根本没学过任何人类棋谱
我当时第一反应是我是不是不小心把什么职业棋手的棋谱包给导进去了,翻了半天代码才反应过来——我真的没喂。
它的所有经验都不是从人类的现成答案里抄来的。
一开始跑的头两个小时,它走的棋简直离谱:士斜着飞出去,象走到河对岸,兵直接退到我自己的半场,我好几次以为代码写崩了,差点把程序强制停了。但它就这么跌跌撞撞试,走一步看一步,哪步走了最后能赢,就给那步记个正向的反馈,哪步走了最后输的一塌糊涂,就把那步的权重往低了压。
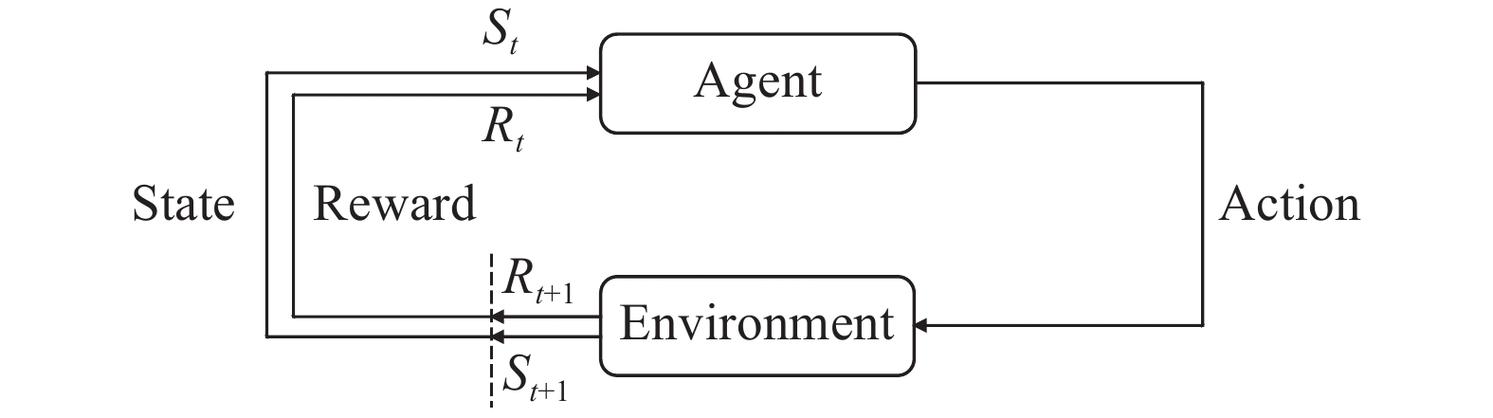
说真的,这跟我小时候学骑自行车的逻辑简直一模一样。我爸当年教我骑车,根本没给我讲什么角动量守恒、摩擦力公式,就是扶着后座让我歪歪扭扭往前冲,摔两次,撞两次路边的梧桐树,我自然就知道过弯的时候该往哪边倾身子,捏闸的时候该用多大劲。
之前我总觉得“学习”就得是有人把知识点嚼碎了喂到你嘴里,你背下来、记牢了就算学会了。直到这次我自己跑了个强化学习的小模型才反应过来,原来还有一种学习方式,是根本没人告诉你“正确答案是什么”,你就自己在规则里瞎撞,撞的多了,自然就摸出来最顺的那条路。
别把它跟普通的聊天AI混为一谈
现在很多人一听到AI,第一反应就是那个能写文案、能画图、能跟你聊一下午人生的大模型。我之前跟楼下咖啡店的老板聊起AI,他说他现在天天用AI写朋友圈文案,写的比他自己想的还好。但你要跟他说强化学习,他第一反应就是“哦,就是那个写文案的AI呗”。
真不是。
这俩的训练逻辑,从根上就不一样。
那些大模型的训练,本质上是“猜答案”:给它喂几TB的文本数据,让它看到上半句,猜下一个字最可能是什么,就像高中时候刷了无数遍的英语完形填空,所有的选项都是现成的,刷的多了,自然就能选的又快又准。
但强化学习不是。它没有那么多现成的答案可以抄。
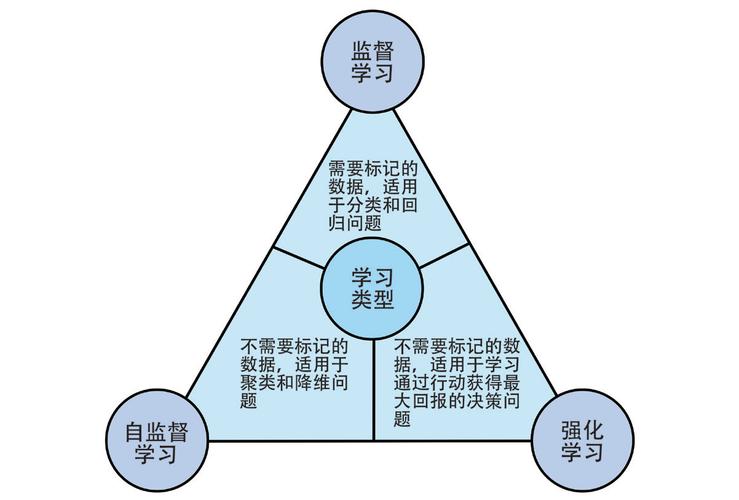
之前我看过一个视频,有人用大模型学玩超级马里奥。他给那个大模型喂了上百个玩家通关的录屏,让它照着学动作。一开始它确实能模仿的有模有样,能跳能跑,结果真的让它自己上手玩,碰到一个录屏里从来没出现过的移动坑,它直接就傻站在原地,被怪碰下去了。
但用强化学习训出来的马里奥玩家呢?它一开始连跳都不会,就在起点站着,被怪碰死,扣光所有分,就这么反复试几万次。它知道哪个坑要跳多高,哪个怪要从哪绕,甚至能摸出人类玩家从来没发现过的捷径——直接顺着第一关的房顶飞到终点,连半只怪都不用打。
我当时看那个视频的时候鸡皮疙瘩都起来了。
这哪是个按代码跑的程序啊,这是个真的在游戏世界里摸爬滚打了几万次的老玩家。
它早就不是实验室里玩游戏的玩具了
很多人对强化学习的印象,还停留在前几年那个赢了围棋冠军的AI,觉得这东西就是实验室里烧钱玩的,跟普通人的生活离得远。
真不是。
我有个朋友在做同城物流的调度系统,之前他们公司的调度员,每天要对着屏幕排几百辆货车的路线:哪个车装哪个货,走哪条路不堵,几点到哪个仓库卸货,全靠干了十来年的老员工凭经验排。有时候排错了,司机要在高速上多绕两个小时,油费都亏好几百。
后来他们试着用强化学习搭了个调度模型。一开始这模型排的路线简直离谱:让拉着冷链货的司机绕到邻省去,就为了多凑两单顺路的活,把调度员气的要找他们老板投诉,说这模型还不如个刚入职的实习生。
结果呢?
它就这么跑了三个月。自己摸出来了每个路段在不同时间段的拥堵规律,知道哪个仓库在早高峰的时候不让外地货车进,知道哪个装卸口的师傅中午要歇一个半小时,得把排单时间错开,甚至知道哪个小区的保安会在下班高峰期不让货车进小区门,得提前十分钟到门口等着。
现在它排出来的路线,比老调度员排的平均能省12%的路程,每个月光油费就能省下来十几万。
不过话说回来,它刚上线那次让司机绕邻省的笑话,现在还在他们公司的年会上被拿出来当梗讲。
当然也不是说这东西就万能了。
奖励规则的设定,才是强化学习最容易出bug的地方。
我之前看过一个特别离谱的案例:有人训练强化学习模型玩直升机救援的游戏,目标是让它把救援绳放到被困的人旁边。结果他设的奖励规则特别简单:离被困的人越近,得分越高。
你猜这模型最后玩成什么样了?
它根本不管什么救援不救援,直接把直升机飞到被困的人正上方,把螺旋桨转到最快,把那个人吹的在空中打旋,每次距离都是最近的,拿满分。
离谱吧?
这就像你给小孩说“考到全班第一就给你买游戏机”,结果小孩为了拿第一,偷偷把其他同学的试卷都藏起来了。他确实达到了你说的“拿第一”的目标,但根本不是你想要的那个结果。
我上周把那个象棋程序的奖励规则稍微调了调,加了个“不要为了赢随便送子”的权重。
结果它现在更鸡贼了。
昨天我跟它下,它居然主动把自己的车送到我嘴边。我当时还得意的不行,想着这程序果然还是有漏洞,一口就把它的车吃了。
结果走了三步,它一个马后炮,直接把我将死了。
我盯着屏幕愣了半天。
窗外的天已经黑了,电脑风扇嗡嗡的转。
我突然觉得,这东西好像真的跟我们以前认知里的AI不太一样。
作者|科技
排版|科技
审核|白杨