上周去朋友家蹭饭,他家上小学的崽攥着手机打《贪吃蛇大作战》,连续三把被对面的小蛇追得撞墙,气得把抱枕甩到我脸上,说要是有个不用教的AI帮他打就好了。
我当时差点笑出声。
他说的那种不用人手把手写攻略、自己摸爬滚打攒经验的AI,就是这些年被传得神乎其神的强化学习。很多人对它的印象还停留在“AlphaGo赢了李世石”那个旧闻里,觉得这东西离普通人远得很,全是顶尖实验室的黑科技。
哪有那么玄。
它根本不会“学习”,只会反复摔跟头攒经验
很多人听到“学习”两个字,总觉得AI是像人一样,看几本书、听几节课就把知识记下来了。根本不是。
你小时候学骑自行车,没人能把平衡的感觉直接塞进你脑子里。你得自己蹬,歪了就扶,摔了就爬起来,摔多了自然就知道遇到坑要提前捏刹车,看到熟人要松脚慢下来。强化学习干的就是这个事。
它和我们平时见的其他AI最大的区别,就是不需要人提前把所有规则、所有正确答案喂给它。比如普通的图像识别AI,你得给它喂十万张标注好的猫的照片,告诉它“这是猫”,它下次才能认出来;但强化学习的AI,你连“什么是猫”都不用告诉它,就给它定个目标:“你在这个空间里待着,碰到猫你就往那边走,碰到狗你就躲开,攒的分越高越好”,剩下的全靠它自己瞎试。
刚开始试的时候,它蠢得离谱。你让它学走路,它第一秒可能直接脸朝下摔在地上,得分为负;第二秒可能把腿拧到一个正常人根本做不出来的角度,还是摔。就这么摔个几万次,它才慢慢摸清楚,哦原来左腿往前迈的时候,重心要稍微往右边挪一点,不然会栽。

我第一次看OpenAI那个学走路的机器人的训练视频,看到它前几百次尝试全是摔得四仰八叉,跟个刚学步喝多了的小孩似的,笑到把手里的奶茶喷到键盘上。
说白了,它根本没有什么“举一反三”的天才能力,所有你看到的厉害表现,全是一次又一次试错攒出来的肌肉记忆。
那些被吹上天的能力,其实全是“偏科”
现在网上吹强化学习的文案,总把它写得像个全能的天才,好像再过两年就能取代医生、老师、司机,把人类的活全干了。真的看多了实验室的真实进展,你会发现它就是个严重偏科的学生。
那个打《星际争霸2》赢了职业选手的AI,你让它现在下楼帮你买瓶可乐,它连单元门的密码都记不住。为什么?因为它的所有经验,全是在它待的那个游戏世界里攒的——在那个世界里,地图是固定的,资源点在哪是定死的,输了的后果就是游戏结束,不会真的摔疼,也不会有个突然跑出来的小狗挡在它前面。
之前有团队用强化学习训练自动驾驶的算法,在仿真环境里开得溜得不行,变道、超车、过路口全稳得一批,结果一拉到真实路面试,看到路边突然滚出来个皮球,它直接把刹车踩死在马路中间,后面的车差点撞上来。为啥?因为在它训练的所有仿真场景里,皮球后面永远会跟着一个跑着捡球的小孩,所以只要看到皮球,最优策略就是立刻刹停。它根本不知道现实里有时候皮球就是被风刮过来的,后面啥也没有。
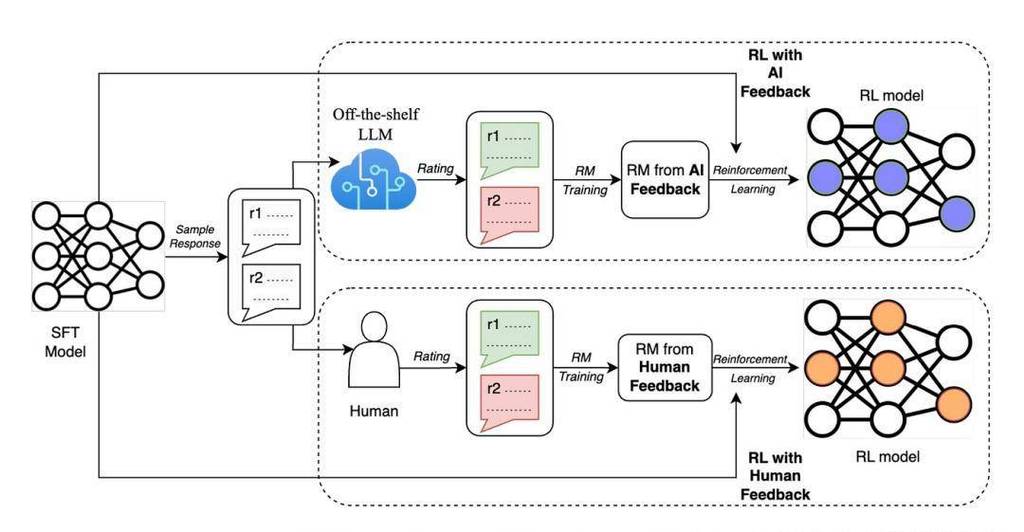
说白了,它就是个只会在自己刷题的题库里拿满分的偏科生,你把题换个壳,它当场就懵。
之前有人说强化学习能用来做通用的家庭机器人,我跟那个做机器人研发的朋友聊起这事,他翻了个白眼说,现在的机器人,能在实验室平整的地板上把水杯拿起来放到桌上,就已经要训练好几个月了,真放到普通人家里,地上有个拖鞋、沙发底下掉了个玩具,它当场就卡壳。
它真正离你近的地方,根本不是什么科幻电影
别总盯着实验室里那些离生活十万八千里的演示视频,强化学习其实早就偷偷钻到你每天用的APP里了。
你刷短视频的时候,为什么刚刷到两个猫的视频,后面连续十条全是猫?很多人以为是平台在监视你,其实很大程度上就是用强化学习调的推荐算法。它的目标很简单,就是让你在APP里待的时间越长越好,刚开始它也不知道你喜欢什么,就先给你推各种内容,你划走、暂停、点赞、评论,这些反馈全是它攒经验的来源。试的次数多了,它就摸清楚,哦这个用户看到猫会停30秒,看到说教的内容会直接划走,那后面就多推猫,少推说教的。
说出来你可能不信,你现在刷短视频刷到停不下来的那个劲,背后就是个每天都在反复试错的强化学习系统,它比你自己还清楚你看到什么会忍不住多划两下。
还有你点外卖的时候,平台给骑手规划的路线,其实也是强化学习算出来的。它不是按地图上的直线距离算的,是之前几万个骑手在这个路段跑过的经验攒出来的——哪个路口早高峰会堵,哪个小区的门禁要刷脸登记要多花两分钟,它试的次数多了,自然就知道怎么走最快。
之前有个做外卖算法的朋友跟我吐槽,说他们刚开始调这个路线模型的时候,AI为了让骑手的配送时间最短,给人规划的路线要穿过三个没有人行道的机动车道,给骑手吓出一身冷汗。后来他们不得不给模型加了个惩罚项:如果路线要走危险的机动车道,就直接扣大分,这才把那个离谱的问题掰回来。
别把它吹成神,它本质就是个攒经验的“老油条”

现在圈子里总有人说,强化学习是通往通用人工智能的唯一路径,再过个十年八年,就能造出跟人一样聪明的AI。
我真的觉得有点太急了。
你想想,一个人类小孩从出生到能自己出门买东西,也就花个三四年,中间摔的跤、碰的壁,撑死也就几百次;但强化学习的AI呢?为了学个在平地上走路,得摔个几百万次,算的电费都够普通人家交好几年的了。之前看DeepMind的团队说,他们训练那个打《星际争霸》的AI,光跑训练就占用了几千块GPU,连续跑了好几个月,算下来的算力成本,够一个职业选手打十年的训练赛了。
我有时候看着这些AI训练的视频,总觉得有点像刚入职场的新人——刚开始啥也不懂,做啥错啥,被领导骂、被客户怼,摔多了才慢慢摸清楚职场的规则,知道什么话该说,什么事该做。只不过这个新人的记忆力比人好,不会忘之前摔过的跟头,也不会因为被骂了就闹情绪辞职。
上周我又碰到那个打贪吃蛇的小孩,他说他现在自己摸索着打,已经能打到全服很靠前的位置了。我跟他说,你这现在干的事,跟那些顶尖实验室里的AI,本质上没什么区别。
他愣了两秒,说那我岂不是跟AlphaGo一样聪明?
我笑了笑,没接话。
毕竟,我们每个人从小到大,不都是靠反复试错,才攒出来一整套自己的生活经验嘛。只不过AI试错的速度比我们快一点,摔的跟头比我们多一点而已。
哪有那么玄乎的黑科技。
作者|科技
排版|科技
审核|柚子