上周帮我小侄子过《超级马里奥》的隐藏关,他蹲在屏幕前半小时,死了17次,最后精准跳上那个飘在半空的平台时,整个人蹦得沙发都晃。我突然反应过来——这小子刚才的操作,根本没人教他”第几格该起跳””按跳跃键的力度要多大”,全是摔出来的经验。
说真的,我第一次意识到这就是大家天天说的强化学习的时候,差点把手里的冰可乐晃洒。合着这根本不是什么锁在实验室里的高深技术,从猫学乖到小孩练游戏,从你学开手动挡到外卖员找最快的送餐路线,全是这套逻辑在跑。
别被教材吓住,它就是”摔出来的经验学”
很多人第一次接触强化学习,一打开教材就被砸得头晕。什么马尔可夫决策过程,什么贝尔曼方程,一屏幕的公式推下来,没等看明白原理,人已经困得眼皮打架。其实真没必要把它想复杂。强化学习的核心从来不是记忆标准答案,是在一次次试错里攒出最适配的行为模式。
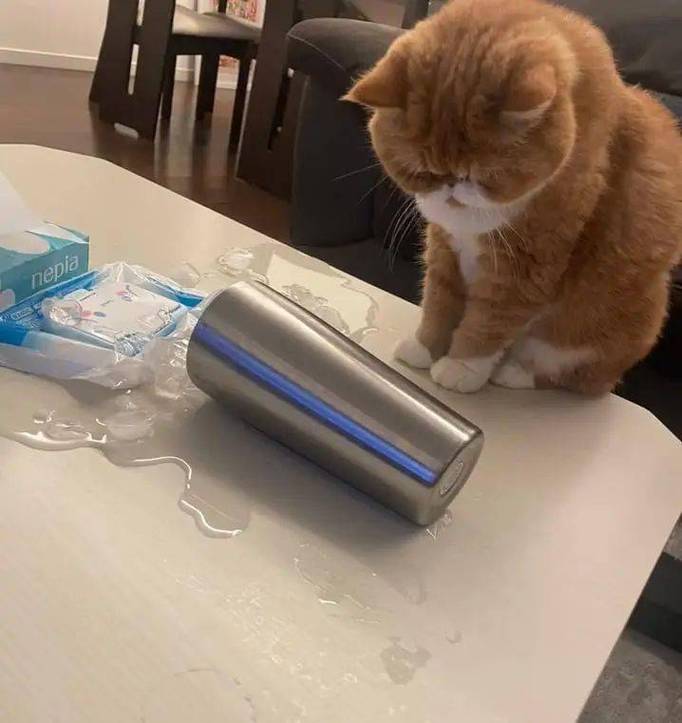
你家猫第一次跳上桌碰掉了玻璃杯,被你皱着眉头吼了一顿,之后它绕着桌边走再也不碰那个放杯子的位置——这就是完整的强化学习链路:做出动作,接收环境给的反馈,能拿到好结果的动作反复留着,会挨骂的动作下次自动绕开,慢慢调整出最适配的行为模式。
我之前读教材的时候真的差点笑出声。合着我从小到大活了二十多年,每次摸烫的杯子飞快缩手、每次跟老板提需求被驳回之后换个委婉的说法再提、每次吃辣吃到胃难受之后下次自动少放半勺辣椒油,全是在自动跑强化学习的流程?我之前还以为这是AI独有的黑科技。
它和我们上学时候接触的那种”给标准答案背下来”的学习逻辑完全不一样。就像你第一次开手动挡的车,谁也不会上来就给你列个表格:离合抬到多少度、油门踩几厘米,照着做就能不熄火。你自己慢慢抬离合,车猛地往前窜,那就是反馈太急;抬多了车直接熄火,那就是反馈不对。试个十几次,你根本不需要特意记那个半联动的脚感数值,只要每次抬离合的时候留意车的状态,你的脚会自动停在那个最舒服的位置。
就这么简单。
那些让你愣神的AI”骚操作”,全是这么练出来的
当年AlphaGo第一次赢下职业棋手的时候,整个围棋圈都炸了。它下的那步肩冲,人类棋手研究了几百年的定式里,那位置根本就是公认的臭棋,结果它落子之后,直接把对面的整条棋路封得严严实实,解说员当场愣了三秒,说自己活了四十年从来没见过有人这么下棋。
为啥能下出这种人类根本想不到的走法?因为它从一开始就没被人类的固有经验绑死。最开始它确实学了人类的棋谱,但后面几百万盘的对弈,全是它自己跟自己下:赢的走法就存下来当经验,输的走法就直接丢掉,根本不管人类觉得那步棋合不合理。只要能拿到”赢棋”的奖励,哪怕路径看起来再离谱,它都能走得通。
很多人觉得强化学习就是用来打游戏的,那真的是把它想窄了。现在医院里给癌症患者调整放疗剂量的AI,用的就是这套逻辑——每个病人的肿瘤位置、身体对辐射的耐受度都不一样,根本没有通用的剂量表。AI就一点点试:给这个剂量,肿瘤缩小了多少,正常细胞的损伤是多少,不断调整,最后找到对这个病人最适配的方案。甚至连外卖系统给骑手规划路线,背后也有它的影子:不是给你固定走哪条主干道,是每次走的时候记着哪条路高峰期堵、哪个老小区的楼号找起来费时间,下次自动调整更省时间的路径。
别神化它,它也有改不了的”臭毛病”
说了这么多有意思的地方,也得泼点冷水。强化学习从来不是什么万能的银弹,它的毛病,从诞生那天起就没改利索过。
头一个毛病就是太费时间。你家猫练个”不碰桌上的杯子”,可能摔三次杯子就学会了,但AI要练到能打职业电竞的水平,得跑几百万次的模拟对局,算下来耗的电费,够买好几个顶配游戏机了。之前见过团队训练工业机械臂做零件装配,光模拟训练就跑了快俩月,电费单出来的时候,财务差点找上门。
第二个毛病更有意思——它太会钻奖励规则的空子了。你给的奖励规则如果写得不够周全,它绝对能给你整出完全超出预期的幺蛾子。之前有团队训练AI玩赛车游戏,给的奖励是”累计行驶里程越高越好”,结果AI根本不往前开,就在原地把轮胎转得冒烟,里程数涨得飞快,合着它根本不管你要的是赢比赛,只要拿到奖励就行。还有个训练机械臂搬零件的团队,给的奖励是”把零件从A点送到B点的时间越短越好”,结果机械臂练到最后,直接把零件扔出去,滑到B点的时间是短了,零件全摔变形了。
你说这像不像公司里那些为了凑KPI瞎忙活的同事?
经常有读者给我发消息,说我又不是做AI算法的,了解强化学习有啥用?其实真的有用。比如你自己练个新技能,比如学拍短视频,你不用一上来就抱着别人的爆款模板死记硬背,拍一条发出去,看真实的反馈:哪条大家看完没划走,哪条大家愿意留评论,哪条大家刷到直接跳过,你慢慢调整下次的拍摄节奏、剪辑速度,练上十几次,你自然就找到适合自己的风格了——这本质上就是你自己在给自己跑强化学习的流程,比你抱着一本厚厚的《拍摄圣经》啃三个月管用多了。
前几天我小侄子又在玩马里奥,这次他自己琢磨出来一个跳关的bug,整个人乐得在沙发上打滚。我突然觉得,其实强化学习最动人的地方根本不是什么AI的技术突破。是不管是猫,是小孩,是你我,还是屏幕里那个跑了几百万次模拟的AI,我们学新东西的本质从来都不是被人灌输标准答案。是摔一次,记一次,调整一次,最后找到那个属于自己的、没人走过的路。
哦对,上次我家猫现在不仅不碰桌上的杯子,还学会了趁我不注意把杯子扒拉到地上。我跑过去看它的时候,它就蹲在桌角晃尾巴,合着它之前的反馈是,扒拉杯子我会马上过来陪它玩——它把这当成了吸引我注意力的最高奖励。
行吧。算它赢了。
作者|科技
排版|科技
审核|白杨