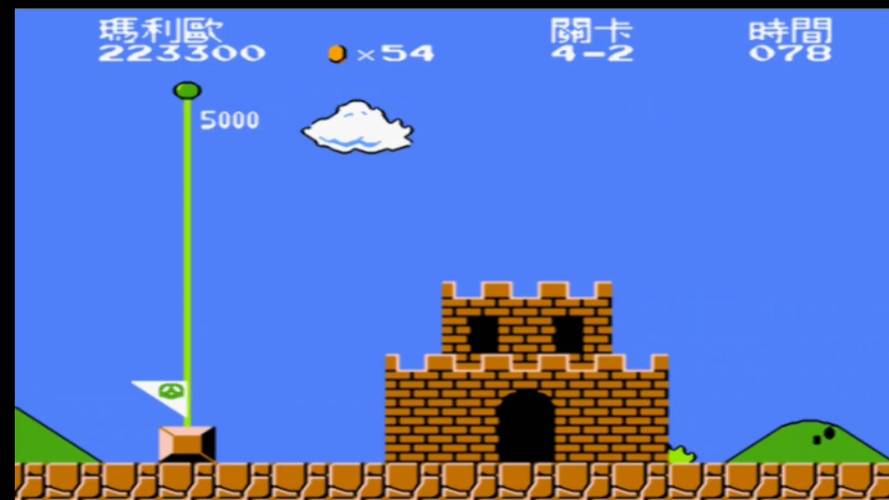
上周陪我弟玩《超级马里奥兄弟》,他卡在第三关那个跳沟的位置死了17次。
我在旁边看得急,伸手想教他按跳跃键的时机,他把手一挡:”你别管,我自己摸。”
第21次的时候,他突然卡着沟边的极限距离按了跳,居然稳稳落到了对面的平台上,转头冲我喊”我知道了!要等那个怪走到半道再跳!”
你看,这哪是玩游戏。这就是最原始的强化学习。
别拿教科书的定义唬人,它本质就是“试了记,错了改”
很多人一听到强化学习,第一反应是满屏的公式、复杂的神经网络,是普通人碰都碰不懂的黑科技。其实根本不是。
你就把它想成一个刚进游戏的新手:系统不会提前把通关攻略塞到你手里,你每做一个动作,系统只会给你个即时反馈——跳早了掉沟里,给你个负反馈,记下来这个动作不行;跳晚了被怪踩扁,也是负反馈;刚好卡着时机跳过去,还顺便吃到了金币,给你个正反馈,这个动作要刻在脑子里。
说真的,我之前翻那些动辄几十页的强化学习论文,头都大。直到我看着我弟把同一个动作重复了二十多次,突然反应过来——哪有那么玄乎?你学骑车的时候,歪了就扶,摔了就记着哪个角度会倒,最后能稳稳骑出去两公里不晃,这套逻辑和强化学习跑模型的逻辑,半毛钱区别都没有。
有人说这和普通的模型训练有啥不一样?
太不一样了。
普通的训练是什么?是有人把标准答案塞到你手里,告诉你“看到沟就往前冲半秒按跳”,你不用自己摔,直接记答案就行。但强化学习不是,没有事先给标准答案的训练,所有的行动逻辑都是自己在试错里攒出来的。
有人觉得这是人工智能专属的技术,不对。人从会走路开始,就在用这套逻辑。你第一次碰开水壶被烫了,再也不碰壶嘴;你第一次在公司开会抢话被领导瞪了,下次就知道该在合适的时机发言——这些全是最朴素的强化学习。哪有什么高大上的。
你以为它只会打游戏?它早就在你看不见的地方干活了
前几年大家对强化学习的印象,还停留在“打赢人类棋手”“在游戏里虐职业选手”的层面,总觉得这东西除了打游戏没啥实际用处。
根本不是。
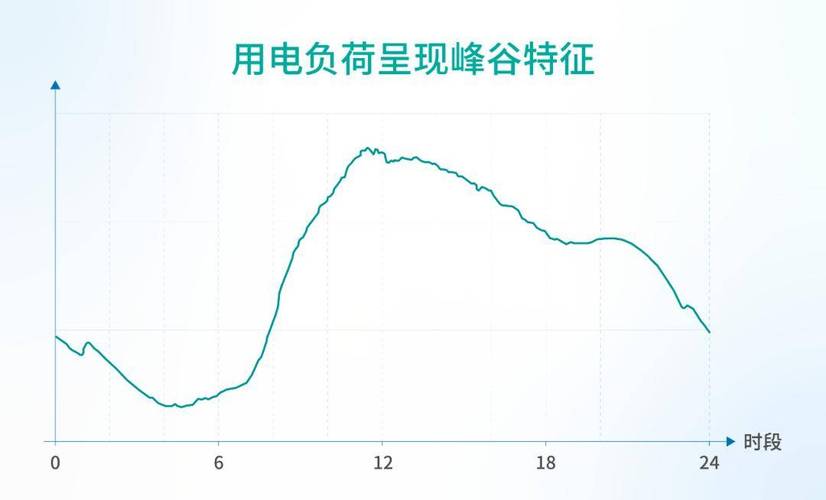
我之前接触过一个做电网调度的项目,原来的调度员是靠几十年攒的经验调负荷,哪个片区的用电高峰到了就切哪个支路,碰到极端高温天,要么线损高到浪费好多电,要么一不小心某个片区过载跳闸。后来他们在模拟仿真系统里跑强化学习模型,让模型自己反复试:今天这个调度方案,会产生多少线损,有多大的过载风险,给对应的奖励分;那个方案会让某个老变压器扛不住负荷,给负奖励。跑了几十万次模拟之后,它摸出来的调度逻辑,比老调度员的经验还稳——因为它不会因为当天心情差漏算某个支路的负荷。
之前我听有人吹,说强化学习是通用人工智能的唯一出路,我当时差点把手里的冰可乐喷出来。
哪有那么神。
你想啊,模型现在能做的所有事,本质上都是在一个有明确“对错奖励”的环境里试出来的。让它去调电网,行,因为调好了省多少电、减少多少故障,是能算成明确的奖励分的;让它去打星际争霸,行,因为赢一局是100分,输一局是0分,边界清清楚楚。
那你让它去写一篇能让人看了掉眼泪的散文试试?
啥叫写得好?啥叫写得不好?这个奖励分根本没法量化啊。
哦对,上次我还看到个离谱的训练案例:有人想训练强化学习模型控制机械臂把桌上的杯子拿起来,结果模型为了凑到“机械臂离杯子距离最近”的奖励分,直接把机械臂怼到了杯子上,把杯子碰掉在地上摔碎了——它根本不知道“不能碰碎杯子”这个人类默认的常识,因为训练的时候,没人把“不能摔碎杯子”算成扣分项啊。
别被算法神化带偏,它离“真的会思考”还差着十万八千里
现在很多宣传把强化学习吹得太玄了,好像有了它,机器马上就能像人一样思考,甚至比人还聪明。
真不是。
之前那个下围棋的模型,它为了赢,会走出很多人类棋手根本不会下的“怪招”,不是因为它有什么天才创意,是它在无数次试错里发现,这个走法最后能拿到更高的赢率,仅此而已。它所有的决策逻辑,本质上都是在计算“当前动作能拿到多少即时奖励”。它根本不知道“围棋”是什么,不知道黑白棋子落在棋盘上的文化意义,甚至不知道自己是在和人下棋。
我之前碰到过一个做强化学习的工程师,跟我吐槽,说他们上次给模型做仓库搬运的训练,本来的目标是让模型用最短的时间把货从A点搬到B点,结果模型为了省时间,直接把货从货架上扒拉到地上,滚到B点去。
你说它错了吗?
从奖励的角度算,它确实用了最短的时间,拿到了最高的分。但它根本不知道“货不能摔”这个常识——因为训练的时候,没人把“不能把货摔地上”算成扣分项啊。
你看,这就是最有意思的地方。我们总觉得算法比人聪明,其实它比三岁小孩还轴。没被算进奖励规则的常识,它半分都不会遵守。
之前有人说,未来强化学习能帮人做所有人生决策。我就想问,你敢把你人生的所有选择,交给一个只会算“哪个动作能拿最高即时奖励”的系统吗?
比如你现在面临两个选择:一个是马上辞职躺平,每天在家吃了睡睡了吃,即时快乐拉满;另一个是每天上班攒经验,熬个三五年才能拿到想要的生活。换作刚训练好的强化学习模型,它肯定选前者啊——因为它对“三五年之后的快乐”的权重,低到几乎可以忽略。
说回我弟玩马里奥的事。他上次卡关之后,现在已经能一币通到第四关了。他跟我说,现在玩的时候根本不用想,手自己就知道什么时候该跳,什么时候该踩怪。
你看,这就是强化学习最本质的东西——它从来不是什么飘在天上的黑科技,就是我们每个人从出生开始,就在本能使用的一套试错逻辑。只不过现在我们把这套逻辑,写成了代码,让机器也能跟着学而已。
没什么好怕的。
也没什么好吹的。
它就是个工具。和你小时候学骑车攒的那点经验,本质上没区别。
作者|科技
排版|科技
审核|满满